一、扩大跨芯复用优化能力:算子总量超过1400,多芯片整体算子性提升27%
FlagOS 2.2 持续扩充通用计算、推理专用与科学计算算子,发布清单覆盖 9 个算子库。其中,FlagGems 等公开算子由564个增至1454个,新增 890个。首次发布 FlagGems-SGLang,包含40个多芯片高性能算子。
新增能力面向模型中的实际计算需求:FlagGems 扩展线性代数、归约与训练反向接口;FlagGems-SGLang 覆盖 Attention、Mamba 状态更新、MoE、LoRA、采样与量化,本轮 NVIDIA 测试通过清单覆盖全部 40 个算子;FlagGems-vLLM 扩展 MLA、KDA/GLA/GDN2、TopK 与低精度计算,为推理框架提供可复用的专用算子。如下图是9大算子库在2.2版本持续扩容对比图。
图 2|算子库在 FlagOS 2.1 与 2.2 中的数量变化
1. 围绕关键计算路径,联合优化算子与编译优化执行
针对 Attention、MoE 和低精度计算,FlagOS 2.2 将算子实现与FlagTree编译器优化结合,减少数据搬运、内核启动和同步等待,并为不同输入形状选择执行路径。其中在2.2的版本上,FlagTree主分支新增AMD、进迭时空、平头哥等后端, 扩展公共编译能力的适用范围,并提供以下重要的编译与调优支撑:
优化方向 |
对模型计算的作用 |
低比特与混合精度 |
FP8/FP4 存储、在线反量化与高精度累加,减少数据搬运 |
算子融合 |
融合反量化、矩阵计算、激活与路由加权,减少中间访存和内核启动 |
按形状选择执行路径 |
针对输入形状与数据布局,选择归约、稀疏 Attention 等算子的执行策略 |
编译与自动调优 |
通过 TLE 控制布局、共享内存和异步流水;使用 FlagTune 搜索执行配置 |
表 1|关键算子的优化方向及其作用
经过持续优化,整体算子在2.2版本的到显著提升,统计了包括海光、摩尔线程、沐曦、天数智芯、昆仑芯、英伟达、平头哥、燧源、华为昇腾及AMD等10家芯片的算子加速比,在上千个算子、10 款异构 AI 芯片这一大规模基数上取得 27% 的整体提升,意味着 FlagOS 的优化能力正从单点性能突破,走向跨芯片、规模化的系统性能提升。
2. AI辅助研发:让算子开发从专家手工优化走向规模化生产
算子跨平台覆盖的挑战不只是“写出代码”,更在于正确性、性能和可维护性必须共同达标。KernelGen多芯片自动算子生成工具已经支持了九款AI芯片,通过联合编译优化、系统工具分析等能力,把代码生成、硬件验证和自动调优衔接为规模化生产能力。本季度新增生成765个算子。其中416个在至少5款国产芯片上通过精度验证,并达到对应原生算子80%以上的性能水平。不同平台还分别完成数百个算子验证,说明AI辅助生成正在与真实芯片上的质量评估结合,而不是停留在离线代码演示。
这条路径的长远价值,是让工程师将更多精力用于计算结构、性能瓶颈与架构差异,将重复生成、改写和初步调优交给工具;生成结果再经真实设备验证,沉淀为社区可以复用的实现。算子开发效率的提升,不仅服务FlagOS,也有望逐步降低各芯片厂商跟进新模型的工程门槛。
3. FlagPrism跨芯片统一调试工具:让开发者和 Agent 都能用好调优工具
前面的优化都需要回答两个问题:结果为什么不对,时间到底花在哪里?换一款芯片,如果还要重新熟悉一套调试接口和性能报告,已有的调优经验就很难复用。FlagPrism 将 Triton 源码、编译器中间表示(IR)与设备执行信息关联起来,让跨芯开发从“可运行”走向“可解释”:代码能够在不同硬件上执行之后,开发者还要能看清中间数据和执行过程,找到下一步修改的依据。
Debugger 把数值问题追到具体语句。 最终输出出现偏差时,只比较输入和输出,很难判断问题发生在哪一步。FlagPrism Debugger 可以深入 @triton.jit 内核的指定区域,采集中间数据,并关联源码与 IR。下面的演示展示了在编辑器中选择采集区域、运行内核、查看变量及其数值统计的过程;变量的数据类型、形状和中间值有了对应的代码位置,开发者便能逐步缩小排查范围,不必只对着最终结果猜原因。
视频 1 | FlagPrism Debugger 演示
Profiler 把总耗时拆开,找到值得优化的环节。 一项改动究竟减少了计算、访存还是同步等待,需要执行数据来判断。FlagPrism Profiler 采集调用上下文、时间线以及操作、访存和硬件等信息,聚合为调用树和时间线报告。演示从一个小型 MLP 的分层调用开始,进一步在时间线中展开内核内部操作,并查看操作对应的源码位置与耗时。这样,开发者既能找到耗时集中的调用,也能继续向内追查,把性能变化对应到具体执行环节,为调整数据布局、访存和执行顺序提供依据。
视频2 | FlagPrism Profiler 演示
跨芯复用的不只是优化代码,也包括这套观察和分析问题的方法。FlagPrism 已支持华为昇腾、天数智芯、摩尔线程、英伟达和燧原,更多后端正在接入;芯片厂商可以围绕共同工具接入自身的执行信息,开发者则能沿用熟悉的分析方式。对参与算子生成和调优的 Agent 而言,这同样重要:有了真实设备上的数值与性能反馈,下一轮修改才有依据。FlagPrism 与 KernelGen、编译器及测试工具配合,让代码生成、设备验证、问题定位和继续优化衔接起来,也让 FlagOS 的共享能力从代码延伸到开发过程。
当开发者、芯片厂商甚至算子生成Agent能够获得可对照的数值与性能反馈,跨芯共享的就不再只有某段优化代码,还包括一套发现问题、验证假设和持续迭代的方法。FlagGems、FlagTree、KernelGen与FlagPrism的协同,是FlagOS 2.2区别于单纯适配工程的核心技术进展。
二、复用优化进入新模型适配:统一插件与跨芯量化,Day0适配多达 12 款芯片
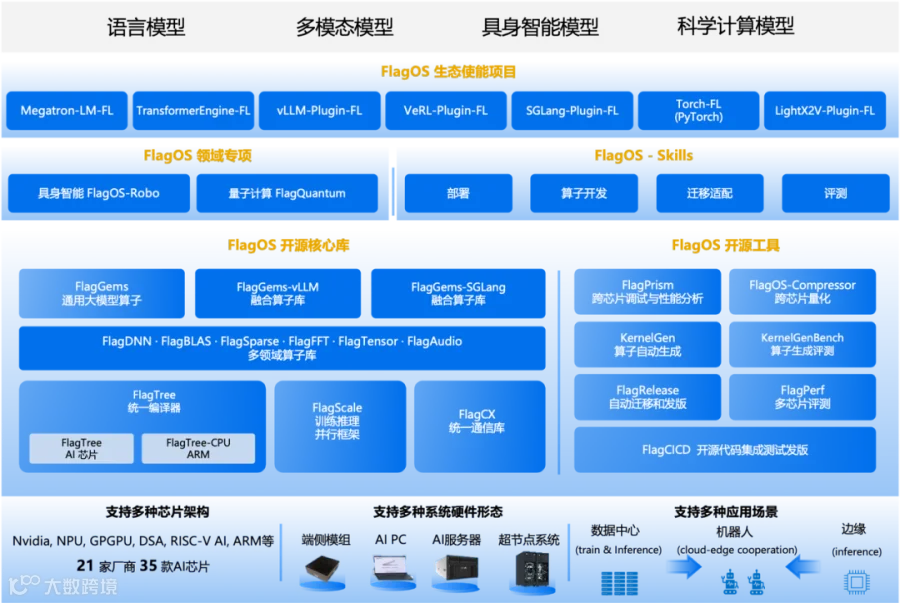
复用优化要真正进入模型,还需要解决两个问题:上层框架如何调用不同芯片的能力,模型权重和执行精度又如何适应目标设备。FlagOS 通过打造跨芯片的框架插件库,把公共算子与通信等能力接入各种训练、推理框架;FlagOS-Compressor 则提供跨芯片的权重转换与量化能力。它们再与编译、迁移、评测和发布等组件配合,将共享优化落实为开发者可以使用的模型版本。
算子与编译器的创新最终要服务模型,而模型的训练和推理依赖不同的框架。FlagOS 的统一跨芯插件系统就像一组“插座”,把多种芯片的能力接入这些框架,让开发者能够沿用熟悉的模型开发方式。2.2 进一步扩展了框架与芯片的覆盖范围,也为新模型快速进入不同硬件平台提供了基础。
表 2|各框架与组件的芯片平台适配范围
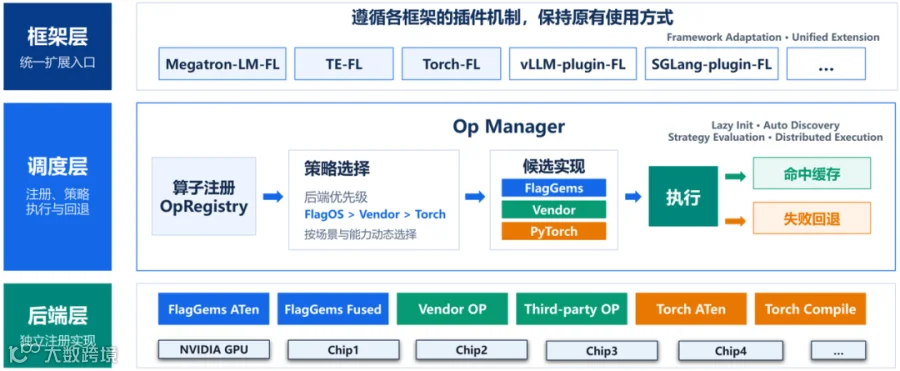
以训练组件 TransformerEngine-FL 为例,模型通过统一的算子接口发起计算,OpManager 组织算子注册,按策略选择 FlagOS、厂商或 PyTorch 实现,并提供缓存与失败回退机制。这样,模型调用与具体后端实现之间有了明确的接入位置,底层算子可以在这一层接入和替换,减少对核心训练代码的改动。这个例子说明了插件如何把已有优化交给模型使用;不同框架遵循各自的插件机制,具体实现并不完全相同。
2. FlagOS-Compressor:让权重与精度适应目标设备
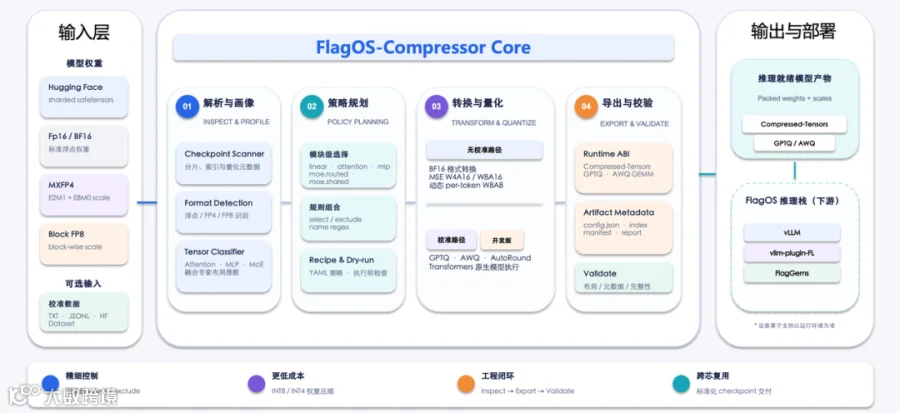
框架能够接入目标芯片,并不等于新模型就能直接部署。面对几千亿乃至万亿参数模型,部分存量设备缺少相应的 FP8、FP4 执行能力,而将模型权重转为 BF16 又会增加存储需求,可能超出设备的显存容量。FlagOS 2.2 首次发布 FlagOS-Compressor,为跨芯片部署提供统一的权重转换与量化工具。 它根据模型结构与目标硬件选择处理方案,将权重转换、量化、导出与校验组织为统一流程,配合底层算子和框架插件,帮助新模型适应已有设备。
图 4|FlagOS-Compressor 的转换、量化与产物导出流程
量化需要兼顾模型效果与硬件支持。FlagOS-Compressor 可按模块选择量化策略,为敏感模块保留高精度,并将权重、量化参数与运行配置一并导出。配合 vLLM-Plugin-FL、FlagGems 等组件及目标硬件的部署配置,压缩后的模型才能进入实际推理。
在Qwen3.8-2.4T-A95B的适配实践中,工具提供从BF16、FP8原始权重到INT8的处理路径,面向选定模块采用W8A8,并结合目标平台的显存、卡数与通信条件组织交付,目前已提供面向平头哥、昇腾和海光等平台的INT8模型、配套镜像与部署配置。Qwen3.5-397B-A17B则展示了量化的另一层价值:Attention与MoE专家网络采用W8A8、视觉编码器保持BF16后,模型文件由751.41GB缩减至382.45GB,减少49.1%;量化模型GPQA-Diamond取得84.85%的绝对准确率,并在NVIDIA H20与国产PPU上完成推理链路验证。
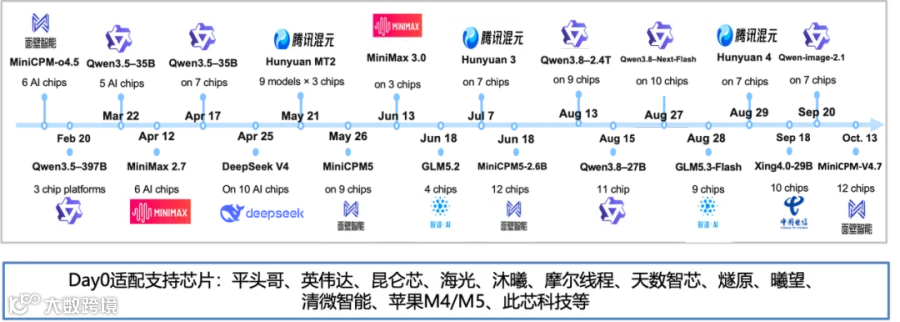
3. Day0 交付:新模型一天内适配多达 12 款芯片
有了插件、算子、编译器与量化工具的共同积累,新模型发布后的适配可以少做重复工作。已有能力越充分,新模型进入不同芯片平台时,需要补齐的工作就越少。在过去半年的多次实践中,FlagOS 已实现新模型一天内适配到多达 12 款芯片,展现了公共软件能力持续复用对适配速度的支持。
适配速度之外,交付还要回答模型在目标设备上是否可用。FlagOS 对适配后的模型版本重新测试,评估模型在目标设备上的任务表现,再将模型与相应配置发布到 Hugging Face、魔搭等平台。开发者因此可以从已有版本和配置出发,减少重复适配与环境摸索。Day0 体现响应新模型的速度,目标硬件上的测试和配套产物则决定交付质量;具体服务性能仍需结合业务负载继续验证。
4. 合作案例:中国电信星辰模型Day0适配 10 款芯片,优化成果回馈社区
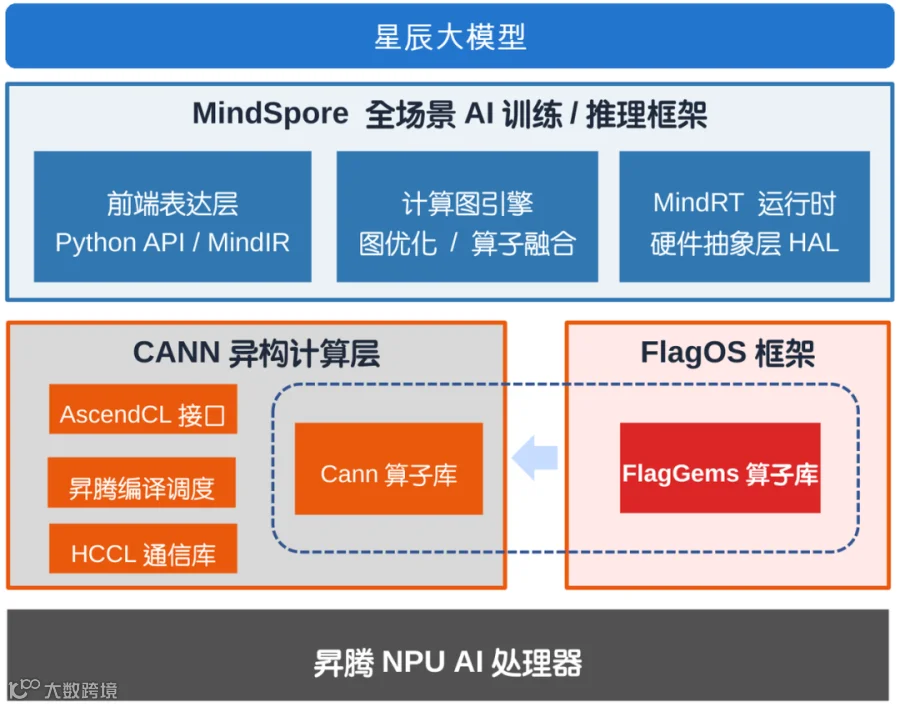
模型企业既是这些公共能力的使用者,也是新的优化需求与实现的贡献者。中国电信的星辰大模型实践展示了这种协作方式。在训练侧,中电信人工智能科技有限公司将 FlagGems 接入基于 MindSpore、CANN 和昇腾 NPU 的训练体系,用专项优化算子替换部分原生实现,同时复用 MindSpore 的自动并行与分布式通信能力。mHC、TopK 等训练算子已接入框架并完成全链路调试和端到端训练效果验证,MindFormers 集成 FlagOS 的工作也已开源合入。模型团队由此在已有训练体系中接入公共算子能力,并与社区共同推进后续维护。
图 6|中国电信星辰大模型接入 FlagOS 的训练架构
推理侧的合作同时覆盖多芯部署与算子贡献。Xing4.0-29B-A4B 已完成十款芯片平台上的适配、精度对齐和部署验证,其中八款采用标准适配,苹果 M5 Pro 与此芯 P1 采用 W4A8 端侧量化。团队还完成了 12 个推理算子的迭代替换,并将算子开源至 FlagGems 与 vLLM 主仓。在所展示的高并发、长输入测试中,相比英伟达原生算子实现,首 Token 时延降低 19.87%,解码速度提高 26.32%。企业将真实负载中的需求和实现带回社区,使共享优化能够在模型使用过程中继续积累。
三、从运行模型到高效生产Token:跨芯优化进入真实服务场景
模型完成跨芯交付之后,还要面对真实应用的要求。Token 服务关注的是新模型不断更新时,已有算力能否持续提供有竞争力的速度与成本;世界模型引入视频、空间和多模态数据,计算复杂度随之增加;模型进入端侧,又要在有限的内存、算力和功耗条件下运行。这三类需求共同推动 FlagOS 从多芯适配走向持续的共享优化,也决定了开放计算基座需要覆盖的范围。先看当前最直接的产业需求:如何让已有设备承接新一代模型服务。
1. DeepSeek V4.1 Flash:跨平台优化展现商业 API 竞争潜力
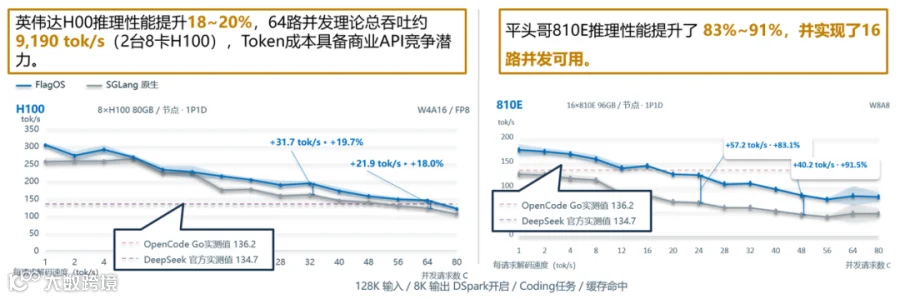
面向DeepSeek V4.1 Flash,智源FlagOS社区以SGLang-Plugin-FL、FlagGems、FlagGems-SGLang、FlagTree与FlagCX 组成优化栈,分别在英伟达 H100 和平头哥 810E 上优化 DeepSeek V4.1 Flash。H100 测试采用两台各 8 张 H100 80GB 的服务器,采用 1P1D(一个输入预填充节点、一个解码生成节点)与 W4A16/FP8 配置;在 128K 输入、最多 8K 输出、开启 DSpark 的缓存命中 Coding 任务中,32 路和 64 路并发下,每请求解码速度分别增加 31.7 和 21.9 tokens/s,提升 19.7% 和 18.0%。
平头哥 810E 采用每节点 16 张 96GB 卡、1P1D、W8A8 配置。在对应的长上下文 Coding 测试中,相比该平台的 SGLang 原生路径,24 路并发下每请求解码速度增加 57.2 tokens/s,提升 83.1%;48 路并发下增加 40.2 tokens/s,提升 91.5%。随着并发提高,优化后的曲线仍保持对原生路径的速度优势。
图 7|DeepSeek V4.1 Flash 的跨平台推理优化:左为 H100,右为平头哥 810E
2. GLM-5.3-Flash:存量 910B 服务吞吐约翻倍,场景测算成本较 API 计费降低 19.4%—27.6%
存量硬件能否承接新模型,是软件优化经济价值更直接的试金石。过去几年,昇腾 910B 已有大量部署。基于FlagOS技术栈对GLM-5.3-Flash 的优化给出了继续使用这些设备的具体依据:Agentic 回放场景的逻辑服务吞吐约为优化前的 2.04 倍;长上下文测试中的生成速度接近官方 API 外部测量参考值;在指定租赁、缓存与利用率条件下,场景成本比对应 API 计费参考降低 19.4%—27.6%。 这些分别来自回放测试、长上下文测试与成本测算,共同回答了企业关心的问题——现有设备经过软件优化,能否继续以有竞争力的性能和成本承接新模型。
512K 场景下的 60.9 tokens/s,接近官方 API 的外部测量参考值 61.1 tokens/s,两者数值之比约为 99.7%。这一比较仅针对生成速度,外部 API 并非同负载对照。
成本优势能否成立,还取决于部署条件。下表按每台 8 卡 910B 月租 16,500 元、3P1D 部署(三台处理输入、一台负责解码生成)、93% 缓存命中率及解码侧满载,测算每百万输出 Token 及其对应输入的场景成本。两个长上下文场景的测算成本均低于对应 API 计费参考,为存量设备承接新模型服务提供了经济性依据。
场景 |
API 成本参考 |
FlagOS 部署成本估算 |
成本降低 |
256K 输入/8 并发 |
73.55 元 |
59.27 元 |
19.4% |
512K 输入/4 并发 |
144.31 元 |
104.53 元 |
27.6% |
表 3|每百万输出 Token 对应的场景成本估算,保留上述输入与缓存条件
这些结果来自关键算子与缓存、通信、请求调度等环节的共同优化。在三台 P、一台 D、共 32 张 910B 的 Agentic 多轮会话回放中,联合优化将逻辑服务吞吐从 8.52k 提高至 17.36k tokens/s,约为原来的 2.04 倍。这一指标包含输入与输出 Token,以及缓存命中的逻辑输入,反映服务承载能力,并非纯输出生成速度。
企业长文档、代码库和多轮 Agent 任务,还需要兼顾首字等待与持续生成速度。下表在 256K、512K 输入、输出长度 1K 的条件下,对比优化版本与厂商基线:冷启动首字时间和满载生成速度均有改善,供企业结合业务时延要求选择配置。
输入长度/并发 |
冷启动首字时间:基线 → 优化后 |
满载 Token 间时延:基线 → 优化后 |
满载单请求速度:基线 → 优化后 |
256K/8 |
91.44 → 84.03 秒,降低 8.1% |
86.94 → 72.47 ms,降低 16.6% |
36.3 → 53.7 tokens/s,提升 48.0% |
512K/4 |
279.28 → 199.63 秒,降低 28.5% |
76.05 → 63.84 ms,降低 16.1% |
43.2 → 60.9 tokens/s,提升 41.1% |
表 4|910B 长上下文测试结果
这些结果直接回应了模型与硬件的代际衔接问题:新模型推出后,企业可以先评估软件优化能否让现有硬件继续承担服务,而不必把模型升级与整批硬件换代绑定。 具体部署仍需结合业务负载、时延要求和完整运营成本判断,但存量设备继续服务新模型,已经有了可供评估的性能与成本依据。
3. 合作案例:软通动力GLM-5.2 的 p50 Token 间时延降低 14.53%
复用优化也在进入企业的服务平台。软通动力的天元智算混合云服务平台接入 FlagOS 的算子、编译、通信与训推框架能力,连接上层模型服务与底层异构设备,为公共能力进入企业部署体系提供了实例。
图 8|FlagOS 核心能力衔接模型服务、平台运营与异构资源调度
软通动力与 FlagOS 团队还在四台昇腾 910C 服务器上,对 GLM-5.2 进行了联合优化,Prefill 与 Decode 各占两台。下表对比五项改动全部关闭与全部启用后的低并发时延,展示算子与执行路径优化进入完整服务后的效果;该测试与前述 910B 的 GLM-5.3-Flash 测试分别进行。
测试配置 |
服务端 p50 ITL(ms) |
客户端 p50 ITL(ms) |
p50 TPOT:服务端/客户端(ms/token) |
基线:五项改动均关闭 |
68.96 |
68.97 |
17.79/17.70 |
优化后:五项改动全部启用 |
58.94 |
58.95 |
15.20/15.12 |
表 5|软通动力与 FlagOS 的 GLM-5.2 联合优化结果,为低并发延迟测试
优化后,服务端与客户端的 p50 ITL 均降低 14.53%;反映长尾等待的 p99 ITL,服务端从 83.82 降至 66.35 ms,客户端从 138.56 降至 118.73 ms,分别降低 20.84% 和 14.31%。对平台运营方,这意味着同一批设备通过软件更新改善了生成时延,客户端长尾等待也有所减少,为评估实际业务负载下的服务能力提供了依据。
四、从Token Factory走向物理AI:世界模型与端侧计算迎来新负载
AI计算需求正在沿着三条路径扩展:数据中心里的Token Factory追求持续演进和规模效率;端侧AI需要在有限内存、能耗与硬件空间内运行;服务于物理AI的具身世界模型则引入视频、空间、时间、动作及多传感器数据,模型计算维度和系统组织复杂度同步增加。物理AI离不开世界模型的实现和端侧AI的落地,这两者都对AI计算产生新一轮重大挑战。FlagOS提前布局,向物理AI的计算需求延展技术栈在算子库、编译器、框架等的能力,并进行相应的技术突破。
1. 助力智源研究院新一代具身世界模型:公共算子与训练系统协同
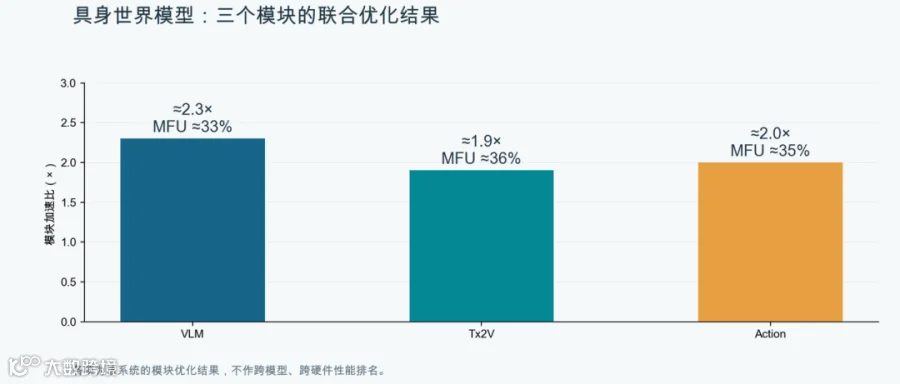
智源研究院新一代具身世界模型系统与 FlagOS 的 FlagGems 算子、训练框架与分布式策略开展联合优化,VLM、Tx2V 和 Action 三个模块分别取得约 2.3×、1.9×、2.0× 的加速,MFU 分别约为 33%、36%、35%,有效提升了世界模型训练过程计算时间,加快训练过程。
图 10|具身世界模型三个模块的优化加速比与 MFU(模型浮点运算利用率)
MFU 衡量训练中有效模型计算对硬件理论计算能力的利用程度,可作为观察算力利用效率的指标:Cosmos3-Nano 为 23%,Cosmos3-Super 为 30%,本方案约为 33%—36%。这些数据提供了相关工作的参考范围,但模型和训练设置不同,不能据此给出整体性能排名。对于本方案,加速比与 MFU 分别反映执行速度和计算利用效率,需要结合起来评估联合优化的效果。
相关工作/方案 |
训练 MFU |
Cosmos3-Nano |
23% |
Cosmos3-Super |
30% |
本方案 |
约 33%—36% |
表 6|世界模型训练 MFU 的相关工作参考
理解、视频和动作序列的长度与结构不断变化,会影响编译、内存分配和设备利用率。框架层先采用固定序列长度组织数据,将稳定的张量形状交给静态编译,用动态元数据表达样本差异。与同样采用固定序列长度、但不使用静态编译的执行方式相比,这一步带来 19.7% 的吞吐提升和 29.5% 的显存下降,为底层算子的执行提供了更稳定的计算形状。
长序列 Attention 还需要权衡保存中间结果与反向重计算的成本。缓存输出 O 及 Softmax 归一化所需的 LSE,供反向传播复用,可将相应前向重放次数从 288 次降至 0 次,使生成分支吞吐提高 14.8%。与这些框架层改进相配合,FlagGems 为 Attention、索引和归约等关键计算提供优化实现。框架负责减少重复工作、组织执行,算子库负责提高实际计算效率,两层改进共同作用于完整训练过程。
图 11|世界模型计算优化:静态图组织与 Attention 缓存复用
FlagGems 的贡献可以从计算占比与算子测试中具体观察。在该世界模型的内核时间中,Attention 前向占 26.0%、反向占 33.3%,合计 59.3%,GEMM 占 36.2%。Attention 算子获得约 1.40—1.43× 的加速,索引算子最高达到 2.97×。这些基础运算同样存在于其他模型中;将优化保留在公共算子库,让后续模型与硬件适配有实现可复用,正是 FlagOS 向世界模型延伸的价值。
模型分支 |
算子 |
调用次数 |
算子加速比 |
VLM |
mean |
4,640 |
1.25× |
VLM |
flash_attn_3 反向/前向 |
各 1,620 |
1.397×/1.424× |
VLM |
index_put_impl |
1,125 |
2.170× |
T2V |
flash_attn_3 前向 |
14,400 |
1.40× |
T2V |
index_put_impl;sum |
800;400 |
2.97×;1.44× |
PWM |
flash_attn_3 前向 |
1,728 |
1.425× |
PWM |
fused_rmsnorm_fwd;chunk_cat |
864;222 |
1.03×;1.16× |
表 7|世界模型真实计算形状上的 FlagGems 算子测试
2. LightX2V-Plugin-FL:把统一插件体系延伸到视频与动作生成
FlagOS 的统一跨芯插件系统,也在承接语言模型之外的新任务。LightX2V 是视频生成推理框架,LightX2V-Plugin-FL 则是其接入 FlagOS 的插件:框架组织模型流程,插件连接目标设备与算子执行路径,FlagGems 承担实际的 Attention 计算。视频生成需要反复执行去噪步骤,插件让已有算子能够进入这些循环计算,减少为不同芯片分别改造模型框架的工作。
DreamZero-DROID 的双卡验证跑通了从图像输入到视频与动作输出的链路,说明这一接入方式已进入具体模型的执行过程。对 FlagOS 而言,它补充了世界模型训练之外的交付验证:公共算子经统一插件进入视频生成框架,并在国产硬件上完成模型任务。这里验证的是跨芯运行与完整输出,速度提升仍需同条件基线测试。
3. ARM CPU:MiniCPM5-2B 在 M5 Pro 上生成约 92 tokens/s
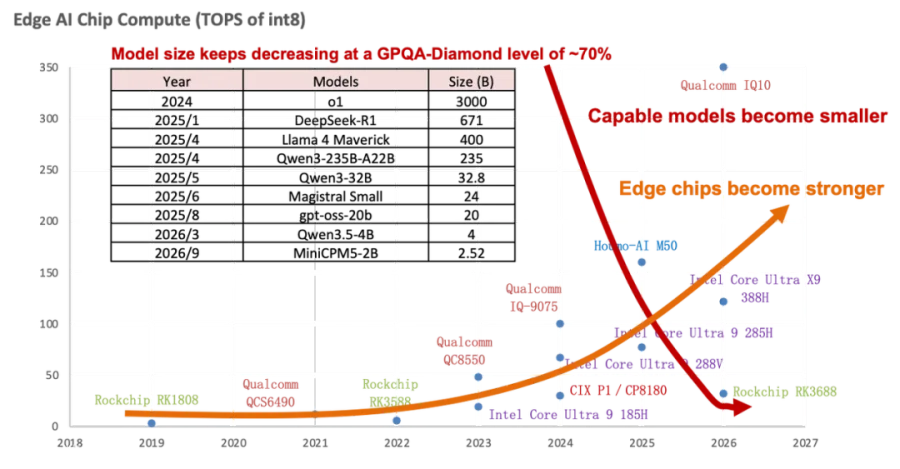
端侧AI应用正在同时受益于两项变化:芯片的本地计算能力提高,达到较强任务表现所需的模型规模缩小。以 GPQA-Diamond 约 70% 的表现水平为观察窗口,相关模型记录从较大参数规模逐步延伸到数十亿参数级;与此同时,端侧芯片的算力也在提高。两者共同扩大了模型本地运行的空间,软件优化则决定这些硬件和模型条件能否转化为可用的响应速度。
图 12|端侧算力增强与具备较强任务能力的模型规模缩小,共同改善本地部署条件
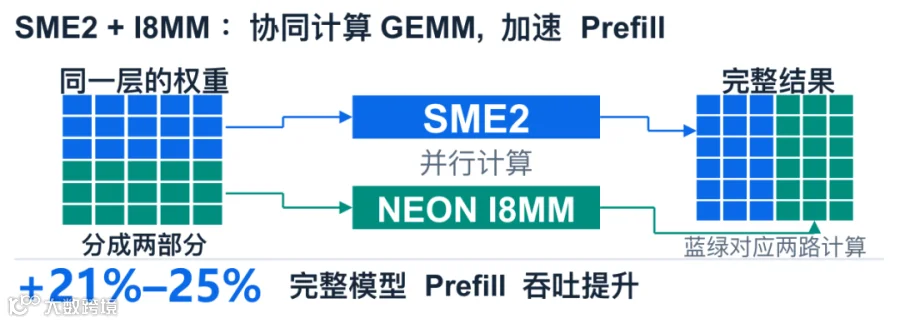
为了应对越来越多CPU承担端侧AI小模型的应用场景,FlagOS 2.2独立发布FlagTree-CPU,针对ARM CPU推进统一编译、低比特算子与运行时优化。Prefill适合批量矩阵计算,Decode则常受权重读取与固定调度开销制约;因此工具链围绕I8MM、SDOT及流式访存等路径进行差异化设计,并通过算子融合与执行调度减少重复开销。在具备相应指令支持的CPU上,SME2与NEON I8MM协同处理同一层GEMM,使完整模型Prefill吞吐提高21%至25%。
图 13|SME2 与 NEON I8MM 协同计算示意
在 Mac M5 Pro、CPU-only 的测试中,MiniCPM5-2B 的Prefill速度超过1000 tokens/s,Decode 速度达到 91.66 tokens/s;Qwen3.8-27B 采用 DFlash2 后,Decode 从 12.73 提高到 23.40 tokens/s,约为原来的 1.84 倍。这些结果给端侧应用提供了具体的选择依据:对于适合本地执行的任务,开发者可以在模型能力、设备内存与时延之间选择配置,让部分推理工作留在设备上完成。端侧实用性的推进,来自更强的本地硬件、更小而有能力的模型,以及把二者连接起来的软件优化。
五、从技术共建到全球生态:代码贡献者增加55%,下载量增加四倍
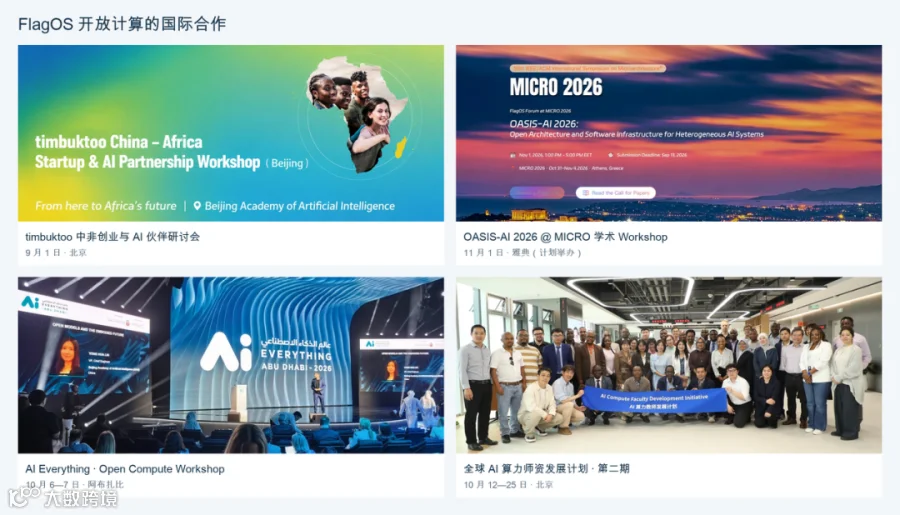
智源众智FlagOS 希望立足中国、走向全球,参与解决不同国家共同面对的 AI 计算问题。国际合作既包括中非创业与 AI 伙伴研讨会、阿布扎比 Open Compute Workshop 等技术交流,也包括开发者与师资培养。全球 AI 算力师资发展计划第二期在 UNDP 支持下与非盟 ASRIC 联办,汇集来自 30 多个国家的近 50 位高校骨干教师。计划举行的 OASIS-AI 2026 @ MICRO Workshop 则进一步聚焦异构 AI 系统的开放架构与软件基础设施,让更多团队参与开放计算的使用与建设。
联合国“开放计算工作组”(Working Group on Open Compute for Research, Education and Innovation)已于 9 月 28 日获批成立,首次会议计划于 11 月 APEC 期间举行。围绕研究、教育与创新推进技术互通,也为开放计算的国际协作提供了持续交流的机制。
2. 开发者社区:季度下载量增加四倍,代码贡献者持续增加
让多种硬件共享不断更新的模型生态,需要各方长期共同维护。芯片厂商接入后端,模型团队带来新负载,框架社区维护接口,开发者补充算子、调试和测试,任何一层停止维护,模型升级都可能重新遇到问题。FlagOS 的每次发版都依赖多个开源社区的合作,持续与 PyTorch、Triton、vLLM、SGLang、Megatron、TransformerEngine、VeRL 等上游社区协作维护接口与实现,才能让已有优化跟着新版本继续使用,让新的工程投入继续惠及更多模型与设备。
截至第三季度,智源FlagOS 生态成员单位达到 107 家,季度社区下载量为 464,336 次,是第二季度的 4.76 倍。版本背后的开发投入也在增加:从 2.1 到 2.2,合并 PR 数从 1,890 增至 4,890,代码提交从 5,100 增至 9,730,新建 Issue 从 420 增至 1,423,代码贡献者达到 264 位、增加 55%。下方的头像拼图呈现了参与FlagOs2.2建设的开发者。一个算子实现、一项后端适配、一次问题排查和修复,都需要有人持续投入;前文的性能改进和模型支持,正是这些具体工作共同积累的结果。
图 15|FlagOS 2.2 社区开发者头像拼图
当前AI模型可能3个月一代,算力基础设施却要在多年中创造价值。FlagOS 2.2显示,一条值得持续投入的技术路径已经越来越清晰:把面向新模型的算子、编译、量化和系统优化沉淀为可复用的公共能力,通过统一接口交付给不同芯片,再在真实模型与服务负载中不断验证收益。从Token Factory到端侧AI与世界模型,开放计算的价值不只是增加硬件选择,更是让每一种已经投入的算力,都有机会随着软件生态的进步持续发挥作用。