

最近,实时世界模型成了 AI 圈的一个新热点。
前 Hugging Face 亚太生态负责人、现在在 vLLM 团队的王铁震,发帖夸了 PixVerse R2:在里面一直往前探索,很享受,也很放松,甚至可以拿来当壁纸或者屏保。
夸完他也提到:受算力限制,只能玩很短一会儿。
这段话其实点出了实时世界模型普及的一大障碍:体验已经能做到让人想多待一会儿,但算力还撑不住。离普通创作者还有多远,卡在哪几处,海外社区这波讨论里已经有不少线索。
先说它是啥
PixVerse R2 是一个通用实时世界模型,9 月 22 日发布,由 AI 视频平台 PixVerse推出。在大多数人做的还是常规 AI 视频的时候,今年 1 月,PixVerse 另起一条线做实时世界模型,先出了第一代 R1,R2 是这条线上的第二代。
R2 有几个特点:
-
边生成边接收输入:文字、参考素材、音频,以及键盘方向键这类操控信号,在运行中随时都能输入 -
音画一起出:画面和声音同步生成 -
变化会延续:你做过的操作会影响后面的画面,跑得久一些,角色和场景也能保持一致 -
跟得上操作:生成速度能实时响应你的输入
它和平时说的 AI 视频是两个方向,AI 视频交付一段成片,生成完就结束。实时世界模型给你的是一个一直在跑的世界。你在里面往前走,中途敲一句话,场景就跟着变,前面做过的动作,后面还看得到影响。
海外在聊什么
R2 发布之后,海外社区的讨论分成了两拨。
一拨是做内容的,已经玩起来了。产品设计师 Tran Mau Tri Tam 在 Dribbble 上有 11 万关注,他拿 R2 给自己设计的吉祥物搭了个小世界,看它实时回应输入,边播边打字、实时改写世界。
另一拨是做技术的,有做推理框架的,有做空间重建的,也有做开源生态的。他们也夸,但夸完多半会补一句限制。
我把这些限制归了归类,大概是三件事:算力,跑久了稳不稳,还有做出来之后怎么用。
第一道坎:为什么实时这么烧算力
算力限制跟它的生成方式有关。R2 用的是因果自回归,可以理解成接龙,每段新画面都接在前面的后面生成。普通视频接到结尾就停了。世界不一样,你在里面待多久,它就得一直接下去,中间你随时按键、打字,它还得接得住。
翻看技术报告,很大篇幅都在讲怎么省算力。我挑三处说。第一处是历史信息分开存:角色和场景这类长期不变的放一处,最近几秒的动作放一处,具体物体的状态再放一处。这样跑得再久,要带着算的东西也不会无限变多。第二处是把去噪的步数蒸馏到很少几步。第三处是稀疏注意力,稀疏度做到了 90% 以上,官方评测里效果基本没掉。
换成大白话:模型每算一块画面,九成以上的关联直接跳过,只看跟它关系最大的那些。
SGLang 的作者之一 Chenyang Zhao 也发了帖。SGLang 是开源推理框架,他对这个问题的体感很直接:
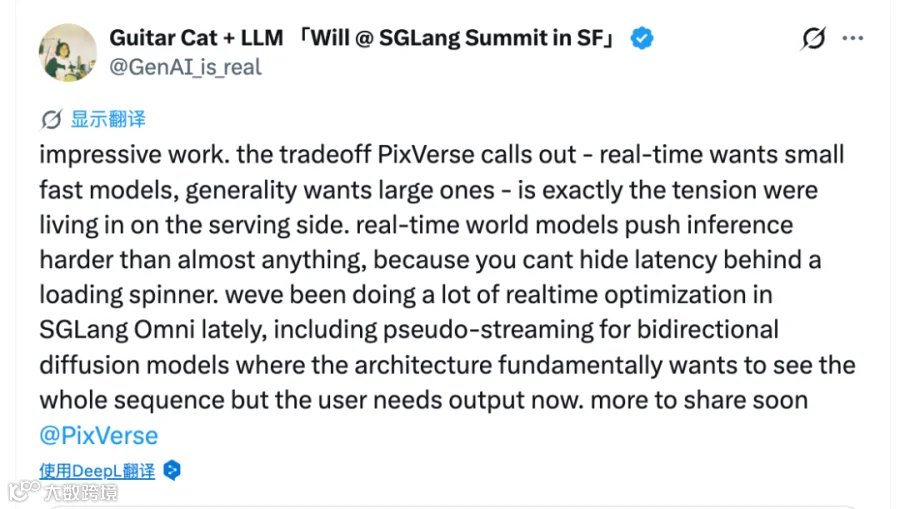
PixVerse 点出的这个取舍,实时要小而快的模型,通用要大模型,正是我们在推理服务这一侧每天面对的矛盾。
至于用一次要花多少钱,官方没公布,这里就不估了。只能说,视频是生成完一段就停,世界是你待着它就一直在耗算力,两种成本算法差别很大。
第二道坎:跑久了还稳不稳
World Labs 做空间重建的 Chongjie Ye 这样说:
实时世界模型并不新鲜,但这个跑久了明显更稳,抖动更少,世界突然改主意的时刻也更少。还早,但……
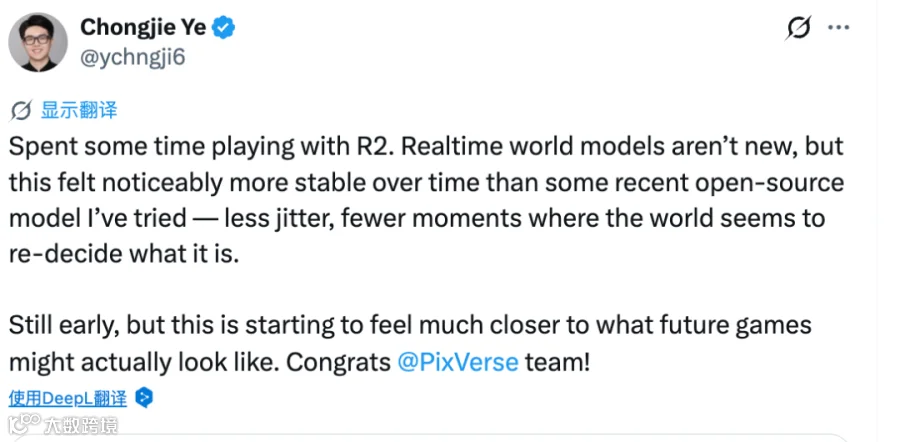
他说的世界改主意,业内一般叫漂移。还是接龙的问题:前面某一段颜色偏了一点,后面每一段都照着偏的接,越接越偏,有点像传话游戏传到最后一个人。
R2 的做法,一是训练时故意喂一些带噪声的历史,让模型习惯前面不完美的情况;二是攒了一个错误库,把跑偏过的状态收集起来放回训练里,让模型练怎么拉回来。官方的阶段性评测里,长时间运行的亮度漂移指标从 0.201 降到了 0.129。
稳是稳了一些,画面质量还差一截。这点报告写得很直白:在实时的延迟要求下,单次生成的效果比不上前沿的离线视频模型,细节、动作自然度、物理一致性都要补。
差距能不能缩小,我觉得关键在训练流程。以前做实时生成,通常要串好几道训练工序,每倒一次手,前面练出来的能力就损失一点。R2 只留了两道:先一直练一个大模型,再把它直接蒸馏成实时版本。这样大模型那边每进步一点,实时版本都能接着用上。
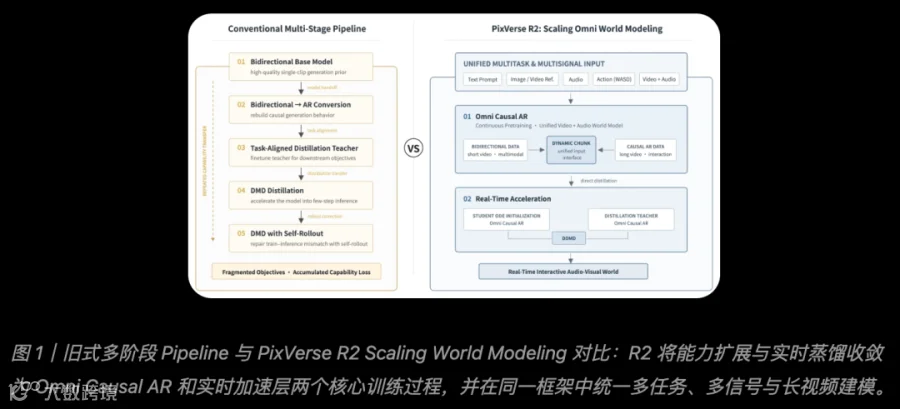
图源:PixVerse R2 技术报告
第三道坎:世界做出来了,怎么发
前面两道坎,工程师在解决。这一道得靠做内容的人自己想。现在发视频,流程很清楚:剪好,上传,别人刷到。换成一个世界,发出去的是什么?是录一段自己在里面逛的过程,还是把入口交给观众,让他们自己进去?眼下都没有现成的答案。
报告里有一处设计,跟创作关系比较大。R2 同时接受文字、参考素材、音频和键盘操作,这几样东西节奏差得很远:一句话可能描述一整段剧情,按一下方向键却要马上有反应。R2 的办法是按输入的类型调整每次生成的长度,叫动态分块。落到创作上,就是可以一边用文字推剧情,一边用方向键控制往哪走,两样同时生效。

图源:PixVerse R2 技术报告
Scale AI 的高级产品工程师 gabrycina 对这件事评价挺高:
能用 WASD 走动的生成世界,打开了一个巨大的产品面,堪比当年把大模型放进聊天框。
模型能力有了,怎么让大众用起来,很重要,就像当年大模型之于聊天框,上手就懂,对于实时世界模型来讲,PixVerse的边输入边生成就是一种模式探索,除此之外,一些新的可能也在发生,比如直播时观众打一句弹幕就能改写场景,或者干脆把世界做成一个可交互链接,观众点开自己走进去与之交互了。
小结
算力和稳定性这两块,报告里的改动都在往这个方向使劲,要多久能到普通人随便用的程度,我说不准。怎么拿它做内容,工程师替不了。聊天框刚出来那会儿,也没人想到后来会有这么多用法。
它现在还在早期研究阶段,离进创作者的日常工作流还有段距离。不过可以先想想:要是观众能走进你做的内容里,你会给他们搭一个什么样的地方?
关注公众号回复“进群”入群讨论