大数跨境

GPU 三十年演进史:从图形加速器到 AI 算力引擎(三)

GPU 三十年演进史:从图形加速器到 AI 算力引擎(三) 联通上海产业互联网公司
2026-10-19
3

GPU 三十年演进史:从图形加速器到 AI 算力引擎(三)

上一篇看完 NVIDIA 的三板斧,这一篇回头看国内,讲讲国产芯片怎么换个打法:制程被卡住之后,单颗芯片追不上,国产算力就不再死磕单颗——把成百上千颗芯片连成“一台计算机”,用规模换性能。
 一、国产 GPU 的崛起(2023-2026)
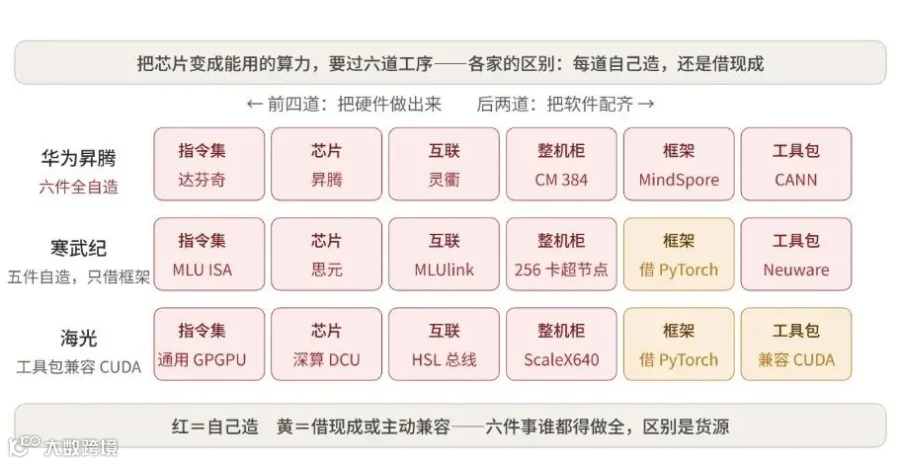
2023 年之前,国产 GPU 的短处很直白:单卡性能就是追不上。2023 年之后,比法先变了。单颗追不上,就把成百上千颗芯片连起来当成一台机器用,拿规模换性能。一颗芯片从图纸变成客户手上的算力,要过六道工序:设计指令集、造芯片、做卡间互联、组整机柜、写软件工具包、适配深度学习框架——前四道把硬件做出来,后两道把软件配齐。每一道都得做选择:自己造,还是用别人现成的?各家走的路不一样,差别全在这六个选择上。
读法:六列从左到右,前四道把硬件做出来(指令集、芯片、互联、整机柜),后两道把软件配齐(工具包、框架);红=自己造,黄=借现成或主动兼容。三行谁也不缺哪一件,差的是自己造的范围画到多大
1、华为昇腾
先看华为,走的全栈自研路线:芯片是达芬奇架构(华为自研的 AI 计算核心设计),互联是灵衢总线(自研的卡间高速通道),整机柜是 CloudMatrix 超节点,软件是 CANN 和 MindSpore(自研工具包和框架,分别对标 NVIDIA 的 CUDA 和主流深度学习框架)。全自己造的好处很实在:哪一层拖了后腿,就在哪一层下功夫,不用等别人;代价也明摆着,每一层都得自己养。
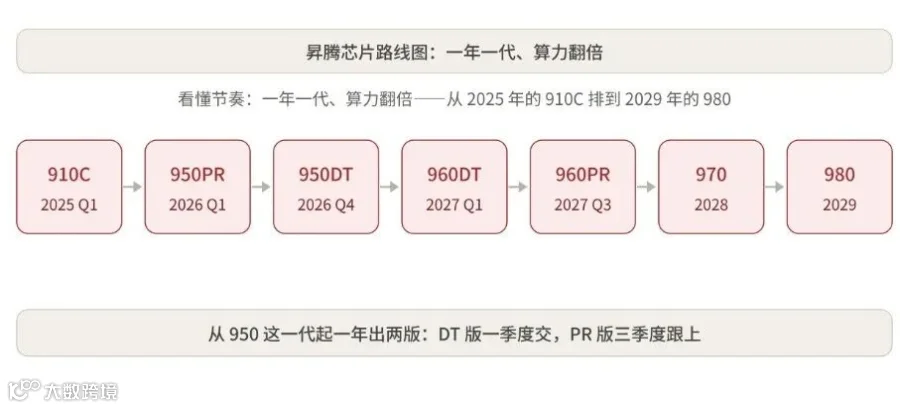
迭代节奏上,昇腾从 2025 年起坚持一年一代、算力翻倍,而且从 950 这一代起,一年出两版:DT 版主攻训练与解码,PR 版主攻预填充与推荐类推理,同一代芯片按训练、推理两种活儿分工。
读法:从左到右一年一代,每代算力翻倍;同一代的 DT、PR 两格不是两代,是同一代芯片的训练版和推理版;后面 970、980 已排到 2029 年
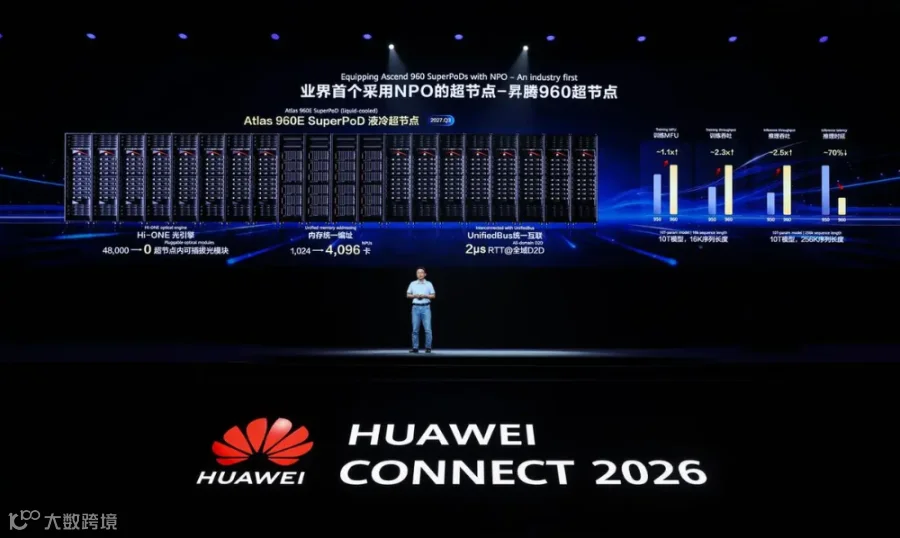
2026 年 9 月 17 日华为全联接大会带来 960 的最新消息:研发进度比计划还快——960DT 提前三个季度,2027 年一季度就绪;960PR 提前一个季度,2027 年三季度就绪,FP4 算力比原计划翻倍。
图源:华为全联接大会 2026 主题演讲(华为官方)
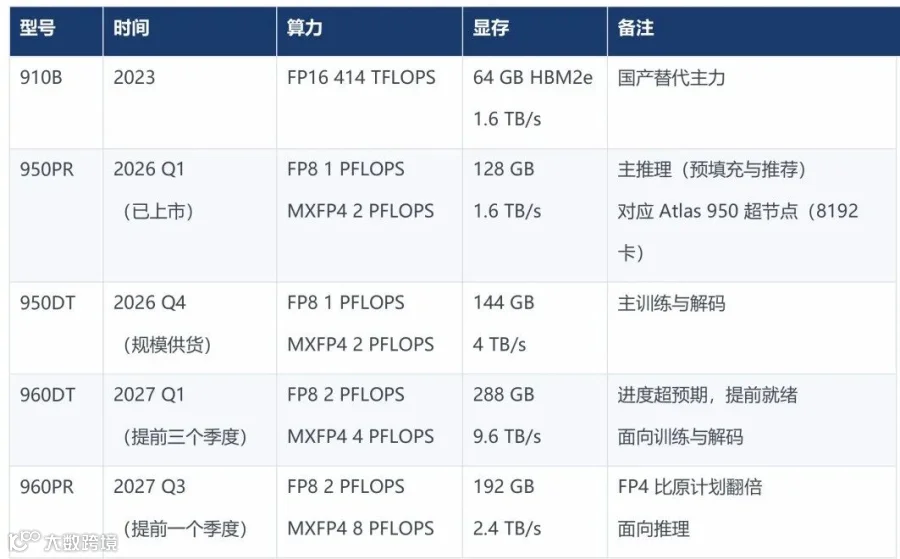
从 910B 到 960,把历代型号摆成一张表,看算力和显存怎么拉开。FP8、FP4 就是上一篇讲的“精度”——位数越少算得越快;1 PFLOPS 就是每秒一千万亿次运算:
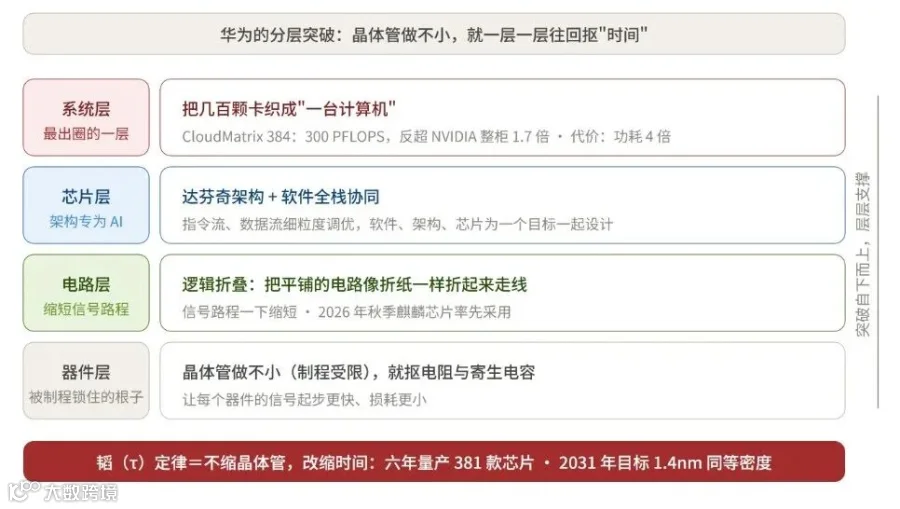
路线图看着提气,但有一道坎始终绕不过去:制程。最先进的制造工艺拿不到,单卡性能就一直跟在海外后面追。华为的解法是分层往上找空间——晶体管这一层被锁死,就在它上面的每一层想办法。2026 年 5 月,华为何庭波在国际学术会议上给这条路起了个名字:韬(τ)定律——晶体管做不小,就缩短信号在线路里跑的路程,从器件、电路、芯片到系统,一层一层压时延。
四层各自怎么干,看上图就够了,这里只说结果:反超发生在最顶上的系统层。刚发布的 4096 卡 960 超节点还在路上,眼下把反超做实的是现役的 CloudMatrix 384:把 384 颗昇腾 910C 织成“一台计算机”,算力约为 NVIDIA 同级整柜的 1.7 倍,代价是功耗 4 倍。性能买回来了,电费也花出去了——制程被卡住时拿规模换性能,账就是这么算的。
CloudMatrix 384 超节点:384 颗昇腾 NPU 通过 UB 统一总线全对等互联,像一台计算机一样工作
最后看生态——国产芯片最短的那块板。有两件事值得知道:一是 DeepSeek 新模型发布当天即完成昇腾适配(行话叫 0-day 适配,翻译过来是“发布即能用,不用等”);二是华为与硅基流动的联合论文显示,CloudMatrix 384 运行 DeepSeek-R1 的推理计算效率已经赶超 H800 方案。2026 年昇腾还推出 CANN Next:开发者可以沿用 CUDA 的编程习惯写昇腾代码——迁移成本这块最硬的骨头,也开始松动了。

2、寒武纪、海光与其他国产算力
寒武纪的技术出身就是中科院计算所的 DianNao 系列论文,指令从头到尾围着神经网络算子设计,通用性牺牲得更彻底,能效榨得更狠。整机柜这块也没落下:256 卡高密度超节点方案已在多地商业智算中心落地,更大规模的机柜级方案还在推进。

海光作为“兼容 CUDA”的国产算卡代表,基于 AMD 的 ROCm编译算子,语法跟 CUDA 几乎一样,用惯 NVIDIA 的开发者换过来,多数程序改几个词就能跑,迁移成本相对最低。整机柜这块它拉上了同门的曙光:ScaleX640 超节点把 640 张卡装进一个机柜,靠自研 HSL 总线拉低卡间延迟。

其他玩家里,平头哥 2026 年 5 月发布新一代自研 AI 芯片“真武 M890”,性能是上一代的 3 倍,配上自研互联芯片,单机柜 128 张卡组成超节点,已经上线阿里云,支撑千问大模型的训练与推理。

创业公司这边,各家路数也不同:沐曦主打通用 GPU 训推一体;燧原专做云端 AI 芯片,训推一体;壁仞走全栈自研通用 GPU 路线,用 Chiplet(小芯片拼装)做大芯片;天数智芯是国内头一批训练、推理两类芯片都量产的。2025 年底到 2026 年初,这批公司密集登陆资本市场,国产 GPU 的第一梯队基本成型。各家的情况,一张表看全貌:

考卷之外,还有几样东西值得单独拎出来——国产真正立住的五个突破点:
单卡那一格的账还没追平,但系统、互联、显存、方法论、生态五个方向,国产各立起了一个山头。以前是追赶者在后面追领跑者,现在是两套打法各跑各的道。

 二、摩尔定律在 GPU 领域的最新表现
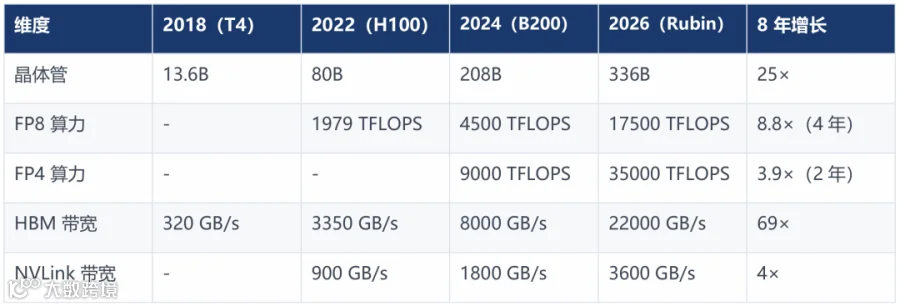
国产在换打法,海外的打法也没停。摩尔定律是芯片行业的老话:晶体管密度每 18 个月翻一倍,性能随之翻倍。它在 CPU 领域已经明显放缓——Intel 从 14nm 走到 10nm 用了约 5 年;但在 GPU 领域,被 AI 需求踩了油门,反而加速了:
读法:看三条线的距离——实线(算力)把灰色参考线(摩尔定律)远远甩开,黄线(显存带宽)却几乎贴着参考线爬,算力和带宽的剪刀差越拉越大;多出来的倍数不是晶体管挣来的,是专用电路、精度下探和系统级设计挣来的
八年下来,晶体管翻了 25 倍;算力这条线更陡——从 2016 年的 P100 数到 Rubin,单卡算力十年涨了约 190 倍。多出来的不是晶体管挣来的,是上一篇讲的“三板斧”挣的:Tensor Core 专用电路、HBM 显存升级、NVLink 整柜互联,再加上 FP4 这样的精度下探。

黄仁勋给这个节奏起了名字——“超级摩尔定律”:AI 计算性能每年翻一番甚至三倍,NVIDIA 的“一年一代”(Blackwell → Rubin → Feynman)就是代表作。当然也有冷静的声音:有海外分析机构认为,台积电先进制程和封装的产能瓶颈,可能让这个节奏在 2027 年后慢下来。

把海外和华为放到一起看,两边其实在回答同一道题:当“把晶体管做得更小”这条路变窄,性能从哪里来?海外的答案是超级摩尔定律——一年一代,靠专用电路、显存、互联和精度一起往上堆;华为的答案是韬定律——换一把尺子,以“时间缩微”替代“几何缩微”,从器件、电路到系统一层一层压信号时延。两条路殊途同归:性能不再只从“把晶体管做得更小”里来。


下一篇开始新的小系列:
GPU 架构演进——走进芯片内部,从 Turing 架构看起,看每一代的“图纸”到底改了哪里。


-END-


供稿:算力实验室

编辑:喻   靖

主编:虞祝豪

总编:堵炜炜

动动小手,让更多的人看到!      

【声明】内容源于网络
0
0
联通上海产业互联网公司
联通(上海)产业互联网有限公司。
内容 594
粉丝 0
联通上海产业互联网公司 联通(上海)产业互联网有限公司。
总阅读8.9k
粉丝0
内容594