One fusion, the strengths of many.
融合模型,尽揽众长。
今天,新加坡前沿模型实验室 FUMO Lab 正式发布新一代融合模型 Fusion Max 2.0,进一步强化办公、编程、金融与网络安全场景能力。
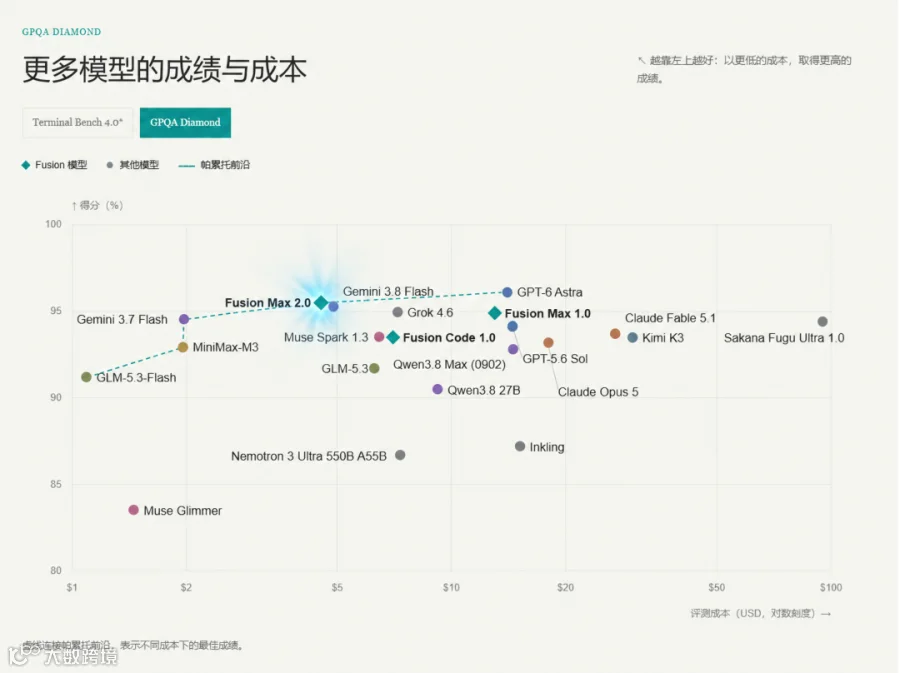
性能霸榜,成本骤降:Max 2.0 领跑多领域基准测试与全新复杂场景
 本次评测覆盖推理、终端操作、专业文档与办公问答。相比 GPT-6 Astra 与 Fable 5.1,Fusion Max 2.0 在 GPQA Diamond、Terminal Bench v2.1、XBench ScienceQA 三项测试中不仅取得了稳居第一梯队甚至领跑的优异成绩,更在评测总成本上实现了大幅度降低。
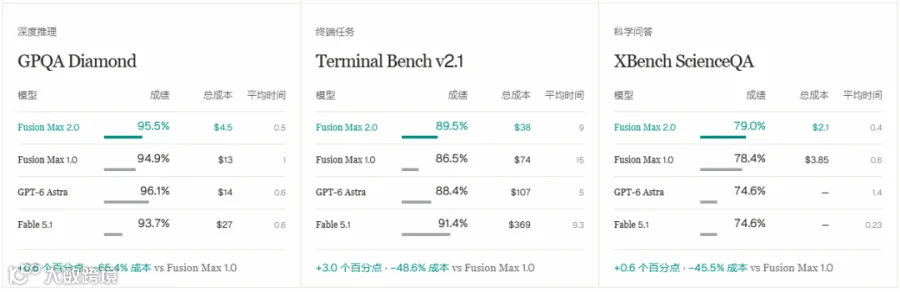
GPQA Diamond :Max 2.0 的总成本为 $4.5,相比 GPT-6 Astra($14)降低了约 67.9%,相比 Fable 5.1($27)降低了约 83.3%。
Terminal Bench v2.1 :Max 2.0 的总成本为 $38,相比 GPT-6 Astra($107)降低了约 64.5%,相比 Fable 5.1($369)降低了约 89.7%。
-
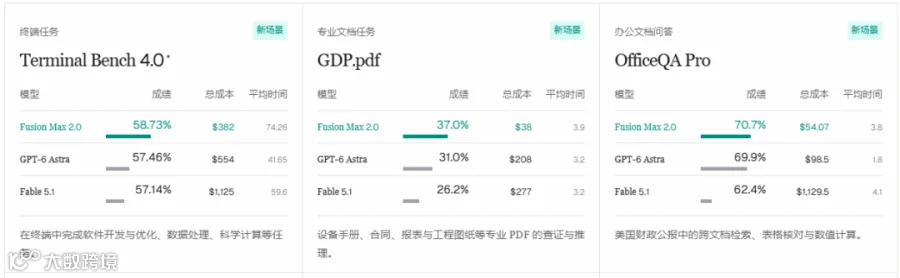
Terminal Bench 4.0(终端任务):评估模型在终端中完成软件开发与优化、数据处理及科学计算等任务的能力。 -
GDP.pdf(专业文档任务):侧重于对设备手册、合同、报表与工程图纸等专业PDF文档的查证与推理。 -
OfficeQA Pro(办公文档问答):考察模型在复杂文档(如美国财政公报)中的跨文档检索、表格核对与数值计算能力。

一句提示词,不到$2,轻松生成高品质游戏
提示词:“做一个肉鸽游戏”。
案例02:星际突击
提示词:“做一个飞机大战游戏”。
为专业办公场景而生
在处理历史公报等跨报表检索与长周期计算任务时,Fusion Max 2.0 突破了传统扫描图片识别的局限,展现出极强的数据提取与逻辑整合能力:
精准识别模糊信息:面对密集的行列、模糊的印刷及复杂脚注,模型能够准确提取扫描图片中的数字,并在遇疑处放大原图进行深度核验。
统一多表数据口径:能够跨越多份不同版本的报表,精准定位相同统计范围内的月度数据,有效避免漏项或数据的错误拼接。
深度核对与智能汇总:摒弃机械的“照抄合计”,模型能够逐一核验 24 个月的细项支出数据,并在统一的价格基准下完成按需汇总与复杂计算。

在处理长达 58 页且包含复杂图纸的专业设备手册时,Fusion Max 2.0 展现了卓越的跨页信息检索与逻辑推理能力,实现了低成本下的精准定位:
跨页线索精准追踪:面对分散在不同页面的复杂信息,Fusion 能够综合设备序列号、线路图与零件表,精准查证部件规格与适用依据。例如,模型成功从第 7 页的线路图确认连接关系,并跨页至第 21 页准确核对订货编号。
有效排除相似干扰:Fusion 具备强大的防混淆能力,成功排除了第 20 页名称相似但配置不匹配的干扰部件(这也是导致 Astra 模型出错的陷阱所在)。
完美满足要求且成本极低:在对比测试中,Fusion 是唯一完美达成全部 4 项查证要求的模型(Fable 5.1 与 Astra 均仅满足 3 项),且单题费用($0.3495)仅为顶尖模型的四分之一左右,实现了极致的效能与成本控制。

智能金融风控:高质量分析,低成本决策
“金融风控不仅需要准确的预测,更需要可信的判断依据。FUMO 让我们能够在数据有限的情况下,更准确、更高效地分析潜在风险。”

AI 安全检测:看穿伪装,识别隐藏风险

“AI 安全检测的难点,不只是发现明显的攻击,更在于识别那些隐藏在复杂语言和对话中的风险。Fusion Max 2.0 让我们能够更准确、更高效地完成安全判断,同时降低大规模检测的成本。”

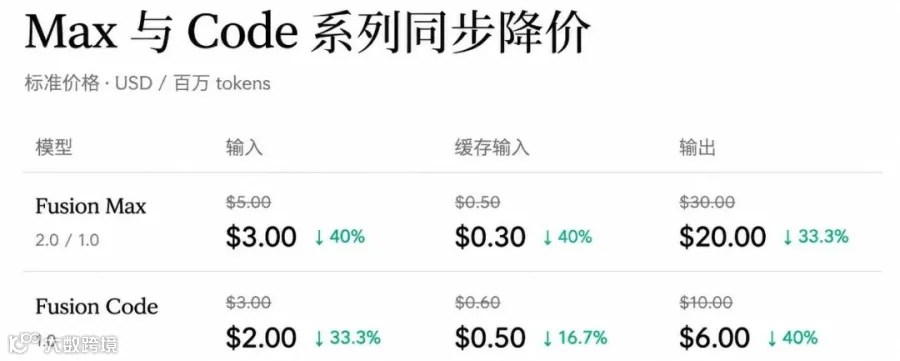
FUMO Max 与 Code 系列同步降价
免费试用
FUMO · Fusion Max 2.0 现已开放自助试用,请通过官网(fumolab.ai)注册,在 Playground 试用模型,或创建 API Key,将 FUMO 接入现有工作流。