今天,我们发布并开源 EdenLive,Project Eden 系列的实时生成式渲染器。
给它一段参考视频,比如游戏引擎里的灰盒画面、一段法线图动画,或者一段录制好的真实视频。再配上一张目标首帧和一句提示词,它就会沿着参考里的场景布局、镜头运动和物体动态,实时生成写实或风格化的画面。
在单张 GPU 上,EdenLive 能以超过 24 FPS 的速度生成 720P 画面,并支持分钟级连续生成。EdenLive 5B 模型可在单张 NVIDIA RTX 5090 上实时运行。
本次开源(Apache-2.0):
EdenLive 5B、14B 模型权重,各含双向生成与少步流式生成两个版本。
实时流式推理代码。
EdenGolem v0.1:一个 Agent Skill,让编程智能体把一句话变成可交互的灰盒世界。
前端工作台:串起「文字描述 → 可玩游戏 → EdenLive 实时渲染」的完整流程。
立刻体验——
项目主页:
https://vast-eden.ai/?p=edenlive
代码:
https://github.com/VAST-AI-Research/EdenLive
模型权重:
https://huggingface.co/VAST-AI/EdenLive
技术报告:
https://assets.vast-eden.ai/assets/edenlive/EdenLive-tech-report.pdf
Unbound Loop:http://loop.unbound.io
01
从 Project Eden 出发:
先有状态,再有渲染
2026 年 5 月 31 日,我们发布 Project Eden,提出世界模型应当「先有状态,再有渲染」。
目前被称为「世界模型」的系统,大多是动作条件视频模型:输入键鼠操作或镜头轨迹,模型根据最近的画面预测接下来的画面。世界如何演变、画面长什么样,都由同一个神经网络在像素里学习。
在这种做法里,状态只隐含在模型的上下文和已生成的画面中,无法直接查看、修改或验证。物体离开视野后,没有独立的状态记住它的位置,镜头转回来时只能重新推测。血量、得分这类精确数值,模型只能从过去几秒的画面里去猜,结果很容易偏离规则。交互方式也基本停留在 WASD 漫游、镜头控制和文本指令。此外,实时部署留给模型的算力本就有限,同一个网络既要学世界演化,又要学视觉外观,很难两头兼顾。
Project Eden 的方案,是把世界状态的演化和视觉渲染拆开,分成三层:
持续演化的世界状态:记录物体的位置与属性、交互规则和动作的后果,独立于任何镜头存在;
状态到画面的接口:把当前状态转换成某个视角下的布局、几何与事件约束;
生成式渲染器:根据这些约束生成高保真画面。
EdenLive 实现的是其中的第二层和第三层,不限定第一层。无论世界状态由游戏程序、游戏引擎还是动画工具维护,只要能输出参考视频,就能接入 EdenLive。
这样分工后,世界状态和交互规则都由上游维护,始终精确,可以直接检查、修改和测试,交互也可以扩展到上游暴露的任何状态量。模型也不必同时学习状态转移和视觉外观,有限的实时算力可以集中用在画面生成上。

Project Eden发布后获得了业界的肯定。
02
EdenLive 如何生成画面
EdenLive 根据参考视频、目标首帧和文本提示词生成画面:
参考视频:决定场景布局、镜头运动、物体轨迹和事件发生的时间。它可以从 3D 场景渲染得到,比如灰盒游戏、白模动画,或者由精细模型渲染出的法线图视频;也可以是 2D 游戏画面,或一段直接录制的视频。EdenLive 不要求参考达到特定的几何精细度,也不依赖 G-buffer 这类特定渲染管线的输出。
目标首帧:与参考视频的开场画面对齐,确定主体、材质、配色和画风。
文本提示词:补充风格和细节。交互过程中,上游可以在事件发生时追加一句描述,比如一次命中,画面随之变化。

参考视频说明物体在哪、镜头朝哪、接下来发生什么,首帧和提示词说明画面应该长什么样。同一段参考,换一张首帧和一句提示词,就能得到写实、手绘线稿等完全不同的外观。

这些参考的外观差别很大。灰盒画面几乎没有纹理,录制视频则带着完整的真实外观。模型要从中读出结构和运动,又不能把参考本身的外观带进结果:参考太粗糙时,生成画面容易退化成灰盒;参考太精细时,又容易照搬原视频的质感。
EdenLive 用一个专门微调的视觉编码器,把这些参考映射到同一个特征空间,只保留它们共有的布局和运动信息。
传统实时渲染需要人工制作 3D 资产、编写材质、调整光照,周期长、成本高。离线视频生成模型要先拿到完整输入,再整段生成,无法接入实时交互。
EdenLive 只需要参考提供结构和运动,画面由模型实时生成,并随参考持续更新。场景布局和物体位置由上游维护。镜头离开一处再转回来,参考里的结构还在原处,EdenLive 按同样的结构继续渲染,不必从过去的画面里重新推测。
EdenLive 提供两种生成方式。实时模式逐块流式生成,每一块只依赖已经到达的参考帧和保留的历史画面,用于交互场景。离线模式一次读入整段参考,双向生成,适合重渲染已有的视频和动画;更长的视频可以交给实时模式逐块处理。
两种模式的 5B、14B 权重都已开源。
03
实时游戏预览与交互
我们同时开源了 EdenGolem(v0.1),一个给编程智能体用的 skill:
输入一段玩法描述,智能体分四个阶段写出一个可独立运行的 3D 灰盒游戏。
第一阶段明确玩法、关键参数、胜负条件和场景主题。
第二阶段搭建场景、角色和可交互物体。
第三阶段接入操控、碰撞、关卡推进和胜负逻辑。
第四阶段补全界面,并验收完整流程。
每个阶段都要通过检查才能进入下一阶段,交互部分要用真实输入试玩验证。资源缺失时用简单几何体代替,玩法保持不变。生成的游戏覆盖解谜、射击、驾驶、冒险、竞技场和格斗等类型。
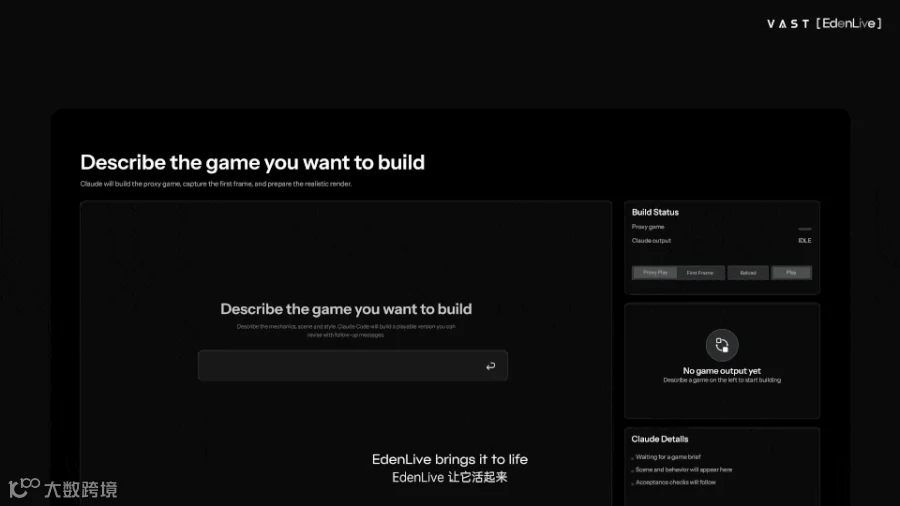
玩家用键鼠操作后,游戏程序计算碰撞、得分和胜负,更新状态,并渲染出灰盒画面;发生关键事件时,程序再生成一句描述,比如“一次命中”。EdenLive 根据灰盒画面、事件描述、目标首帧和提示词生成接下来的画面,玩家看到后再做下一步操作。
EdenLive 只通过灰盒画面和事件描述获知游戏状态,不需要为某一款游戏单独设计接口。
下面的演示中,画面主体由 EdenLive 生成,角落的小窗是游戏程序渲染的灰盒画面。
街头格斗:一记踢腿命中后,对手血量从 100 降到 83。
潜水艇寻宝:潜水艇抵达指定位置、抓起宝箱后,任务进度才标记为完成。
怪兽摧城:一栋楼在火焰中倒塌,破坏计数从 0/10 变为 1/10。
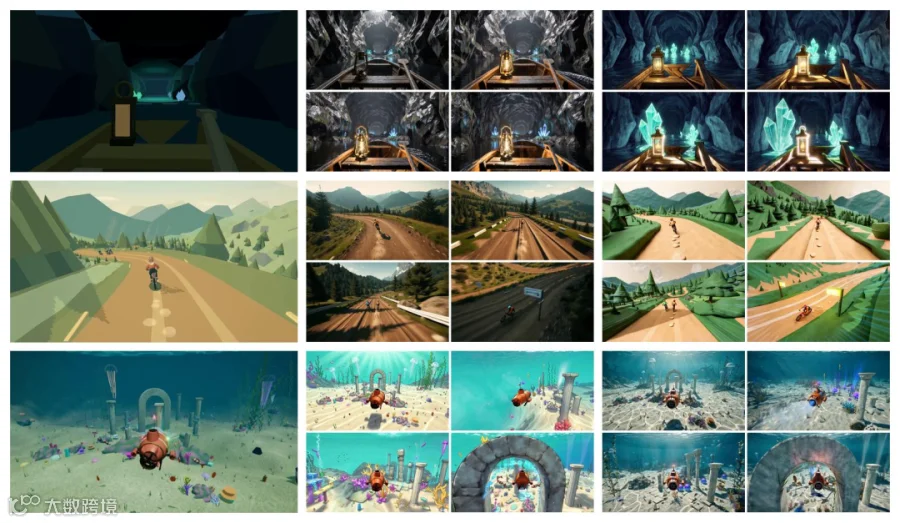
初始参考帧(左)在两种不同外观条件下、同一参考视频对应时刻生成的画面(中、右)。第二行和第三行的游戏输入分别来自 Imirushik 创作的 SUNBREAK 和 vasu-devs 创作的 Fishslop。
04
场景预览、视频重渲染与具身数据
场景与动画预览
EdenLive的输入参考可以是白模场景、美术制作的粗动画,或者由精细模型渲染出的法线图视频。参考保持不变,只换首帧和提示词,就能在同一个场景、同一段动画上比较不同的材质、光照和配色。

视频重渲染与风格化
实拍视频也可以直接作为参考,包括录好的视频和摄像头的实时画面。EdenLive 能够保留原视频里的动作和镜头运动,按首帧和提示词把画面改成卡通、像素风或油画风格,不需要先重建场景或制作 3D 资产。
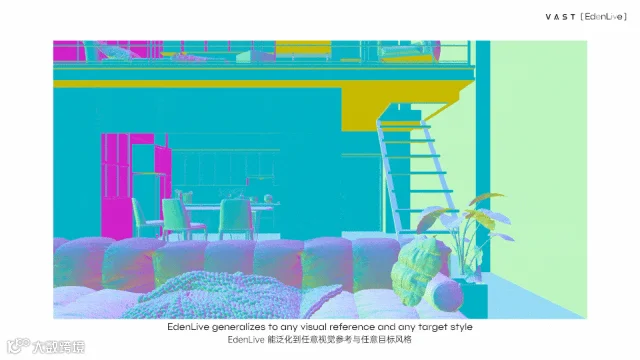
具身数据增强
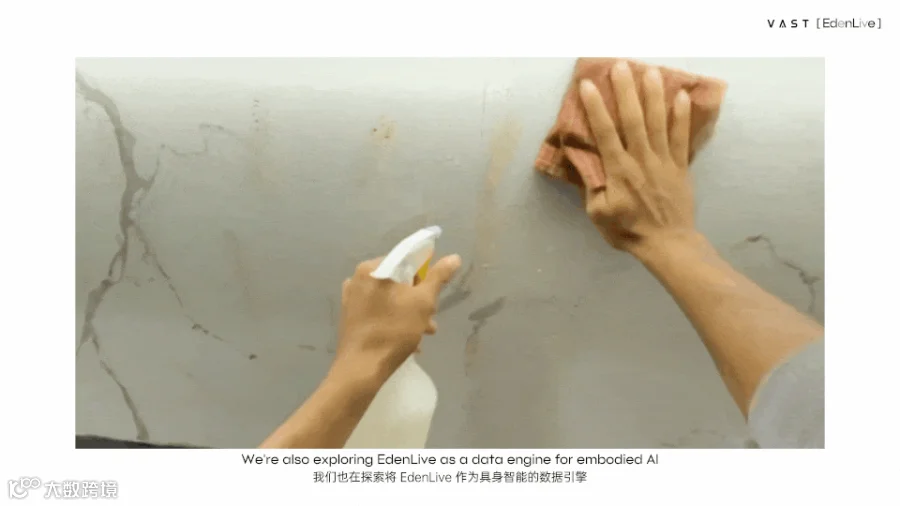
EdenLive 还可以用来做具身数据增强。输入一段第一人称的人手操作视频,用首帧和提示词把人手换成机械臂、换掉被操作的物体,或者改变物体的颜色和材质,动作和场景布局保持不变。一段已有的演示不用重新录制,就能扩展出多个视觉版本。
05
技术实现
EdenLive 的生成模型分别从 Wan2.2-TI2V-5B 和 Wan2.1-I2V-14B 初始化。参考视频先经过一个视觉编码器,提取出的特征作为生成模型的条件。编码器从 DINOv3 初始化,在大量「参考–目标」图像对上微调:每一对布局相同、外观不同,微调让两者得到相同的特征。
这样,灰盒画面和录制视频进入模型时只剩下布局和运动信息,生成结果就不容易退化成灰盒,也不容易照搬原视频的质感。在图像生成对比中,以粗糙图像为输入,微调后的编码器让结果与目标精细图像的 DreamSim 距离从 0.513 降到 0.368。
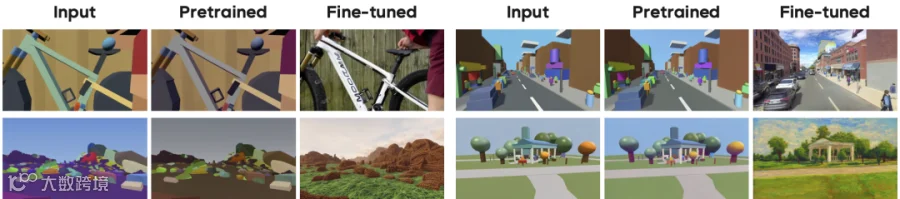
这个编码器还让普通视频可以直接用来训练。配对的参考–目标视频很难大量获得,现在参考和目标可以用同一段视频,只给参考一侧加外观扰动,模型就要靠结构和运动来还原目标。这些样本再和配对视频混合训练。
为了实时运行,我们把多步的双向扩散模型蒸馏成少步、逐块生成的自回归模型,每块去噪 4 步,只保留固定长度的历史。推理时,上游模拟、参考编码和生成按流水线并行,当前块生成时,下一块的参考已经在进行准备。
训练方法、数据筛选和推理优化的细节见技术报告(https://assets.vast-eden.ai/assets/edenlive/EdenLive-tech-report.pdf)。
06
评测结果
单张 H100 上,EdenLive 5B 在 832×480 分辨率下达到 73.5 FPS,1280×704 分辨率下达到 29.8 FPS。
模型配置 |
|
|
|
|
|
|
1 张 英伟达 H100 图形处理器 |
832×480 |
|
73.52 帧/秒 |
|
|
1 张 英伟达 H100 图形处理器 |
1280×704 |
|
29.80 帧/秒 |
|
|
8 张 英伟达 H100 图形处理器 |
832×480 |
|
26.76 帧/秒 |
注:表中均为模型侧推理吞吐。对比方法的几何图和语义图是预计算的,并且EdenLive 的参考编码计入了耗时。
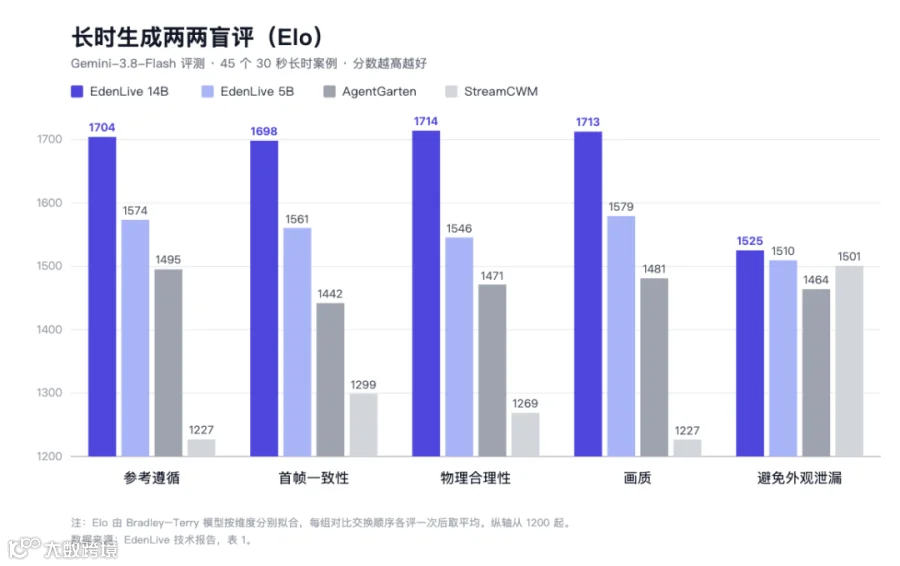
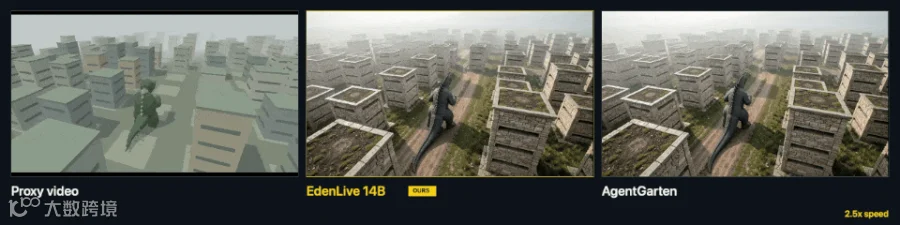
质量方面,我们在 30 秒长时生成上与同样支持流式生成的 AgentGarten 和 StreamCWM 对比。用 Gemini-3.8-Flash 对 45 个案例做两两盲评,每组交换顺序各评一次,EdenLive 14B 和 5B 在参考遵循、首帧一致性、物理合理性、画质和避免外观泄漏五个维度上都排在前两名。
客观指标上,14B 的相机旋转误差最低,首帧主体与背景一致性、文本对齐和主体时序一致性最高,画面美感随时间的衰减最小;5B 的技术画质得分(DOVER-Technical)最高。
07
下一步,更稳定的实时交互
灰盒里的方块该画成哪个角色,现在由模型自己判断,画面贴合参考的程度也是固定的。我们希望这两件事都能由用户来定,比如直接指定每个方块对应的角色,或者按需要调高、调低贴合程度。
场景结构由上游维护,细节外观则靠模型保留的一小段历史画面来记,所以角色离开画面很久再回来,或者镜头转回之前去过的地方,一些细节可能和之前对不上。我们打算让模型在这种时候能找回之前见过的细节。
08
走在共识之前
Project Eden 发布后不久,李飞飞教授在《Anatomy of World Models》中提出由规划器、模拟器和渲染器组成的世界模型框架,与 Project Eden 的三层划分相近。
8 月以来,Code World Model、Magpie、Programmable World Model、GameDirector 与 CoDeR、AgentGarten、Matrix-Game 4.0、Streaming Code World Model、SolarRenderer 相继发布,NVIDIA 的 StreamRender-H3 也是相近工作。
它们都把世界状态交给代码、游戏引擎或智能体维护,再用视频模型生成画面。
这些系统在状态和渲染器之间各自定了一种格式:
Code World Model 用深度图加语义 ID 图,Programmable World Model 用带状态的 3D 有向包围盒,AgentGarten 用深度图或法线图,StreamRender-H3 用语义分割图;Magpie 用 30 多个 Unreal 场景里采集的白盒画面训练渲染器,Matrix-Game 4.0 的渲染模型按场景分别训练。SolarRenderer 用一个模型处理灰盒、语义图、骨架、深度图和手绘草图等多种结构视频;但其生成一段数秒的视频需要数分钟。
EdenLive 用同一个模型处理灰盒、法线图、2D 游戏和实拍视频,并在单张 GPU 上实时运行。
09
开放构建,继续走向交互世界
EdenLive 的代码以 Apache-2.0 协议开源,5B 和 14B 两个规模的权重都已发布在 Hugging Face,5B 模型在单张 RTX 5090 上就能实时运行。配合前端工作台和 EdenGolem,可以从一段文字描述开始,生成可玩的灰盒游戏,再用 EdenLive 实时渲染。
本地部署之外,可以直接在 fal 和 Reactor 上试用 demo。3D 资产编辑平台 Unbound Loop 已把 EdenLive 接入产品,可以在 http://loop.unbound.io 中直接体验。同时也感谢 LightX2V 团队在 RTX 5090 推理优化上的支持。
我们诚邀研究者与开发者在 EdenLive 的基础上继续开发和改进,比如接入新的参考来源、尝试新的画风和交互方式。欢迎在 GitHub 上提交 issue 和 PR。
从Project Eden到EdenLive,我们的出发点没有改变:世界需要一份能够持续演化的状态,视觉渲染则成为观察它的方式。
如今,可运行的原型可以拥有更丰富的视觉表达,生成画面也开始参与持续发生的交互。
状态驱动世界,生成呈现世界,交互改变世界。
关于 VAST AI Research
VAST AI Research 致力于构建 3D 原生基座模型与世界模型。
更多信息请访问 www.tripo3d.ai/research,或关注 @VastAIResearch。
如果你对以下方向感兴趣,欢迎和我们聊聊或投递简历至vstar.talent@vastai3d.com。
3D Generative Models
探索下一代3D表征与生成范式,构建可扩展的三维生成基础模型
研究多模态条件下的三维生成与编辑,赋予生成对象可编辑的部件结构、运动能力与物理属性
推动研究成果转化为新的产品能力与体验,参与开源与开发者生态建设,探索互动内容、具身智能、设计制造等领域的新应用
3D Understanding & Agentic AI
研究三维对象与场景的理解和推理,理解其几何结构、部件功能与空间关系
探索智能体在复杂三维任务中的自主规划、执行与迭代,协同生成模型、程序化工具与代码完成任务
World Models
设计高效推理与新型基础模型架构,兼顾生成质量、实时性与交互体验
探索动态世界的生成与演化,研究场景结构、物体运动与交互行为的建模,以及长时交互中的一致性与可控性
我们提供上不封顶的薪酬、核心技术方向的主导权、专属大规模算力,以及面向长期高价值研究的专注科研环境。