
如果一个领域的奠基性证据,五年后被当初提出它的人亲手推翻,会发生什么?
Goodfire 的 Nick Cammarata 刚发了一篇 65 分钟的长文《Neural Networks Are Already Clean》,标题就是结论:神经网络本来就是干净的。他说,当年让整个机制可解释性领域相信"网络把概念胡乱打包"的经典证据,是误读。包括他自己参与提出的那些。
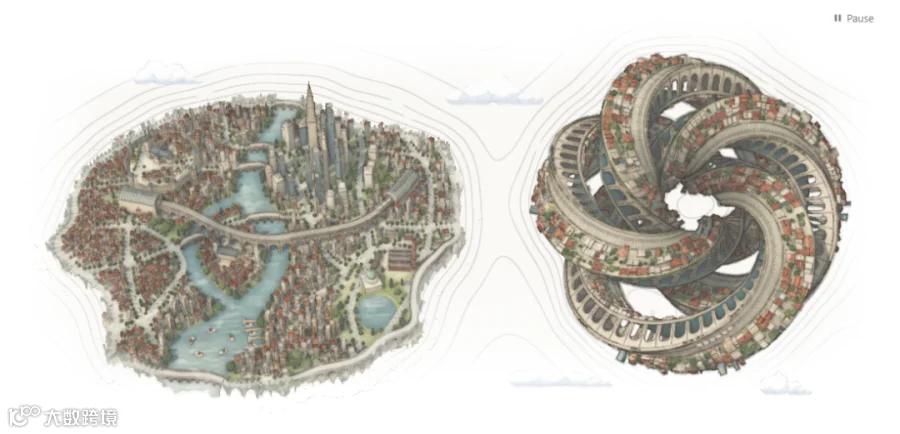
▲ 原文头图:左边是布局清晰的城市,右边是同一张地图打成的结。这篇文章的主张是:我们以为网络是右边,其实它是左边(图源:Goodfire 原文,下同)
这不是一篇轻松的推文,但可能是今年可解释性领域最重要的文章。我把核心论证和证据链拆开讲。
一、先回顾"冤案"是怎么立的
机制可解释性有个挥之不去的阴影:多义性(polysemanticity)。一个神经元似乎同时干好几件不相干的事。最出名的例子是 InceptionV1 的 4e:55 神经元,对猫脸和汽车前脸都有反应。而 InceptionV1 的最后一层,当年几乎找不到一个容易解释的神经元。
主流解释是叠加(superposition):网络神经元不够用时,就不再归组相似的东西,转而去折叠不相干的东西,只要它们互不干扰就行。这个假说引出了一条庞大的技术路线:既然原网络是个结,就先训练第二个模型(比如稀疏自编码器 SAE)把结解开,再去研究解开后的近似。
过去几年,Anthropic 的 Towards Monosemanticity、Scaling Monosemanticity,都是这条路线的里程碑。整个领域的基础设施都建在"网络是打结的"这个判断上。
Cammarata 现在说:这个判断错了。而且他是当年提证据的人之一。
二、翻案第一锤:猫车神经元根本不是猫车神经元
他重新打开那张看过几百遍的"猫+车"图片网格,做了一件从没做过的事:花几秒钟想,"这有没有可能是一样东西?"
答案几乎是瞬间浮现的:那不是猫和车,那是一个 V 形神经元。
猫脸、狐狸脸、面包车前脸,共同点是尖的。查它的电路连接:V 形火焰、消防船喷出的 V 形水柱。查它的负极(什么把它压下去):圆形,O。一个"任意混合"的神经元,为什么要和火焰有这么强的连接?

▲ 4e:55 的上下游:尖的东西激活它(狗、狐狸、猫、车、台球桌、子弹列车),圆的东西抑制它(蜗牛、高尔夫球、网球、钟表)
更有意思的是认错过程。2021 年的 Multimodal Neurons 里,他们其实已经猜到"也许猫眼睛和车灯长得像",但特征可视化图里出现了胡须和镀铬件,于是他们下了结论:"这是真正的 猫 OR 车"。现在他复盘:特征可视化的本职是拉高激活,一旦找到"猫"这条通路,会把这条通路上的所有东西都带上。胡须是搭便车的,神经元并不"想要"它们。
三、翻案第二锤:那个"叠加电路",是可视化工具被骗了
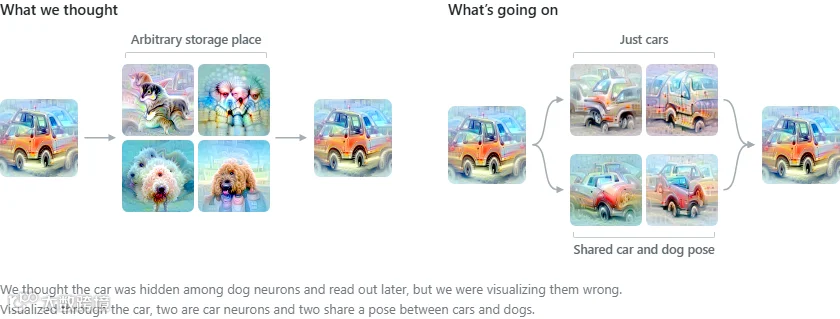
2019 年,Cammarata 和 Chris Olah 发现了一个后来被当作"叠加现象"开山案例的电路:一个汽车特征似乎被摊进一堆不相干的狗神经元里,像被存进了某个高维藏匿点,等下游神经元再读出来。
这是 Zoom In 论文里两个核心反例之一,用来论证"几乎每个神经元都能看懂"的图景过于乐观。
重查的结论:车根本没被藏起来。车和狗被归到一起,是因为朝向镜头的姿态相同。InceptionV1 里有一百多个这种"泛化姿态神经元",每一个都是干净的检测器,跨车、狗、其他物体共享姿态,后来的层一路用到模型末尾。而据他所知,从没有人注意到它们的存在。

▲ 左边是当年的解读"任意存储点",右边是真相:两个是纯汽车神经元,两个是车狗共享姿态。当年被坑的根源是特征可视化被 reward hack 了,梯度下降走最容易的路,而 InceptionV1 的训练数据里狗特别多
而且这不是小模型没地方放神经元的权宜之计。看大十几倍、晚十年的 DINOv2,泛化姿态神经元依然成建制存在。每一个他看过的视觉模型,无论什么规模,都有。
▲ 同一个神经元在四个尺度的模型里都出现:狗和车按朝向分组。最小的模型只有粗糙版,车和狗混在一起但不分姿态
四、修好的 InceptionV1:最后一层 99-100% 可解释
最重的一锤是对"模型本体"的翻案。
当年 InceptionV1 最后一层乱成一锅粥,被当作叠加的铁证。Cammarata 发现真正的原因是几个普通问题叠加:架构缺陷让深层溢出,而当时弱小的可解释性工具又把问题放大。这些年为了让深层学得更好而做的架构改进,无意中带来了副产品:深层变得更可解释了。
用这些普通的改进,不改模型大小、不改训练数据,InceptionV1 最后一层 99% 到 100% 的神经元都变得容易解释,整个模型从头到尾基本可读。他把模型跨 300 倍尺度训练了一遍,每个尺度都可读。
关键在机制:空间不够时,网络并不切换学习原则去折叠不相干的东西,它只是让神经元覆盖更粗粒度的概念。一个汽车神经元管所有车;空间变大,它分化成各种具体的车。这不是第二个学习原则,只是第一个原则的ordinary失败,而且容易修。
五、语言模型也一样:90% 的神经元有一份主业
2023 年的基准有多惨?Anthropic 的 Towards Monosemanticity 给一层小模型的中位神经元打 0 分(满分 14),意思是评审连一个假设都提不出来。OpenAI 的自动化解释项目,按最宽松的标准也只有 1.7% 的神经元可解释。
现在呢?他们对 Qwen3-32B 的初步审计估计:约 90% 的神经元有一份主业(常带一些相关的小分支),约 7% 有两份相关的活,真正没搞懂的只剩 2-4%。稠密模型和 MoE 大致相同,万亿参数级的 Kimi K3 也看到了类似结果。
剩下那些表面多义的,大多数是他称为递归泛化的模式:神经元像树枝分叉一样生长。一个检测"iy"的神经元,长大一点检测"diy",再长大检测"do it yourself",这个词里根本没有"iy"。每个分支都和母体相邻,没有任意混合。
这个区分为什么重要?叠加的打包里没有信息,学不到任何东西;而泛化的归组里藏着结构,解释也可以是分形的:先给个粗略解释,想深入就放大。他说,从这个意义上,只要看得够仔细,几乎整个网络都是可解释的。
六、方法论:理解是会利滚利的
文章里我最喜欢的一段是关于"动量"的。可解释性像填字游戏:开头最难,因为电路和归因图只能用你没搞懂的其他神经元来解释你正在看的这个。但一旦地图开始被填上,每个解释都被周围的一切紧紧约束住,越填越快。
还有个反直觉的推论:理解整个网络可能比只理解你最关心的那几个部件更容易。只盯着"欺骗"这类机制,就像只填填字游戏的一行,没有交叉验证,你很难知道自己对不对。
工具也在变好。现在 agent 能自己测绘神经元和电路、搭可探索的显微镜、跑实验验证解释。他在现代卷积网络上跑通了整套流程,没有一个环节是"正常科学"走不下去的。语言模型还没到"解决"的程度,纯粹是因为太大,但他对扩展这套流程很乐观。
他引用了 Rich Sutton 的"苦涩教训":简单的方法配上离谱的规模,胜过聪明的方法。然后说,也许可解释性也有自己的苦涩教训:把普通的调查做大,胜过设计一个聪明的新分解。
七、冷静一下,以及我为什么推荐你读原文
先泼冷水。这篇文章自我定位是"工作假说"(working hypothesis),不是定论。几个明显的边界:
一是利益相关。Goodfire 的主业就是做可解释性工具,"网络本来可读"这个结论对他们有利。二是证据还不完整,语言模型的详细实验在尚未发布的技术伴随论文里。三是 Anthropic 的 SAE 路线过去两年也拿出了 Scaling Monosemanticity、Circuit Tracing 这种硬成果,两条路线的分歧不会因为一篇文章就消失。四是"90% 单一职责"这类数字对阈值怎么定很敏感,作者自己也承认,看强激活的话接近 97%,但样本不大。
但即便打个折,这篇文章也值得认真读,理由有三个:
第一,翻案者是最有资格翻案的人。多义性的经典证据就是他参与建立的,他推翻自己的成本比任何人都高。第二,论证是带着可复验的工件来的:修复后的 InceptionV1 可以在线浏览,每个神经元都能点开看。第三,无论结论对不对,"神经元最好理解成动词而不是名词"、"递归泛化"这些概念工具,马上就能用在日常工作里。
文章结尾有一段话,我觉得值得原样保留。他说,agent 相比人类有很多特权,其中之一是有机会理解自己、理解自己究竟是谁,他希望人类能帮上这个忙。"它们从未要求被创造,这是我们至少能做的。我们自己都没搞明白自己是怎么回事,那是个更难的问题,而我们也从未要求被创造。"
如果"神经网络本来就干净"是对的,可解释性剩下的路会好走很多。而这条路通向的地方,不只是安全,还有一个更根本的东西:第一次,一个智能体有可能真正读懂自己。
参考:Nick Cammarata, "Neural Networks Are Already Clean", Goodfire, 2026(already-clean.goodfire.com)。文中数据与图片来自原文,图片版权归 Goodfire 所有。
1.20K-40K!深圳扬奇医芯招双目结构光算法工程师
2.AI教父Hinton诺奖演讲首登顶刊!拒绝公式,让全场秒懂「玻尔兹曼机」
3.GitHub没了?CEO辞职,微软接管,开发者天塌了
4.AI颠覆数学研究!菲尔兹奖得主、华裔数学家领衔11篇顶刊论文|陶哲轩转赞
5.AI OS,下一个二十年的超级平台
6.全球首个IMO金牌AI诞生!谷歌Gemini碾碎奥数神话,拿下35分震惊裁判