

论文标题:Pair-complete structural gating enables Pareto optimization of de novo cyclic peptides with preserved binding geometry and improved developability
作者团队:Yuanchao Hou, Yixin Zhang, Zhuoyan Liu, Xinfa Peng, Ziye Liu, Miyesier Yusupujiang, You Xu, Jiaxin Hu, Zhenming Liu & Shengwen Yang(石河子大学、北京大学、墨尔本大学等)
文章链接:https://doi.org/10.64898/2026.09.24.754053
引言:环肽药物设计的“鱼与熊掌”困境
蛋白质-蛋白质相互作用(PPI)界面通常具有平坦、宽阔且缺乏深邃结合口袋的特征,这使得传统小分子药物难以靶向。然而,环肽(Cyclic peptides)凭借其广阔的相互作用表面和构象刚性,成为攻克这些难成药靶点的理想化学实体。环肽不仅能有效契合PPI界面,其刚性骨架还赋予了更高的蛋白酶稳定性,某些大环骨架甚至能够通过被动渗透穿过细胞膜。
尽管近年来深度学习方法(如RFdiffusion和LigandMPNN等)极大地拓宽了靶向结合环肽的设计空间,能够生成高亲和力的结合几何构象,但一个极其现实的“成药性”(Developability)问题摆在研究者面前:一个结构上可信的结合体,往往在溶解度、膜通透性、非特异性相互作用或溶血毒性上表现不佳。更为致命的是,为了改善这些成药性属性而对序列进行的局部突变,往往会无意中破坏最初筛选出的精妙结合构象。
这种结构兼容性并非简单的线性叠加过程:两个单独存在时能维持结合构象的单点突变,如果在同一序列中组合,可能会引发空间位阻或极性排斥,导致结构崩溃。因此,如何在局部多属性优化的同时,精准保留靶点结合几何构象,是当前计算辅助药物设计领域亟待解决的核心问题。针对这一痛点,石河子大学与北京大学等机构的研究团队联合开发了RF-PepTune。该方法通过将“结构准入筛选”与“多属性帕累托搜索”彻底解耦,在引入成对完整结构门控机制(Pair-complete structural gating)的基础上,成功实现了在不牺牲结合构象的前提下对环肽序列的多维度深度优化。
核心方法:RF-PepTune 工作流解析
RF-PepTune的核心创新在于:它将“结构是否有资格进入优化池”与“属性得分孰高孰低”视为两个完全独立的决策过程。这就避免了优化算法为了盲目追求高属性得分而生成结构上不可行的“幻觉”序列。

图注:Fig. 1 | RF-PepTune 工作流程概述。结合靶点条件生成的环肽主链经过过滤后,分配初始父代序列。接着在不查询任何属性分数的情况下,在两个AlphaFold-Multimer模型参数化下进行单点突变(W1)及成对突变(W2)的结构筛选,构建成对完整的候选图谱。随后,通过帕累托蒙特卡洛树搜索(Pareto-MCTS)在图谱内进行多属性优化(通透性、溶解度、抗污性、低溶血性),最后输出序列将进行全序列结构重新评估。
具体而言,RF-PepTune的工作流程可以划分为三个紧密衔接的阶段:
-
1. 父代骨架生成与序列初始化:研究人员首先使用RFpeptides生成特定靶点条件约束下的头尾相连环肽主链,经过严格的过滤标准后,通过LigandMPNN为每个合格的主链设计一个固定的父代序列。这些序列将作为后续优化的起点。 -
2. 构建“属性盲”的成对完整准入图谱(W1与W2门控):在提取任何PepTune成药性分数之前,算法首先根据溶剂可及性等结构安全度指标,为每个父代序列挑选出6个可突变位点。这6个位点引入19种天然氨基酸,共产生114个非父代单点突变。RF-PepTune在结构工作流的两种参数化模型(Model 0和Model 1)下,对这114个突变进行全面筛选,所有通过绝对阈值(如pLDDT ≥ 70,iPAE ≤ 9.6 Å)和相对父代宽容度阈值的单点突变构成了W1准入集。紧接着,算法对W1集合中衍生出的所有不同位置的“突变对”进行同样的结构筛选,通过测试的突变对构成W2准入集。一个高阶序列状态只有在其所有的单点突变都属于W1,且所有组成的突变对都属于W2时,才被允许进入搜索图谱。 -
3. 帕累托蒙特卡洛树搜索(Pareto-MCTS):在确立了由结构约束的严格搜索空间后,算法运用Pareto-MCTS在该图谱内进行多属性探索。优化目标依赖于PepTune打分器预测的四个维度:膜通透性、溶解度、抗污性(Non-fouling)和低溶血性(Low hemolysis)。搜索过程中维护一个在线的ε-帕累托非支配解存档。搜索结束后,采用最大-最小(max-min)规则从中选择最终端点,并对该全序列进行最终的结构重评估。
核心结果分析
为了严谨地评估这种成对完整准入机制的贡献,研究团队在三个代表性靶点(MDM2、GABARAP和MCL1)上,针对334个父代序列展开了条件完全匹配的三臂对比实验。实验的三组分别为:无结构门控搜索(Ungated)、仅基于单点突变的门控搜索(W1-only),以及成对完整门控搜索(W1+W2)。
1. 成对完整门控机制大幅飙升“多属性-结构”联合成功率
评价优化的金标准是“联合模型定义的属性-结构成功率”,即不仅四个成药性维度的相对得分必须全部为正,且最终全序列必须在两种模型参数下均通过严苛的结构评估。
实验结果令人振奋:在无门控策略下,联合成功率仅为10.2%;引入单点突变W1门控后,成功率提升至51.5%;而引入成对完整门控(W1+W2)后,成功率飙升至77.5%!相较于仅W1门控,W1+W2策略带来了26.0个百分点的绝对提升。

图注:Fig. 2 | 匹配搜索条件下成对完整结构准入显著提高多属性-结构联合成功率。
a: 柱状图展示了三种策略(无门控、仅W1门控、W1+W2门控)在334个父代序列上的联合成功率对比,W1+W2门控成功率最高。
b: 堆叠图展示了不同门控策略下最终端点序列在四个评价象限(属性与结构是否双重达标)中的分布,W1+W2门控极大降低了“属性提升但结构失败”的比例。
c: 散点图按不同靶点(MDM2、GABARAP、MCL1)分层展示了联合成功率的差异,W1+W2在所有靶点中均表现最优。
d: 森林图展示了W1+W2策略相较于仅W1策略在不同靶点以及汇总数据上的配对风险差(显著的正向百分点提升)。
这种成功率的本质跃升源于对“欺骗性高分序列”的精准拦截。在无门控状态下,高达88.3%的端点序列在成药性上得分极高,但在随后的结构验证中崩溃失效(即Property+但Structure-)。W1+W2门控策略犹如一位严厉的守门人,将这类无效序列的比例大幅压缩至仅9.3%,真正实现了在合理的结构折叠框架内去优化物理化学属性。
2. 双重门控有效剔除不兼容组合并极大地收敛高阶搜索空间
为什么需要单独设置W2集合?因为单点突变的安全绝不等于组合突变的安全。数据显示,在由W1衍生的所有位置差异动作对中,有大量组合被W2残忍淘汰:在MDM2中淘汰比例的中位数为29.3%,GABARAP为34.5%,MCL1为25.1%。这些组合如果单独存在时均无害,但一旦结合在一起就会产生冲突,破坏原有的靶向构象。
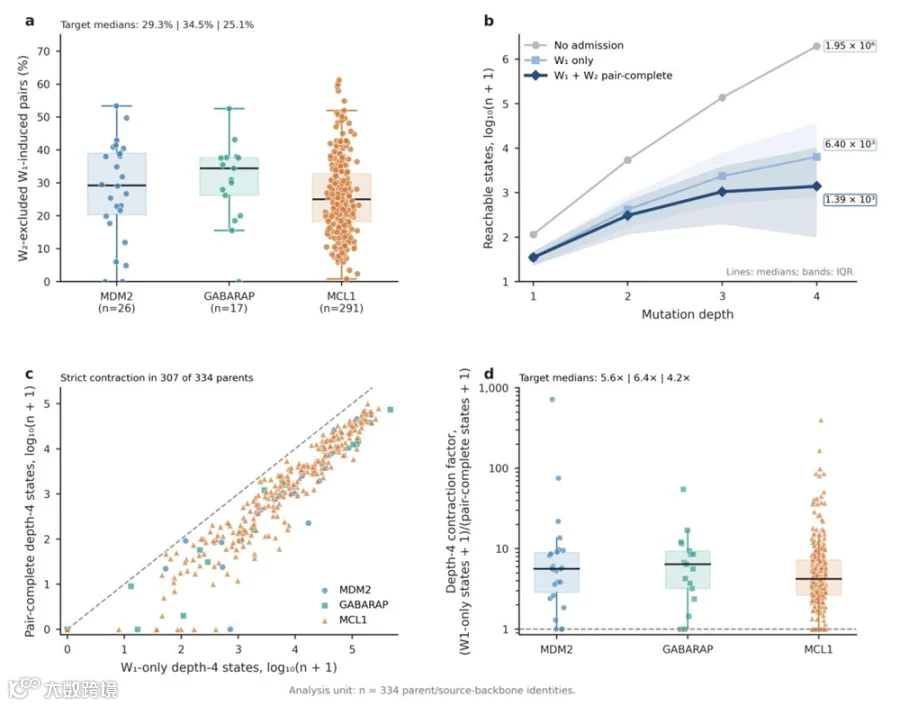
图注:Fig. 3 | 成对筛选剔除了不兼容的突变对并收缩了高阶可达空间。
a: 箱线图展示了不同靶点中被W1接受但被W2剔除的位置差异动作对的比例。
b: 折线图呈现了在无门控、仅W1门控和W1+W2门控策略下,随着突变深度增加(1-4),可达状态数量的变化趋势。
c: 散点图对比了在深度4时,每个父代在W1门控与W1+W2门控下的状态数量,多数数据点位于对角线下方,表明W1+W2进一步收缩了搜索空间。
d: 提琴图展示了不同靶点下每个父代在深度4时的收缩因子,收缩因子越大表示经过双重门控后的搜索空间压缩越显著。
这种淘汰效应在序列突变深度加深时引发了巨大的“收缩红利”。以突变深度为4的情况为例,无限制的组合解空间高达约195万个状态;仅仅经过W1过滤,空间中位数收缩至6,400;而经过W1+W2的成对完整过滤后,中位数进一步坍缩至1,389。相较于仅使用W1进行约束,W1+W2在MDM2、GABARAP和MCL1靶点上的搜索空间分别压缩了5.6倍、6.4倍和4.2倍。这意味着蒙特卡洛树搜索(MCTS)可以将宝贵的计算算力集中在一个高度浓缩且结构可靠的图谱中进行深耕,而不是在注定失败的死胡同里陷入局部极值。
3. 多属性全面提升:打破成药性优化的负面权衡魔咒
多目标分子优化最常面临的窘境是“按下葫芦浮起瓢”——为了提高溶解度而牺牲通透性,或者为了降低毒性而牺牲结合力。为了验证RF-PepTune是否克服了这一难题,研究团队独立选取了90个平衡靶点分布的优先输出端点序列(每个靶点30个)进行了深入的物理化学剖析。
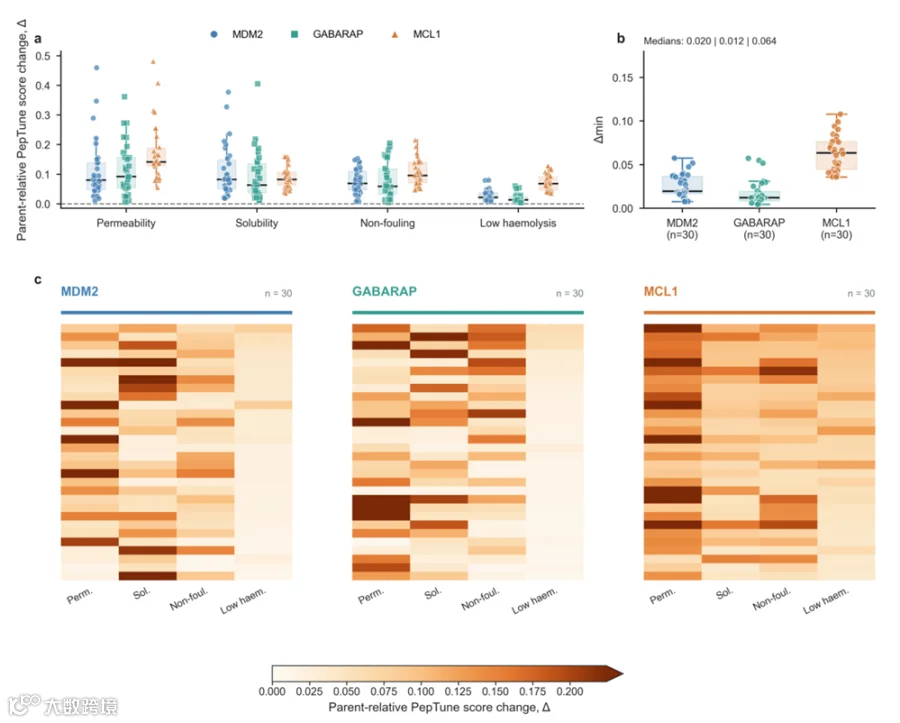
图注:Fig. 4 | 优先输出端点在没有负面权衡的情况下提高了所有四个模型原生属性分数。
a: 箱线-散点图展示了MDM2、GABARAP和MCL1三个靶点下,每个靶点30个优先输出序列在四个PepTune分数(通透性、溶解度、抗污性、低溶血性)上的相对父代的提升量。
b: 散点图展示了90个输出序列在四个属性中的最小提升值(Δmin),所有值均大于0,表明各属性得到了全面提升。
c: 热图直观地展示了三个靶点的90个序列在四项属性上的原始分数变化情况,按最小提升值降序排列,清晰反映了没有负面权衡的多属性协同优化效果。
令人瞩目的是,这90个输出序列展示了完美的帕累托前沿推进能力:所有的90个序列在通透性、溶解度、抗污性和低溶血性这四个属性上全部实现了正向增长。所有分数的最小提升值(Δmin)全部大于零(MDM2中位数为0.020,GABARAP为0.012,MCL1为0.064)。这充分证明了在结构安全的空间内,确实存在大量能够实现所有成药性维度共同提升的优异序列,而通过帕累托原理驱动的RF-PepTune能够精准地将它们挖掘出来。
4. 严苛结构审计:所有序列均维持完美结合几何
即便经历了深度的序列重排与多维度的属性优化,这些被挑选出的最终“候选者”在结合三维结构上的稳健性同样毋庸置疑。文章从90个端点中采用确定性排序(Δmin最大等规则)挑选出了三个极具代表性的复合物结构:MDM2靶向肽(突变E3K/L12F/E15P)、GABARAP靶向肽(突变S1P/E4N/L11M)以及MCL1靶向肽(突变S2P/V16P/T17K)。
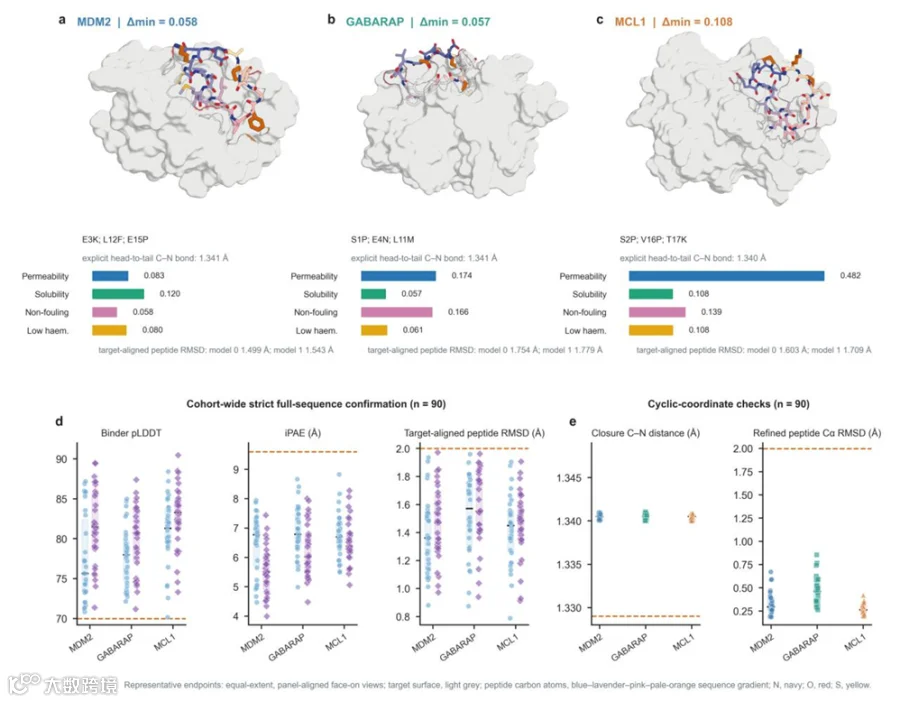
图注:Fig. 5 | 代表性环肽端点及90个优先输出序列的结构评估。
a-c: 展示了利用所选策略为MDM2(a)、GABARAP(b)和MCL1(c)生成的代表性端点复合物3D结构渲染图,图中高亮了显式的首尾相连C-N键及关键氨基酸突变位点。
d: 散点图汇报了90个优先输出序列在Model 0和Model 1下的pLDDT、界面预期对齐误差(iPAE)以及靶点对齐肽段RMSD,所有散点均优于预设的安全阈值虚线。
e: 散点图统计了90个序列在细化后的首尾C-N键距离和直接肽段Cα RMSD,所有结果均符合理想的几何约束与构象偏差限制,证实了环肽的正确闭合与结合构象保持。
严谨的结构指标全面审计结果显示,全部90个输出序列的Binder pLDDT分布在70.17至90.46之间,界面预期对齐误差(iPAE)在4.00至8.83 Å之间,靶点对齐后的多肽RMSD极度稳定地控制在0.789至1.972 Å。没有任何一个序列在两种参数的验证模型下掉落绝对或相对阈值安全线之外。此外,对坐标的严格构象审查(Coordinate audit)还显示,所有环肽的显式首尾连接C-N距离均严密维持在1.33997至1.34103 Å之间,完美展现了无可挑剔的大环几何闭合合理性与理化约束依从性。
总结与展望
RF-PepTune通过一种新颖且具备极高通用价值的算法框架,完美破解了环肽结构结合力与成药物理化学属性间的权衡博弈。该研究敏锐地指出:在多目标分子序列设计中,低阶突变的安全性能不仅能过滤掉单点致命错误,更能作为严格判定高阶序列状态能否“准入”搜索池的判据。
这种将“结构资格准入”设为绝对的前置第一道门槛,随后再依靠先进属性模型在内部进行“帕累托排序”的设计理念,不仅适用于环肽的局部多属性精修开发,更可泛化扩展至更广阔的从头设计多肽药物甚至大分子疗法的多维限制性优化任务中。未来伴随高通量合成与湿实验对通透性、溶血性等指标的直接实测验证,这种由结构与属性AI解耦式双轮驱动的设计引擎,有望直接加速新型多靶点治疗性环肽从小众探索发现走向广阔临床应用的进程。