稀疏线性注意力(SLA)是视频生成等长序列场景中降低注意力开销的关键技术,昇腾则为其在950系列产品上的落地提供了新架构支撑。本文围绕SLA在昇腾950系列产品上的硬件亲和性开发展开,系统阐述了其在昇腾训练与推理全流程中的优化实践。最终,在95%稀疏度下,SLA+Wan2.2-T2V-A14B模型以不足预训练成本千分之一的极低微调代价,实现了720p视频生成端到端加速3.4倍(相对Wan2.2-T2V-A14B)。
你有没有刷过AI短剧?每集不过几分钟,但剧情连贯、镜头流畅,仿佛一气呵成。而在屏幕的背后,事情远没有这么简单——每一幕的画面、人物、情节都必须无缝衔接。这一切,全要靠AI的“注意力”机制来维系。
然而,随着视频越做越长,AI需要“盯住”的信息会急剧膨胀,计算量随之呈平方级增长。这便是经典Transformer中全注意力机制的固有缺陷。
那能不能让AI学会“抓重点“ 或者“记摘要”?前者只筛选最重要的信息参与计算,后者则将信息压缩为精简的汇总。正是这个思路,催生了稀疏注意力与线性注意力两大优化路线的持续演进,而将两者融合使用的混合注意力方案,更是能带来2倍以上的端到端加速收益。
SLA是一种可训练的用于DiT模型的混合稀疏与线性注意力机制。其原理基于以下观察:DiT中的注意力权重可分解为两类:少量高秩的大权重+大量极低秩的权重。SLA对高秩部分使用稀疏注意力加速,对低秩部分使用线性注意力进行低秩加速(见图1)。计算方式如下,
 (1)
其中 是topk块稀疏注意力计算,当设置95%稀疏度时,
 的计算量较注意力机制减少95%。
 是线性注意力计算,
 是可学习参数。具体的计算逻辑见图2。

图1 注意力权重分解
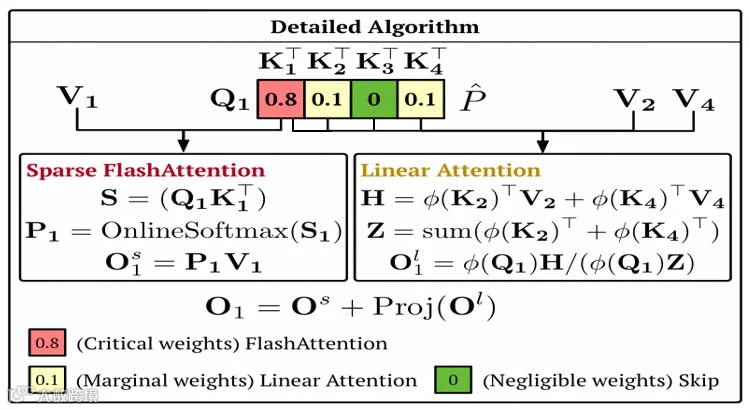
图2 SLA算法原理
核心挑战1:如何在昇腾AI基础软硬件平台上以极低微调成本实现SLA并达到95%以上的超高稀疏度;
核心挑战2:如何在昇腾平台上开发并优化SLA算子,以达成算法理论加速比,从而提升端到端的计算性能。
MindSpeed MM是面向大规模分布式训练的昇腾多模态大模型套件,支持业界主流多模态大模型训练,提供端到端的多模态训练解决方案。MindIE SD(Mind Inference Engine Stable Diffusion)是MindIE的视图生成推理模型套件,旨在为稳定扩散类模型提供在昇腾软硬件平台上的端到端推理解决方案。本文基于昇腾硬件接入MindSpeed MM和MindIE SD两个框架中的DiT模型后(图3(a)),即可在基于昇腾对SLA与视频生成模型进行微调和推理(图3(b)~(c))。

图3 SLA在昇腾上的训推流程
为了验证SLA在昇腾平台上的性能,本文基于Pexels部分数据展开Wan2.2-T2V-14B+SLA的微调实验,在8张昇腾卡下,使用8的训练批量大小,并对Wan2.2模型进行500步的微调。对于激活函数ϕ,本文选择论文使用的softmax。对于块大小,本文使用blkq=blkk=64。
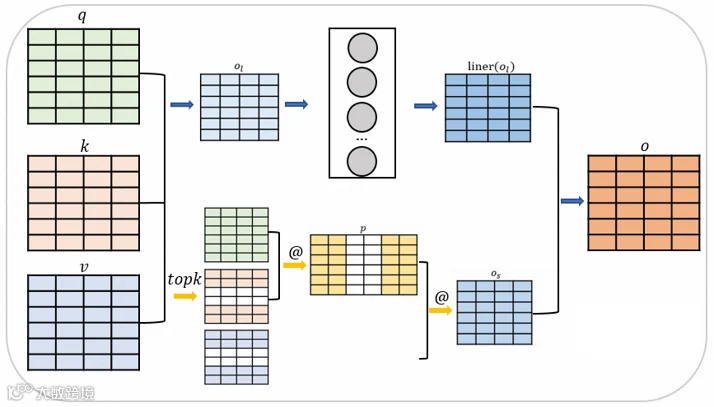
图4 SLA计算流
从公式(1)和图4上看,SLA分为 和
 两部分。其中,
 属于稠密计算,计算复杂度为
 ;
 通过Linear实现,同样为稠密计算,对昇腾天然亲和,且
 在SLA中占比较小。因此,本文使用torch小算子进行计算(图4中蓝色箭头)。对于耗时占比较大的
 部分,本文基于Triton-Ascend(图4中黄色箭头)对
 部分进行了Tiling、调整分核策略、减少数据搬运等优化,以开发出昇腾亲和的SLA。
Tiling:在视频生成场景下,传入SLA的序列长度通常超过30k(长序列场景)。通过调整 Tiling 策略,使数据搬运能够占满片上存储空间,从而减少搬运次数,提升性能。
分核策略:基于昇腾950系列产品的AI Core设计将分核的数量固定为硬件的物理核数,在核内做更为细致的数据分块。
扩展接口:Triton Ascend提供了扩展接口,能够更充分发挥算力。例如,在昇腾950系列产品硬件上,支持直接从UB复制数据到L1,避免了先由UB到GM、再由GM到L1的两次复制过程,显著提升数据复制效率。为此,文本通过 copy_from_ub_to_l1 接口实现数据从UB到L1的直接复制。
本文将微调后的模型部署于昇腾950系列产品进行视频生成,生成视频的质量评估结果见表1。
表1 SLA与基线VBench指标对比

IQ:Imaging Quality,评价图片的畸变程度:是否有过度曝光,噪音等;OC:Overall Consistency,使用视频-文本一致性计算作为辅助指标,反映语义和风格的一致性;AQ:Aesthetic Quality,评估每个视频帧的艺术性和美观价值;MS:Motion Smoothness,评估视频中生成的运动是否平滑,并遵循现实世界物理定律;SC:Subject Consistency,评估视频中主体(如人物、车辆等)的外观是否在不同帧中保持一致。


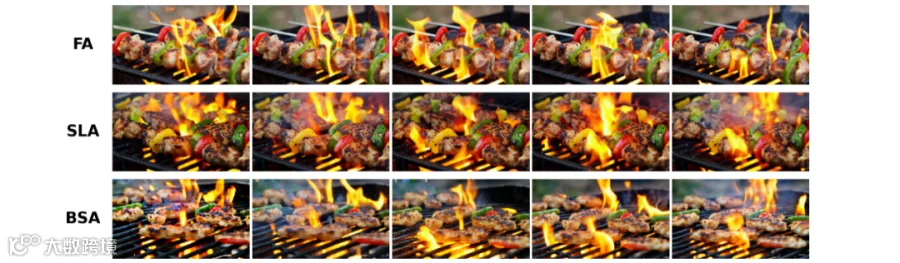
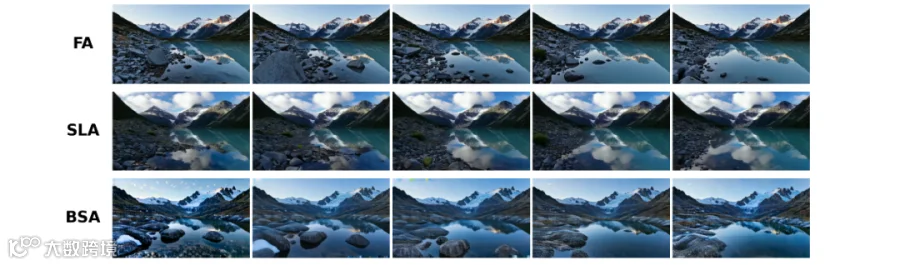
图5 由上至下的prompt依次是Timelapse of the northern lights dancing across the Arctic sky, stars twinkling, snow-covered landscape;The banks of the Thames, as the camera moves vertically from low to high;Extreme close-up of chicken and green pepper kebabs grilling on a barbeque with flames. Shallow focus and light smoke. vivid colours;A panning shot of a serene mountain landscape, slowly revealing snow-capped peaks, granite rocks and a crystal-clear lake reflecting the sky.
混合注意力通过加入线性注意力,有效改善了视频帧之间的连续性。在95%超高稀疏度下,SLA相比BSA有显著精度优势,各VBench指标均有所改善,与基线平均误差控制在1%以内。
为了验证经过2.3节中对SLA展开的优化效果,本文在昇腾950系列产品上进行了单算子、整网的性能验证。首先是单算子。

图6 SLA不同实现版本在昇腾950系列产品上的加速比
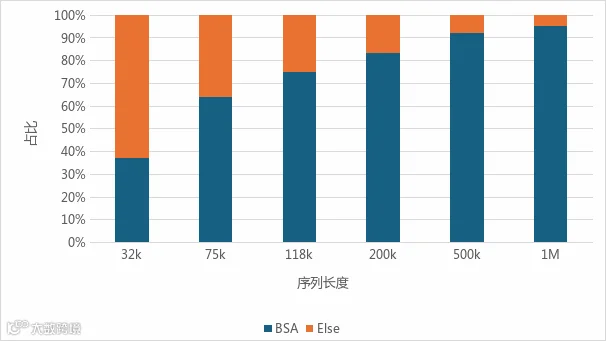
图7 不同序列下SLA中各个模块占比
图6中,FA / SLA-1是经过2.3节中Tiling与分核策略优化后的SLA较FA加速比;FA / SLA-2则进一步引入了Triton-Ascend扩展接口,通过细粒度流水优化获得;FA对应昇腾平台上FlashAttention2的性能表现。
对比FA / SLA-1与FA / SLA-2可知,仅依靠Tiling、分核策略等块级别上的优化,还不足以充分发挥硬件算力。针对昇腾950系列产品的新特性,需要通过Triton Ascend扩展接口进行使能,从而进一步压榨出极致性能,在32k~1M序列下,SLA-2较SLA-1进一步提升2x,cube利用率从40%提升至85%,vector利用率从67%提升至90%。
从图7可以看出,随着序列长度从32k增长至1M,SLA中 (对应图7中的BSA)的耗时占比持续上升,SLA相较FA的加速效果也愈发显著。在95%稀疏度下,
 的计算量减少95%,SLA对FA实现了7~18倍的加速比,已接近SLA算法的理论性能上限。
进一步本文将SLA-2接入MindIE SD,进行整网的性能分析,见图8。

图8 在不同视频生成场景中,SLA整网加速比
在480p、720p场景中,FA占整网比例分别为43%,66%左右,因此在SLA-2极致优化以及95%稀疏度下,480p、720p端到端分别加速1.8x,3.4x。
本工作在重点行业客户局点完成训练推理验证:训练单步耗时达成2倍加速,720p视频生成4步扩散,推理时长小于1min,顺利达成客户目标。
SLA在95%稀疏度下,已在实际视频生成任务中带来可观的性能提升。近期提出的SLA2通过新的微调方式将稀疏度进一步推高至97%,验证了混合注意力在提升稀疏度方面的潜力。本文也将继续通过软硬协同,探索混合注意力在更高稀疏度(如99%)下的应用。
项目开源链接
MindIE-SD:基于昇腾硬件的稳定扩散模型推理解决方案项目 - AtomGit | GitCode
https://gitcode.com/Ascend/MindIE-SD/pull/319