大数跨境

RSI突然火了:当AI开始改进自己,机器人也在把“部署”变成训练

RSI突然火了:当AI开始改进自己,机器人也在把“部署”变成训练 机器人产业应用
2026-10-20
5
导读:RSI是什么?模型会自我进化了?


作者:李振  


过去两年,具身智能最常见的叙事,是让机器人拥有更强的“大脑”。

VLA把视觉、语言和动作接起来,世界模型让机器人在行动之前预测未来,端侧芯片则想办法把越来越大的模型塞进机器人。无论发力点在哪里,基本逻辑都还是人收集数据、人训练模型,然后把训练好的模型交给机器人执行。但最近,一个更激进的词开始频繁出现:RSI,Recursive Self-Improvement,递归式自我改进。

今年,ICLR第一次举办专门的“AI with Recursive Self-Improvement”Workshop,会议介绍甚至直接写道:RSI正在“从思想实验走向实际部署系统”;9月,Dream-RSI、RSIAgent等工作又密集出现。更引人注意的是,Anthropic(美国人工智能公司)近期专门发布了一篇《When AI builds itself》,把“AI参与下一代AI的研发”放到了一个公开讨论的位置。听起来,这很容易让人联想到一个科幻版本的未来:AI修改自己的代码,训练出更强的自己,然后更强的自己继续训练下一代,最终形成“智能爆炸”。

但如果把今天的产业进展直接理解成这样,就走得太远了。真正值得关注的变化,不是AI已经学会了无限自我进化,而是原本由人掌控的“执行—评价—改进—再执行”链条,正在一段一段地交给AI。而当这条链条进入机器人,事情又变得更有意思,因为机器人拥有软件Agent没有的东西:一个真实的物理世界。


01

RSI不是“模型多反思几遍”,而是人正在逐渐退出改进闭环


RSI这个词最大的麻烦,是现在什么都容易被叫做“自我进化”。

模型回答完问题,再检查一次答案,可以叫Self-Refine;Agent记住一次失败,下次换一种工具,也可以叫自学习;机器人收集一批数据,工程师拿回来重新训练,同样可以被包装成“持续进化”。但这些事情离严格意义上的RSI还有很远。Anthropic给出的定义很强:当一个AI系统能够自主设计和开发自己的继任系统,才真正进入递归式自我改进。Anthropic同时明确强调,“我们还没有到那里”,RSI也并非必然发生。

今年一篇梳理2024—2026年1250篇论文的RSI综述,也专门试图解决这种概念混乱。作者发现,Self-Refine、Self-Reward、Self-Evolve等等词汇经常描述的是完全不同层级的能力,因此作者把它们按照“系统到底改了什么”和“人还在闭环里多少”重新分类。其结论同样比较克制:有边界的自我改进已经成为现实,而开放式RSI仍然受评价、模型退化、算力和研究方向选择等因素制约。


所以判断一个系统是不是在向RSI靠近,重点并不是它有没有使用“Self-Evolving”这个词,真正的问题是谁发现问题?谁提出改法?谁判断新版本更好?谁决定把它部署回去?只要其中最关键的几步仍然必须由人决定,闭环就还没有真正关上。


02

RSI为什么偏偏在今年火了?因为“执行”突然变得很便宜


RSI不是一个新概念。真正变化的,是AI第一次开始大量参与AI自身的生产过程。

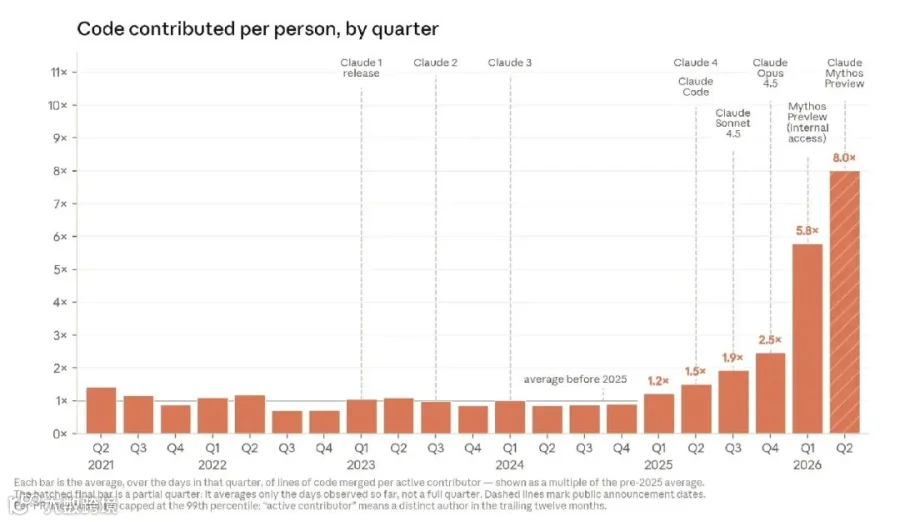
Anthropic披露,截至2026年5月,其合入生产代码中超过80%的代码行已经由Claude生成;2026年第二季度,典型工程师每天合入的代码量约为2024年的8倍。当然Anthropic也特别提醒,代码行数不能直接等同于8倍生产力,但趋势本身很明确:过去需要工程师亲手完成的大量实现、调试和实验工作,正在交给Agent。


更关键的是,AI已经不只是在写代码。Anthropic还做过一个小型模型训练优化实验:目标和正确性标准由人事先固定,模型自己改代码、运行实验、测速,再继续修改。2025年5月Claude Opus 4平均能把起始代码提速约3倍,到2026年4月内部模型在同一类实验中做到约52倍。这个数字同样不能理解成真实大模型训练整体提速52倍,但它展示了一种更重要的能力——AI已经可以独立跑一个“提出修改—实验—测量—继续修改”的循环。

这可能才是RSI最近真正升温的原因。以前最昂贵的是“做实验”,现在Agent可以同时写几十份代码、跑大量实验、搜索大量方案。于是研发中的稀缺资源开始发生变化:“怎么做”越来越便宜,“什么值得做、什么结果可信”反而越来越贵。这也解释了为什么RSI研究越来越关注一个过去并不显眼的问题——Verifier,评价器。一个系统如果不能可靠判断自己有没有变好,所谓“自我改进”很容易变成自我强化的错误循环。代码领域之所以跑得快,是因为它天然拥有编译器、单元测试、benchmark等外部反馈。那么机器人呢?


03

机器人恰好拥有最真实的Verifier,但也拥有最昂贵的失败


把杯子拿起来没有?灯泡拧进去没有?箱子送到指定位置没有?机器人完成大量物理任务之后,其实存在一个软件Agent非常羡慕的东西:现实世界会直接告诉它,刚才那一步到底成没成功,这使具身智能天然适合做自我改进。过去的机器人训练流程大致是:收集数据 → 训练模型 → 部署机器人。而RSI思路真正进入具身之后,链条可能变成:训练 → 部署 → 机器人产生新经验 → 判断成功和失败 → 更新策略 → 再部署。部署不再是训练的终点,而成为下一轮训练的起点。

但物理世界同时也是最残酷的限制。软件Agent一次实验失败,最多浪费几秒算力;机器人一次错误动作,可能意味着碰撞、摔倒、零件磨损,甚至伤到人。代码可以一晚上并行跑一万次实验,而真实机器人不可能用同样速度试错。所以,具身RSI有一个非常特别的矛盾:它拥有最可信的反馈,却拥有最昂贵的反馈。

这也是为什么世界模型突然变得重要。机器人不一定要把所有错误都拿到真实世界里试。它可以先在模型中“想象”多个动作的后果,由评价器筛掉明显错误的方案,再把少数候选动作交给真实机器人验证。从这个角度看,世界模型不仅是在帮助机器人“预测未来”。它还可能成为降低自我改进成本的内部实验场。


04

从1X到Motus2,具身公司的“自进化”已经走到哪一步?


目前真正需要谨慎的一点是:具身公司说的“自学习”“自进化”,并不等于Anthropic定义下的完整RSI。但一些系统确实已经开始把过去断开的环节接起来,1X就是比较典型的例子。

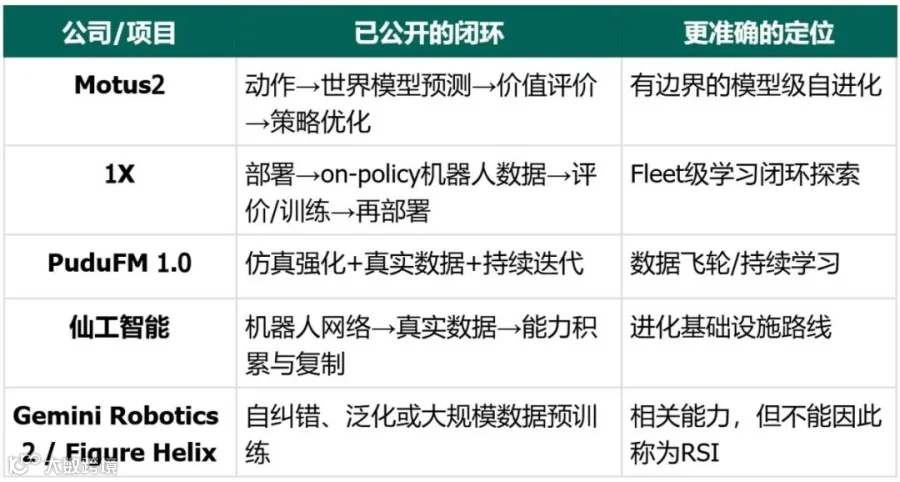
今年6月,1X正式成立World Model Lab,并把自己的路线写得非常直接:Web视频、第一视角人类视频、仿真、遥操作数据和NEO自身的on-policy数据进入训练,模型重新部署到真实机器人,再继续产生下一批数据。1X称自己希望连接从预训练、机器人学习、评价、部署到真实机器人数据收集的“完整学习闭环”。这是公司公开路线,并不能证明机器人已经能够自主决定怎样修改模型,但它已经把“机器人部署后的经验”正式变成模型迭代的一部分。


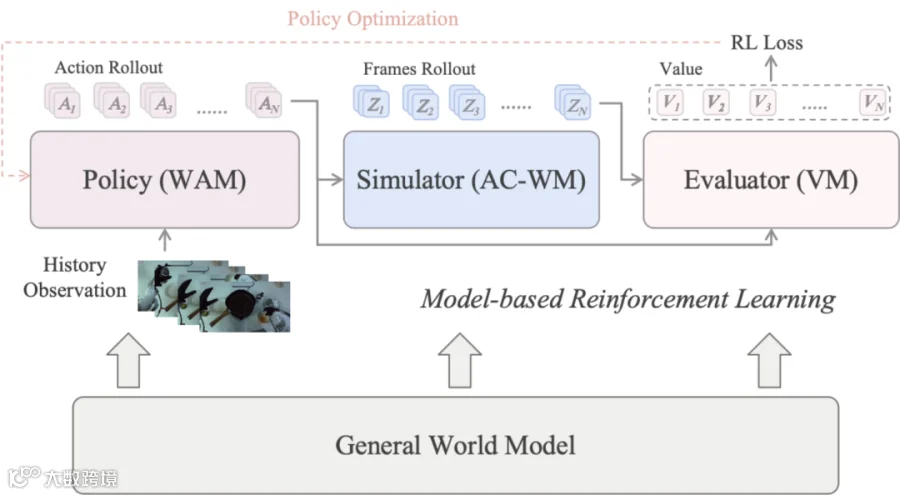
而近期的Motus2,把这个闭环做得更“模型化”。Motus2由生数科技相关团队与清华研究人员共同完成,它在同一个共享参数模型里暴露出三个接口:Policy负责提出候选动作,Simulator预测动作后的未来画面,Evaluator判断哪个结果更好;评价信号随后又可以通过Model-Based RL反过来优化Policy。失败和次优轨迹不再只是被丢弃的数据,而被用于学习动力学和价值判断。需要强调的是,这是论文和项目实验中实现的有边界自进化闭环,并不是机器人已经可以自主研发下一代Motus2。


另外一类公司走的是“规模化数据飞轮”。普渡今年发布PuduFM 1.0,将自己的路线描述为“自进化”,包括世界模拟器中的强化学习、真实场景中的人类干预数据以及持续模型迭代;其D7也加入了端到端数据采集架构。普渡公开披露已有超过13万台机器人部署,因此它的优势更像是:先有大量真实设备,再尝试把这些设备变成模型持续进化的数据入口。 不过目前公开信息主要来自公司自身,尚不足以说明整个模型更新流程已经实现自主闭环。


仙工智能提出的“机器人脑+真实数据基础设施+百万机器人进化网络”也是类似逻辑:让大规模部署节点持续积累经验,再把能力向更多机器人复制。但目前它更多还是产业战略和基础设施路线,不能直接视为已有完整RSI系统。


Google Gemini Robotics 2能够在任务失败后重新规划,也可以快速适应新机器人;Figure则在用Index大规模收集人类真实行为数据训练Helix。但前者主要是推理时自纠错与泛化,后者主要是数据规模化与预训练。公开资料都不足以证明系统会根据自身部署结果自主修改下一代模型,因此不能因为机器人“会适应”就全部叫RSI。


05

RSI进入具身之后,真正争夺的可能不是“谁的数据更多”


过去一年,机器人行业最大的焦虑之一是数据。谁拥有更多数据,谁能建立更大的真实机器人数据集,谁就可能训练出更强的VLA。但RSI带来的变化是:数据量本身可能不再是最终指标。

假设两家公司各有1万台机器人,第一家公司每天收回海量视频,然后由工程师清洗、标注、重新训练,一个月发布一次模型。第二家公司能够自动发现失败、判断哪些失败最有价值,在世界模型里重放和搜索,再经过安全验证快速形成新策略,一周完成一次升级。那么真正拉开差距的,就不只是“谁有1万台机器人”,而是每一台机器人产生的经验,多久能够重新变成全体机器人的能力。这会让具身智能出现一种很像互联网产品、又不完全一样的竞争逻辑。

软件时代讲用户飞轮:用户越多,数据越多,产品越好。具身时代则可能出现机器人学习飞轮:机器人越多,遇到的长尾场景越多;失败越多,改进信号越丰富;新能力再部署到整个机器人网络,又产生更高质量的新经验。但这里还有一道不能绕过去的门槛——谁来判断“这一次真的变好了”?

RSI综述指出,自我改进越依赖可靠的外部Verifier,证据通常越强;如果只是让模型自己评价自己,就容易出现自我确认、数据多样性下降甚至模型退化。对机器人而言,这个问题会更加严格。一套新策略在模拟器里成功,不代表真实世界成功;抓取成功率提高,也可能以更大冲击力、更高电机温度或更差安全性为代价。

因此,真正的具身RSI绝不会只是“让机器人在线修改权重”。至少在相当长时间里,它更可能以一种Fleet-level RSI出现:机器人负责执行和采集经验,世界模型负责低成本试错,评价器筛选改进方向,中央训练系统更新模型,再经过安全验证部署到机器人网络。

人不会突然消失,而是从“教机器人每一个动作”,慢慢退到“定义什么叫更好、什么绝对不能做”。过去,机器人部署意味着一件事情结束了:模型训练完了,现在把它装进机器。而RSI真正值得关注的地方,是它可能把这句话倒过来:机器人一旦被部署,下一轮训练才刚刚开始。这也是为什么RSI与具身智能的结合,比“机器人会自己学习”这句宣传语更值得讨论。

现阶段我们还远没有看到一台机器人能够自主研发自己的下一代“大脑”,更没有证据证明开放式RSI已经发生。但一个更现实的变化已经开始:模型不再只是从人类留下的数据中学习,也开始从自己的行动、自己的失败、自己的预测和真实世界给出的反馈中学习。如果这个闭环最终能够真正转起来,未来具身公司的护城河可能会从“谁拥有最多训练数据”,进一步变成谁能让真实世界里的每一次失败,更快、更安全地变成下一次成功。


连界创新


推荐阅读


产业应用场景


·出海!中国具身智能企业在全球市场大“杀”四方!

·比人形更快进入家庭?具身智能宠物机器人迎爆发!

·文娱巨星!人形机器人“表演大乱斗”,谁赢了?

·商业导览成具身智能商业化破局点?

·巡检机器人之困,场景刚需,但这一问题亟待解决


机器人本体企业


·仿生机器人=伴侣机器人?一文为仿生机器人正名!

·乐聚Taskor,为人形机器人规模化进厂按下“快进键”

·具身智能争霸赛打响!四大核心区都有哪些“扛把子”?

·CES 2026|星动纪元携人形机器人家族亮相

·智元CES放大招!开源Genie Sim 3.0强的可怕!


供应链动态


·零部件企业跨界突围!这些企业上大分!

·夺取物理世界的入场券:具身智能操作系统拆解

·人形机器人关节生死局:执行器路线之争与技术博弈

·灵巧手赛道“激战”,新老玩家各执什么王牌?
·开源数据集图鉴!这份具身智能“军火库”请查收

【声明】内容源于网络
0
0
机器人产业应用
由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
内容 594
粉丝 0
机器人产业应用 由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
总阅读7.1k
粉丝0
内容594