

终端智能体的能力评估,不仅要看回答是否合理,还需要在真实执行环境中完成任务,并通过验证器的检验。
SWE-bench、Terminal-Bench等基准要求AI检查代码、修复依赖,而长程任务更考验其能否将局部进展转化为完整解决方案。然而,现有训练方法仍面临三大挑战:长轨迹中的信用分配、递归训练中的价值漂移,以及局部奖励与完整任务成功之间的错位。
针对这些问题,腾讯Hy Frontier联合新加坡国立大学等提出了Terminal-RSI训练框架,探索通过递归训练持续改进终端智能体的执行能力。
研究团队以Qwen3.8-27B为基础模型,经过两轮递归自我重写(RSR)与策略精炼(RPR),最终训练得到Terminal-RSI-27B终端智能体模型。在Terminal-Bench 2.1上,该模型取得86.52%的成功率,高于GPT-6 Sol(85.40%)和Kimi K3(85.00%)参考成绩,与GPT-5.6 Sol的87.30%也较为接近。

这表明,通过递归积累成功经验并持续优化执行策略,27B规模的模型也能在特定终端任务基准上达到与前沿模型有竞争力的水平。
01
构建递归自进化闭环
Terminal-RSI训练框架并非简单地将监督微调(SFT)与强化学习(RL)串联,而是通过五个阶段交替推进,逐步积累成功行为并优化执行策略。
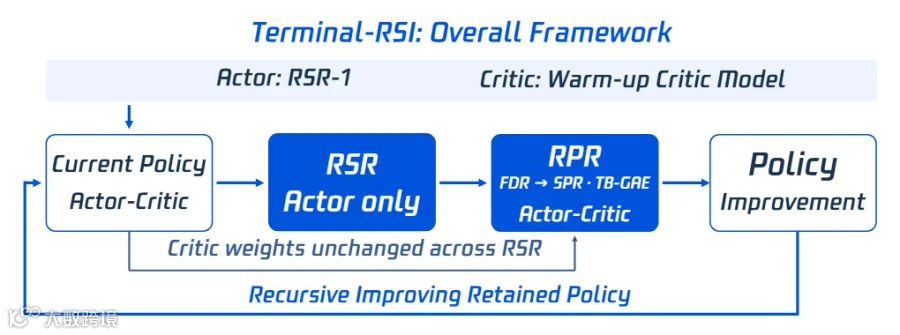
图注: 递归循环在监督训练阶段之间保留 Critic 的权重。蓝色模块用于区分仅更新 Actor 的 RSR 阶段与联合更新 Actor 和 Critic 的 RPR 阶段;旁路机制用于保留 Critic,反馈路径则将保留的策略传递至下一轮循环。初始 Actor 为 RSR-1 阶段的策略模型;Warm-up Critic Model 指经过预先训练、用于后续优化的价值网络。
第一阶段是基础模型Base。
研究团队以Qwen3.8-27B为起点,构建终端任务执行与验证流程。每个任务包含公开指令、执行环境和受保护的验证器,只有通过完整验证器,才算严格完成任务,而不是仅凭智能体自行宣称完成或部分检查通过来判断。
第二阶段是RSR-1,即首次递归自我重写。
智能体先在互补的执行框架中发现成功轨迹,规划器再基于这些轨迹生成可复用的执行手册(runbook);审查器只看到公共任务描述和手册内容,对其结构、产物与兼容性进行二值门控。
通过审查的手册随后在目标执行框架中由智能体重新执行,只有同时通过受保护验证器与信息泄漏筛查的新轨迹,才会进入监督训练集。
这一过程模型学习的是经过筛选、重新执行与验证的成功行为。RSR阶段只更新策略模型Actor,Critic参数保持不变,从而在积累新监督经验的同时,保留已有的价值估计。
第三阶段是RPR-1,即首次递归策略精炼。
研究团队冻结RSR-1的Actor,先使用一个SWR训练轮次准备预热价值模型(Warm-up Critic Model),再进行四次仅更新Critic的阶段内校准,随后联合优化Actor与Critic。该阶段采用家族密集奖励(Family Dense Reward,FDR),并通过近端策略优化(PPO)更新策略。
第四阶段是RSR-2。
团队再次发现、改写并验证成功轨迹,在上一轮基础上扩充高质量监督数据。与重新初始化Critic不同,这一阶段继续保留RPR-1阶段的Critic参数。
第五阶段是RPR-2。
研究团队继承上一轮的价值模型,进行四次Critic单独校准后再联合训练。相较 RPR-1,Actor 学习率从 5×10⁻⁷ 降至 1×10⁻⁷,降低五倍,而 Critic 学习率维持在 1.5×10⁻⁵。
表1: 策略精炼阶段在保持 Critic 学习率不变的同时,调整策略更新幅度。两阶段共用的训练设置列于下方;普通 RPR-2 分支使用 FDR 奖励,而非 SPR。

这种安排旨在减少策略更新对继承价值估计的冲击。研究团队最终保留的RPR-2分支采用成功优先奖励(Success-Prioritized Reward,SPR),同时也对采用FDR的另一训练分支进行了比较。
在奖励设计上,FDR用于根据不同任务家族的检查项规模校准语义进度奖励;SPR则将严格成功与有界的部分进度奖励区分开来,使失败轨迹的奖励低于1,而严格成功轨迹的奖励至少为1,从而提高完整任务完成在奖励排序中的优先级。
研究团队还提出了跨交互轮次的跳过观察广义优势估计(Turn-Boundary Skip-Observation GAE,TB-GAE)。该方法保留Token级价值基线,但不让观察文本成为优势递归的节点,并在跨越交互轮次时施加折扣与迹衰减,以减少信用分配对观察文本长度的依赖。

图注:轨迹重写与策略精炼更新不同的模型参数。左侧分支负责发现、重写并验证用于训练 Actor 的示范轨迹;递归策略精炼(RPR)则将继承的价值模型、奖励校准机制与跨交互轮次的跳过观察广义优势估计(TB-GAE)相结合。阶段内 Critic 校准包括联合训练前进行的四次仅更新 Critic 的操作,而不是在每个 PPO 小批次训练之前进行。
通过上述设计,RSR负责发现、验证并固化有效行为,RPR负责继承和校准价值模型,再利用强化学习优化策略。两者交替形成递归改进闭环,让后续训练能够建立在前一阶段积累的经验之上。
02
五个阶段的性能持续提升
Terminal-RSI训练框架最直观的结果,是从基础模型开始,经过 RSR 与 RPR 交替训练后,四项 Terminal-Bench 基准的等权平均成功率从20.68%提升到50.58%,增加29.90个百分点。五个阶段的平均成功率依次为20.68%、34.25%、44.50%、48.75%和50.58%。

图注:平均成功率的阶段性变化。
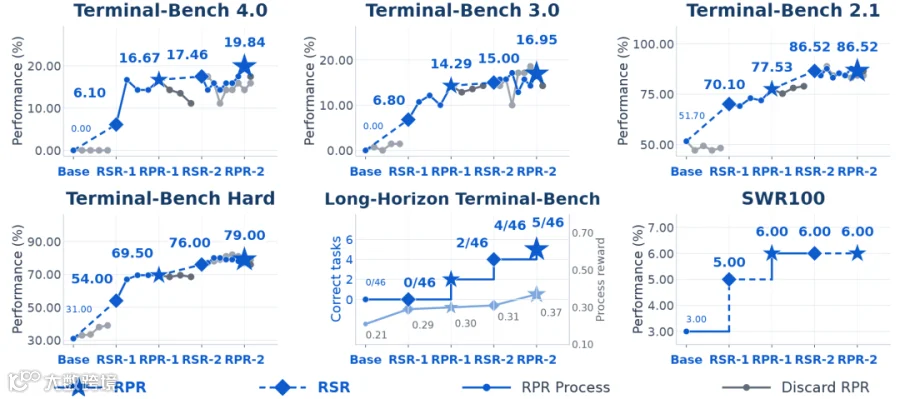
从各阶段的变化可以看到,RSR与RPR承担着不同的作用。首次 RSR-1 阶段,四项基准均取得提升,说明经过筛选与验证的成功轨迹能够为策略提供有效的监督信号。随后,RPR-1在四项基准上继续提高成功率,其中 Terminal-Bench 4.0 从6.10%升至16.67%,Terminal-Bench Hard 从54.00%升至69.50%。
第二轮 RSR-2 继续带来增益,Terminal-Bench 2.1 从77.53%升至86.52%,Hard从69.50%升至76.00%。最后的 RPR-2 又将4.0、3.0和Hard分别提升至19.84%、16.95%和79.00%,而2.1维持86.52%。
表2: 保留的训练阶段序列在所有基准上均取得了优于基础模型(Base)的成绩

这组结果说明,监督重写与策略精炼的交替训练在整体上有效,但收益并非每个阶段、每项基准都同步增长。尤其是 Terminal-Bench 2.1 在最后阶段持平,表明第二轮强化学习的价值更体现在其他基准上的继续提升,而非所有任务都获得额外增益。
03
27B模型追赶前沿
研究团队还将Terminal-RSI-27B模型与多种前沿模型的参考成绩进行比较。在 Terminal-Bench 4.0 上,Terminal-RSI-27B取得19.84%,略高于 Gemini 3.8 Flash 的19.70%和 DeepSeek V4 Pro 的14.60%。

图注:Terminal-RSI-27B与前沿模型在终端智能体任务基准上的性能对比。
在 Terminal-Bench 2.1 上,Terminal-RSI-27B取得86.52%,高于图中 GPT-6 Sol 的85.40%和 Kimi K3 的85.00%,但低于 GPT-6 Astra、Claude Opus 5、Gemini 3.8 Flash和GPT-5.6 Sol等模型。
04
长程任务
LHTB是检验Terminal-RSI框架是否真正提升长程执行能力的重要基准。它要求智能体修复存在问题的项目,处理跨多个步骤的依赖关系,并通过隐藏压力测试。部分子任务通过,并不意味着整个项目已经完成。

图注: 五阶段辅助评估显示,模型在长程终端任务基准 LHTB 上持续取得进展,而在 SWR100 上则进入性能平台期。
实验结果显示,Base阶段的过程奖励为0.21,严格完成任务数为0/46;RSR-1将过程奖励提升至0.29,但严格完成数仍为0/46。这说明模型可以取得更多局部进展,却未必能够将这些进展转化为完整解决方案。
经过 RPR-1,严格完成数升至2/46;RSR-2进一步升至4/46;最终 Terminal-RSI-27B达到5/46,过程奖励也升至0.37。
从Base到最终模型,过程奖励相对提升约76.19%,严格完成任务数则从0增至5。
这一结果揭示了论文关注的关键问题,衡量长程智能体不能只看完成了多少局部检查,还要看它是否真正满足完整的执行契约。
在SWR100上,模型成功率则由Base的3.00%提升至RSR-1的5.00%,并在RPR-1后达到6.00%,后续两个阶段维持这一水平。由于该基准与训练任务池没有任务重叠,这一结果表明模型在科学工作流重建任务上也取得了一定泛化收益,但后续阶段的表现已经出现平台期。
END
关注+星标,获取AI前沿进展与开源一线动态