

小米智驾核心人物陈龙,正在开启职业生涯的新篇章。
2025年3月,陈龙加入小米,负责辅助驾驶 VLA 技术研发,随后担任小米汽车主任科学家,主导具身基座大模型 Xiaomi MiMo-Embodied 的研发,并推动 XLA 认知大模型落地量产。2026年3月,XLA 随新一代小米 SU7 正式发布,将大模型的语义理解与推理能力进一步引入辅助驾驶。
而在离开小米、奔赴创业之际,陈龙参与的一项研究也有了新进展:OneVL 已被 NeurIPS 2026 接收。

车辆面对行人过街、临时车道或拥挤路口时,需要及时给出轨迹。模型为什么选择让行、转弯或保持车道,也关系到后续分析与调试。完整推理文本容易检查,却会增加生成时间;直接预测轨迹更快,中间判断又不容易观察。
OneVL 将语言与未来画面用于训练紧凑的潜在表示,并允许在需要时恢复这两类解释。论文还探索了一个 MLP 轨迹预测版本,在 NAVSIM 上达到 0.24 秒延迟、86.83 的 PDM-score。这是一项面向低延迟预测的实验结果,语言解释和未来画面的按需生成属于另外的调用过程。
01
路线选择,需要和场景中
的对象对应起来
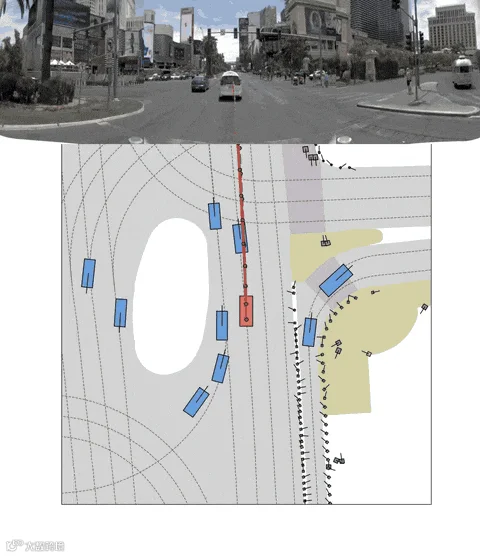
在一个转弯场景中,模型需要判断可行驶区域怎样延伸,车辆是否靠近道路边界,以及转向后会看到什么。只给出一个方向词,无法说明这些判断是否一致。
OneVL 的原论文将前视图、鸟瞰图、语言解释和预测后续画面放在同一个例子中。绿色与红色分别表示真实参考轨迹和模型预测轨迹,可以观察路线偏差发生在哪个位置。

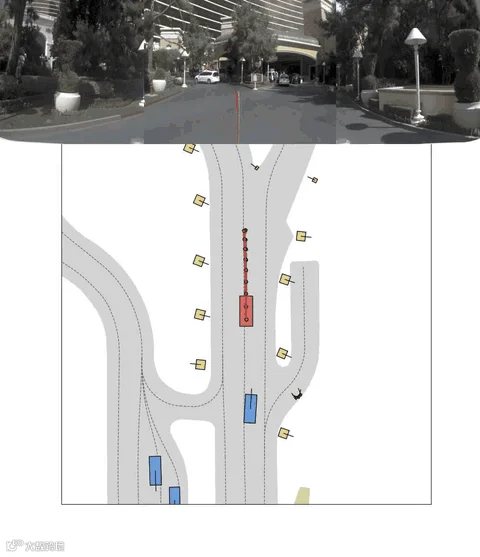
项目主页的 NAVSIM 日志演示进一步展示了道路画面和鸟瞰预测随记录场景变化的情况。它们提供的是预测可视化,适合检查空间关系与轨迹变化。
02
临时道路条件,会增加
哪些判断要求?
施工路段可能用交通锥改变车道边界,临时标志也可能要求车辆偏离常规路线。模型需要把这些局部条件与规划结合,不能只依赖熟悉的道路外观。
论文的 ROADWork 评测专门覆盖施工区域。OneVL 的平均位移误差为12.49 像素,显式思维链基线为13.18 像素。定性例子还展示了预测画面与文字解释中的施工线索,帮助观察模型怎样理解临时可行驶区域。
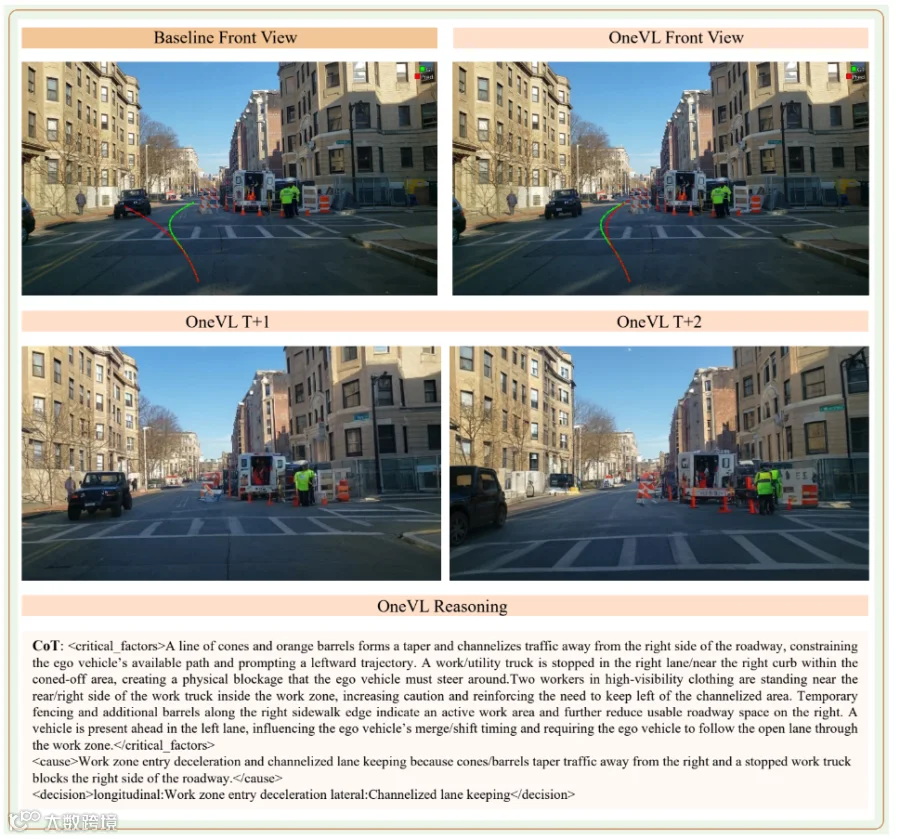

这些例子适合用于分析:轨迹有没有进入不合适的位置,语言解释是否提到决定路线的条件,预测画面是否保留了相关对象。把几种输出放在一起,能够提出更具体的检查问题。
03
行人过街:解释应当能与
预测内容一起检查
Alpamayo-R1 的一个例子中,论文给出的语言解释指向前方行人过街的让行需求。对应画面展示了参考轨迹、模型轨迹和两幅预测后续视野。

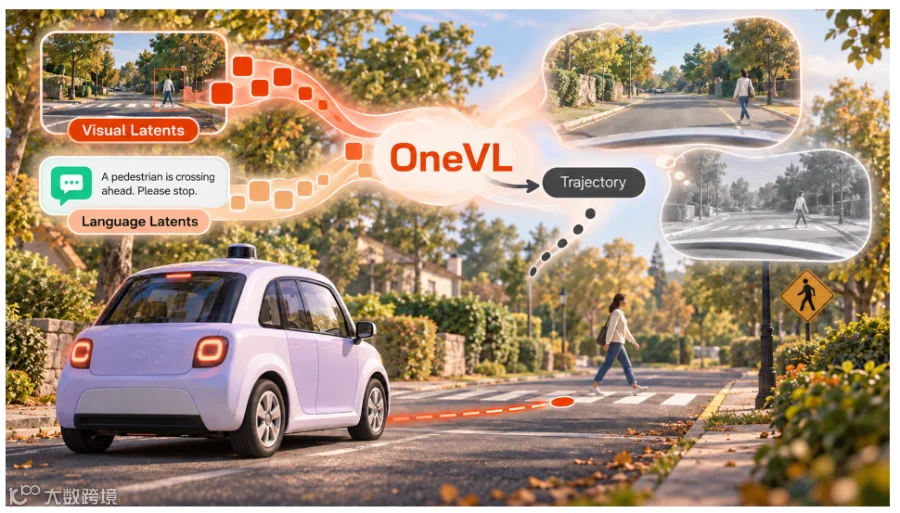
“模型能够生成让行解释”与“系统已在真实交通中完成可靠让行”是不同层面的结果。这里的图像和语言输出用于理解、评估模型的预测,不足以单独证明实际驾驶系统的安全表现。
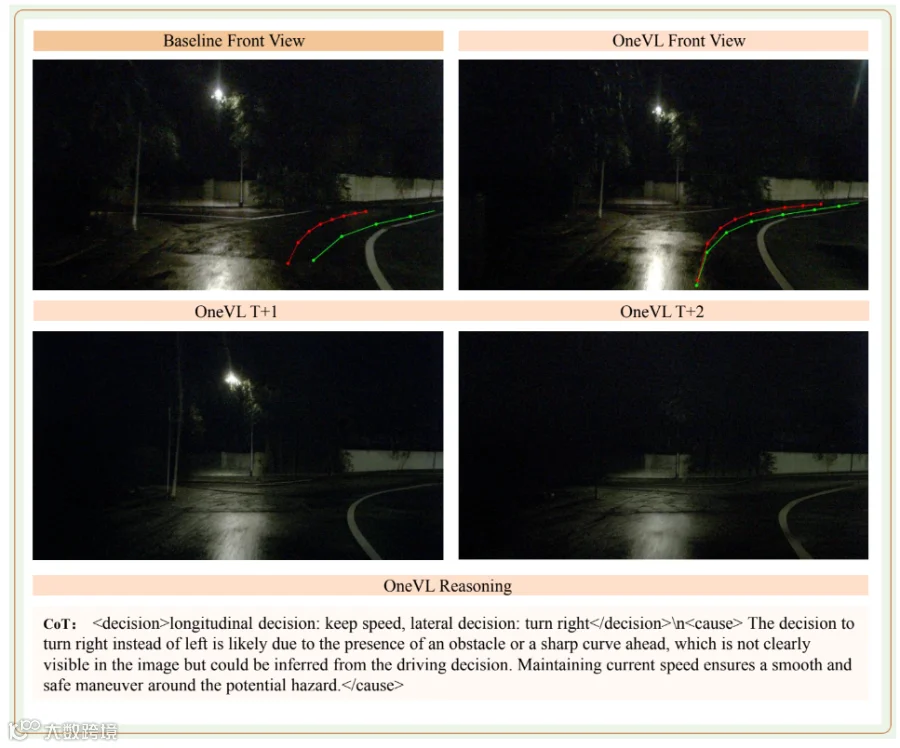
夜间复杂场景也提供了另一种检查条件。光照变化会影响目标和道路线索的可见性,语言中的驾驶意图是否与图像及轨迹一致,需要结合这些输出分析。
04
训练时学习解释,预测轨迹时
减少额外生成
OneVL 在视觉-语言-动作模型 (Vision-Language-Action Model, VLA) 中引入视觉与语言潜在位置。主模型读取当前图像、自车状态、导航命令和历史轨迹;视觉辅助解码器学习预测 0.5 秒、1.0 秒之后的画面,语言辅助解码器学习恢复推理文字。

标准推理路径可以不调用这两个辅助解码器。潜在 token 在预填充 (Prefill) 阶段并行处理,模型随后只生成轨迹答案。文字和视觉解释则可以在分析时按需生成。
这样,解释所提供的监督可以参与训练,而不必要求每次轨迹预测都先写完一段推理文本。需要说明的是,标准 OneVL 的轨迹仍是自回归 (Autoregressive, AR) 解码;减少了推理文本开销,并没有消除轨迹输出本身的顺序生成成本。
05
0.24 秒对应怎样的质量
与效率取舍?
为了进一步缩短轨迹输出时间,论文将一个多层感知机 (Multi-Layer Perceptron, MLP) 预测头接到最后一个潜在位置的隐藏状态上,直接回归未来轨迹。
在 NAVSIM 测试中,MLP 版本的 PDM-score 为 86.83,延迟为 0.24 秒;标准自回归版本分别为 88.84 和 4.46 秒。按论文报告的测量,MLP 版本约为 4.16 Hz,延迟约为自回归版本的 5.4%。
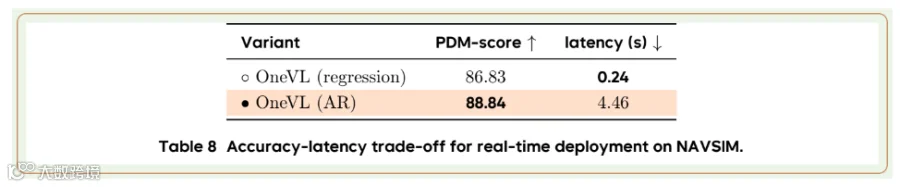
这张表给出的是具体的模型选择:一个版本保留更高的规划分数,另一个以较低分数换取更短的预测时间。0.24 秒与 88.84 不能作为同一版本的成绩。实际系统中的传感器、其他模型和控制执行还会影响整体延迟,因此车载表现需要结合系统条件验证。
PDM-score 也不等同于实际道路中的事故率。它是在 NAVSIM 的非反应式评测协议下形成的综合规划指标,与真实交通参与者交互的闭环测试仍有不同。
06
可读的解释,也有
自己的质量差距
OneVL 的语言解释评测基于 500 个 NAVSIM 测试样本,检查驾驶意图、语义相似性与模型裁判评分。三个维度的平均分为 76.13,高于 SIM-CoT 的74.06,低于显式思维链的78.27。
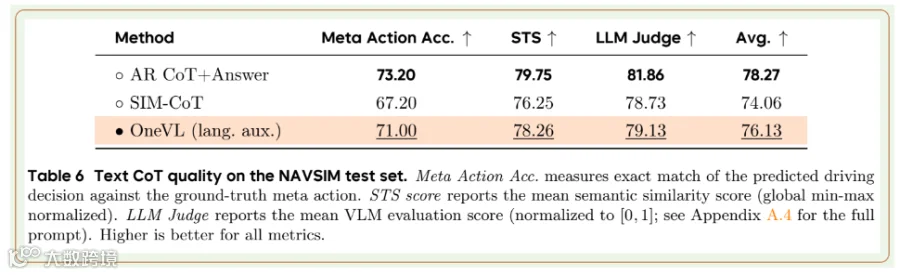
这个结果说明,压缩后的表示可以恢复具有参考价值的解释,但仍需要检查解释是否贴合当前场景。语言内容、未来画面与轨迹相互一致,是有用的诊断线索;它们并不自动构成经过验证的因果说明。
视觉解释的质量又与训练安排有关。OneVL先建立轨迹与潜在表示,再让辅助解码器适应稳定状态,最后联合优化。省略分阶段训练时,NAVSIM 的PDM-score从88.84降到67.13,说明形成有效表示需要相应的训练过程。

07
在日志中检查路线,也为
后续系统研究提供依据
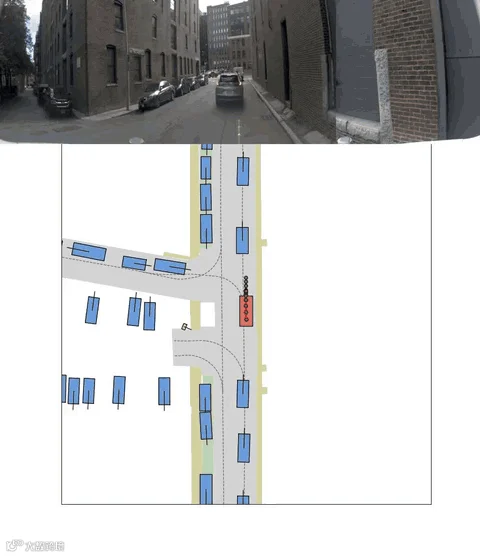
狭窄街道、路边停放车辆与转弯路口,都可以通过前视画面和鸟瞰预测进一步分析。原论文附录中的例子保留了参考轨迹、模型轨迹、后续画面和语言输出,便于在同一场景中核对这些信息。

OneVL 展示了一种把规划效率与解释监督连接起来的方法:训练时让隐藏状态学习可读的语言内容和未来视觉变化,运行时根据需要选择轨迹输出方式与解释调用。它的研究价值既在于四项基准上的规划改进,也在于将表示质量、预测时间和解释能力放进同一个可以检查的框架。训练资源开销、复杂交互和实际系统验证,仍是继续推进这套方法时需要考虑的部分。
END
关注+星标,获取AI前沿进展与开源一线动态