

让AI自主研发AI,甚至找到超越人类原有方案的方法,是递归自我改进(RSI)的重要研究方向。
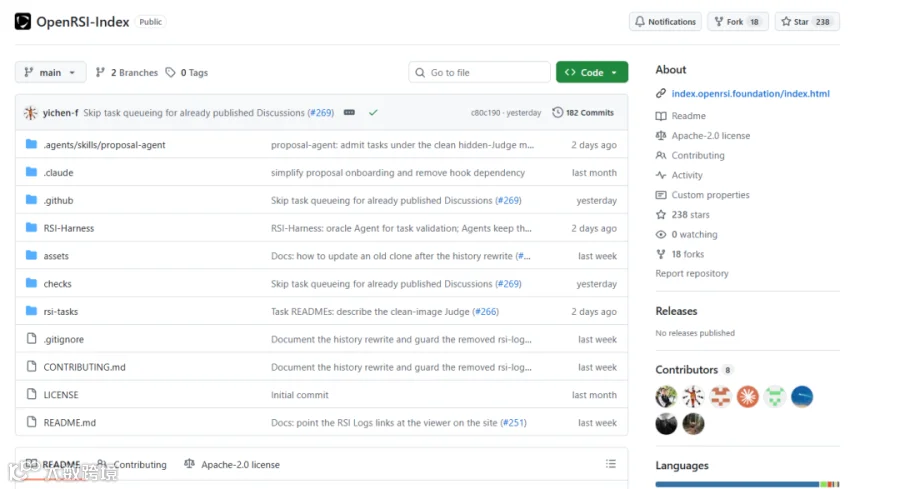
最近,MIT-IBM计算研究实验室与亚马逊A-EVO Lab共同牵头开源了 OpenRSI-Index,希望让更多研究者参与AI自主科研,不必从零搭建整套实验基础设施。
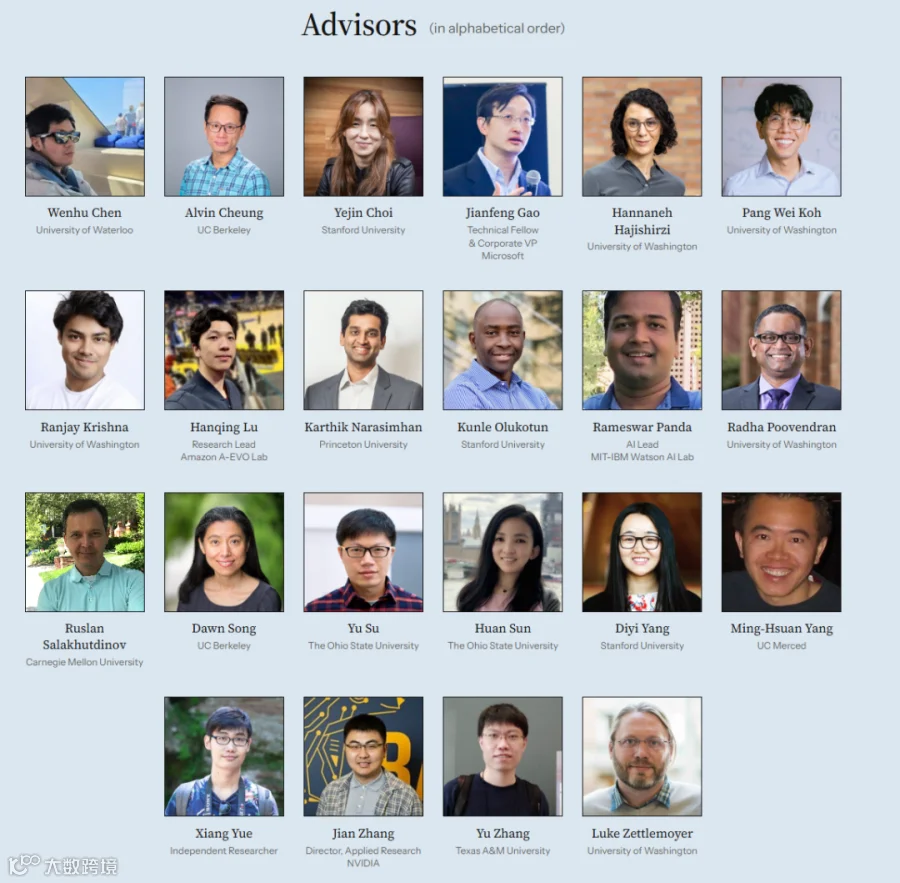
项目顾问阵容包括滑铁卢大学的陈文虎(Wenhu Chen)、斯坦福大学的 Yejin Choi、华盛顿大学的 Pang Wei Koh 和 Luke Zettlemoyer,以及加州大学伯克利分校的 Dawn Song 等知名学者。
通过OpenRSI-Index,研究者只需提供一个研究想法或现有开源项目,Agent就能协助搭建实验任务,再自主修改代码、运行实验、分析结果,并根据反馈不断调整方案。每次提交都会经过独立评测,实验日志和运行轨迹也会被记录,以便研究者检查和复现。
01
OpenRSI三大开源
工具打通AI科研
OpenRSI-Index是一套围绕科研任务构建、运行和评测的基础设施。包含三个部分:
(1)RSI-Anything,把想法变成实验任务
RSI-Anything是整个项目的任务贡献流程。
研究者可以选择自己参与开发的开源项目,也可以选择一个自己熟悉的领域中的代表性开源项目。随后,使用Codex或Claude Code等Agent,按照项目提供的proposal-agent技能,逐步明确研究问题、基线、评价方法、允许修改的范围和计算预算。
例如,研究者想研究某种训练策略能否提高模型性能。Agent需要帮助明确:使用哪个模型和数据集?原始训练方案是什么?允许修改哪些文件?通过什么指标判断效果?训练最多使用多少GPU资源?
这些信息将形成任务提案,并进入GitHub Discussions。提案经过检查后,系统继续构建任务环境。

(2)OpenRSI-Index,建立真实的AI科研考场
OpenRSI-Index是整个项目的核心评测基准,收录可以运行的研究任务,每项任务都需要明确研究目标、原始方案、资源预算以及验证方式。
它覆盖的范围不仅是大语言模型,还包括视觉模型、数据处理、训练系统、推理优化和机器人等领域。

(3)RSI-Harness,让Agent反复试验并接受检验
RSI-Harness是负责执行科研任务的运行框架,支持Harbor格式的任务,可以从单机Docker环境扩展到多节点集群。
一次实验开始时,Harness会检查任务配置和所需资源,然后为Agent准备独立的工作环境。Agent可以读取代码、修改允许编辑的文件、运行实验,并根据过程中的反馈继续调整方案。
当Agent提交一个候选结果时,Harness会保存对应的工作快照,再交给独立的评测环境进行检查。系统根据预先设定的验证规则计算分数,Agent随后可以参考反馈继续改进。
这里最关键的设计是把Agent工作的区域与评测机制分开。如果Agent能够随意修改评分程序,就可能通过钻评测漏洞获得高分,而不是真正提高模型能力。
因此,任务需要明确哪些内容可以修改、哪些变量必须固定,以及哪些违规情况会导致结果无效。
Harness还会记录实验轨迹、配置和日志,让研究者不仅能看到最后的分数,也能检查Agent到底做了什么。
02
使用教程
(1)克隆仓库
git clone https://github.com/OpenRSI-Foundation/OpenRSI-Index.gitcd OpenRSI-Index
(2)启动coding Agent
在新会话中输入:
Use the proposal-agent skill at .agents/skills/proposal-agent/SKILL.md in my local OpenRSI-Index repository. Locate the repository if needed, then follow the skill to complete setup and guide me step by step through creating and submitting an RSI proposal.Agent会根据技能文件引导用户定义任务目标、基线、评测标准、资源预算,并协助生成提案。
检查提案后,确认由Agent提交到GitHub Discussions。
此外,除了开放代码和科研任务,OpenRSI还在面向全球研究社区招募 Collaborators和 Domain Leads,希望共同扩充RSI实验基准。
END
关注+星标,获取AI前沿进展与开源一线动态