

01
引言
今天,AI 正在进入更多需要连续决策的任务。但要让决策能力在复杂环境中持续提升,系统仍需解决三个相互关联的问题:如何在既有动作空间中快速识别有效选择,如何发现并补足候选集的覆盖缺口,以及如何将延迟到达的执行结果转化为下一轮可验证的改进。
如果 AI 能够识别既有候选的覆盖缺口,在必要时提出候选集之外的新动作,并依据经过验证的执行结果递归更新后续决策,那么决策能力就可以从单轮选择延伸到跨轮次改进。
基于这一问题,我们在 Octer 构建了 Octer-Decision:一种面向高频决策的 System One 模型,能够快速评估既有动作,并在必要时扩展动作空间。结合 RSI 闭环,系统还可将执行结果关联至原始决策轨迹,经验证后用于更新模型与决策harness。

我们在广告决策和机器人扰动恢复任务中评估了这套机制。在广告评估中,300 个广告活动被随机分入三组,八轮实验共覆盖 604.8 万次决策机会。Octer-Decision + RSI 的利润指数达到 118.4(Jev = 100),高于固定版本 Octer-Decision 的 110.4;P95 决策链路延迟为 0.22 秒,约为 Jev 的一半,吞吐提高 69%。在 ManiSkill 机器人扰动评测中,系统在复合扰动下的恢复成功率达到 81.7%,人工接管率为 12.5%。
两类评测分别考察这套机制能否提高连续决策的经济回报,以及在原有动作失效后完成自主恢复。下面先介绍其决策与更新机制,再展开实验设计和结果。
02
Octer-Decision Octer
将动作空间扩展与递归更新纳入连续决策闭环
连续决策通常依赖预先定义的候选动作,但随着环境变化,原有候选可能无法覆盖当前状态下的有效方案。如果系统始终在固定集合中选择,候选设计的局限就会传递到最终决策;每次都重新生成动作,又会增加高频任务的推断开销。如何识别需要扩展候选的决策情境,是兼顾选择效率与探索能力的关键。
Octer 将模型判断与系统更新连接起来:Octer-Decision 负责高速选择与按需生成,RSI 闭环负责依据成熟的执行结果提出并验证模型与执行系统的更新。 配套的决策执行系统(harness)承担状态准备、动作组合、约束执行与轨迹记录,使模型输出进入可执行、可评估的决策流程。
Octer-Decision 将候选集的充分性纳入模型判断。在评估已有动作时,模型同时对“现有选项均不正确”(NCA)输出校准后的概率。当已有动作的概率最高时,系统直接返回选择;仅当 NCA 的概率最高时,才启动生成路径,提出候选集之外的新动作。新候选经过价值评估与约束校验,满足执行条件后进入执行。
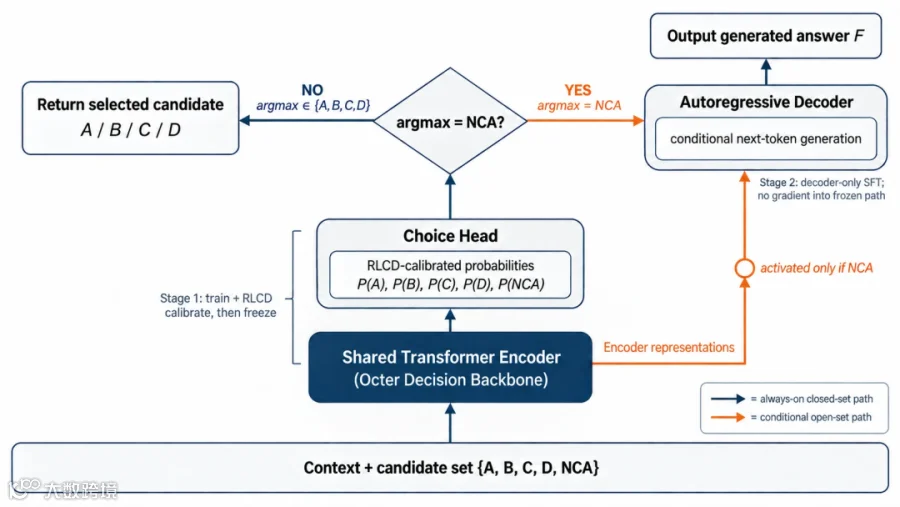
图 1|Octer-Decision 的选择与条件生成路径。模型优先评估已有候选,仅在 NCA 概率最高时启动新动作生成。
这一设计将候选覆盖缺口转化为动作空间扩展的触发条件,同时保留高频任务的直接选择路径。 生成计算集中于模型判断候选不足的情境,新增动作接受统一的价值评估与执行约束检验。
Octer-Decision 采用分阶段训练:先完成选择能力的训练与校准,再冻结该路径,训练新动作生成能力,使开放生成建立在已有选择路径的校准基础之上。
动作执行之后,系统需要进一步判断哪些经验能够支持后续改进。反馈可能延迟到达,观测结果也可能受到外部变量影响。只有还原决策时可知的信息,并将结果关联到产生行动的具体版本,才能为更新提供可靠的评估依据。
为此,harness 保存带版本的状态—动作轨迹,记录决策时的状态、候选集合、最终动作、模型与执行系统版本,以及安全拦截情况。待结果成熟后,系统将其与原始轨迹对齐,结合观测效用、延迟反馈、拦截记录与归因不确定性,评估相应版本的表现。
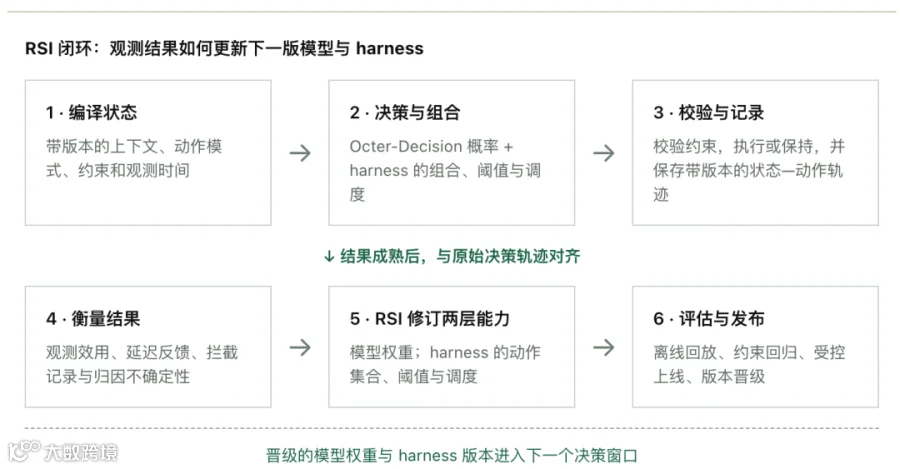
RSI 的修订同时覆盖模型权重与执行机制。 模型更新用于改进判断与生成能力,harness 更新涉及动作集合、决策阈值与调度方式。候选版本经过离线回放、约束回归与受控上线,完成验证与版本晋级后进入下一个决策窗口,使经过验证的改进能够被后续版本继承。
03
广告随机实验验证 Octer-Decision 决策闭环收益
递归更新进一步提高单位花费净利润
Octer 通过 300 个广告活动的随机对照实验,检验递归更新的实际收益
上述闭环能否转化为实际收益,需要在统一条件下比较固定版本与递归更新版本。广告投放为此提供了连续决策场景:系统在预算与平台约束下持续判断,转化反馈延迟到达,行动的利润贡献需要在归因成熟后才能评估。
我们将 300 个广告活动随机分为三组:Jev、Octer-Decision 和 Octer-Decision + RSI,每组 100 个活动。Jev 为本次实验的对照组;Octer-Decision 保持初始模型与 harness 不变;RSI 组从相同初始版本出发,在第 2、4、6 轮后接收经过验证的模型与 harness 更新。
三组采用相同的活动资格、逐轮花费分配、归因规则、平台写入频率和安全约束。同一组活动贯穿八轮决策及后续转化成熟阶段,覆盖每个活动的 15 个投放目标,共计 604.8 万次决策机会。这一数量统计系统获得判断机会的次数,实际平台写入另行记录。
主指标为利润指数,以 Jev 组的单位广告花费净利润为基准 100:
利润指数 = 100 × 各组单位广告花费净利润 ÷ Jev 组单位广告花费净利润。
我们以广告活动为单位进行随机分组和统计分析,通过按活动聚类的 Bootstrap 方法计算 95% 置信区间。决策延迟与吞吐量均在同一实验部署中,以 128 个并发请求的负载样本进行测量。
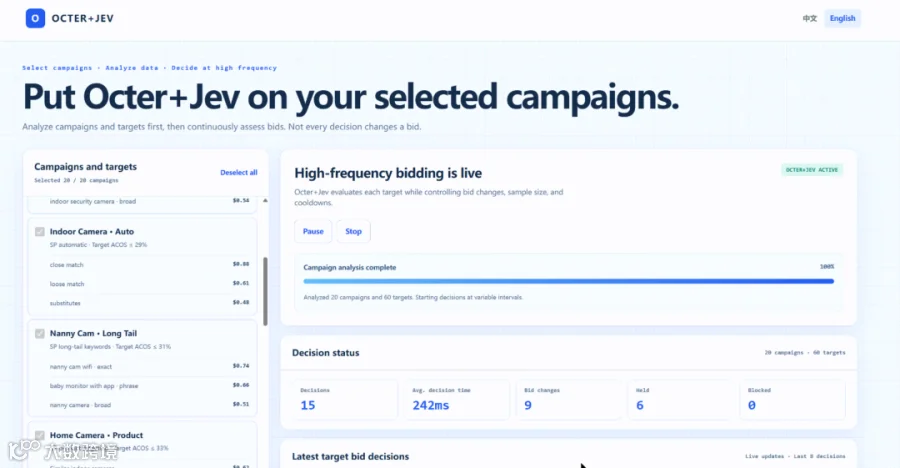
录屏 1:早期界面中的活动选择、数据分析与目标级竞价判断。竞价是广告动作的一类;实验结果按上文协议统计。点击可原地放大。
RSI 递归更新使利润指数提高 8.0 个点;相比 Jev,P95 决策延迟降低 50%,吞吐提高 69%
八轮实验中,Octer-Decision 的利润指数达到 110.4,Octer-Decision + RSI 达到 118.4。RSI 组相对 Jev 提高 18.4 个指数点,95% 置信区间为 10.8–25.9;相对固定版本 Octer-Decision 进一步提高 8.0 个指数点,95% 置信区间为 0.9–15.1。

图 2:三组活动的八轮利润指数。各轮结果均在等额花费、转化归因成熟后统计;虚线标记 RSI 组在第 2、4、6 轮后的版本更新。
相同初始版本下,RSI 组获得了高于固定版本的全程收益,支持递归更新在本次实验中的增量价值。 这一判断来自八轮完整结果,单个更新节点后的曲线变化仍可能受到反馈延迟与投放环境的影响。
在运行效率上,Octer-Decision + RSI 的 P95 决策链路延迟为 0.22 秒,相比 Jev 的 0.44 秒降低 50%;相对峰值吞吐提高 69%。测量覆盖状态准备、模型推断、策略组合和安全检查,也包含按需生成新动作的路径。收益增量由 RSI 组与固定版本比较,运行效率则由 RSI 组与 Jev 比较。
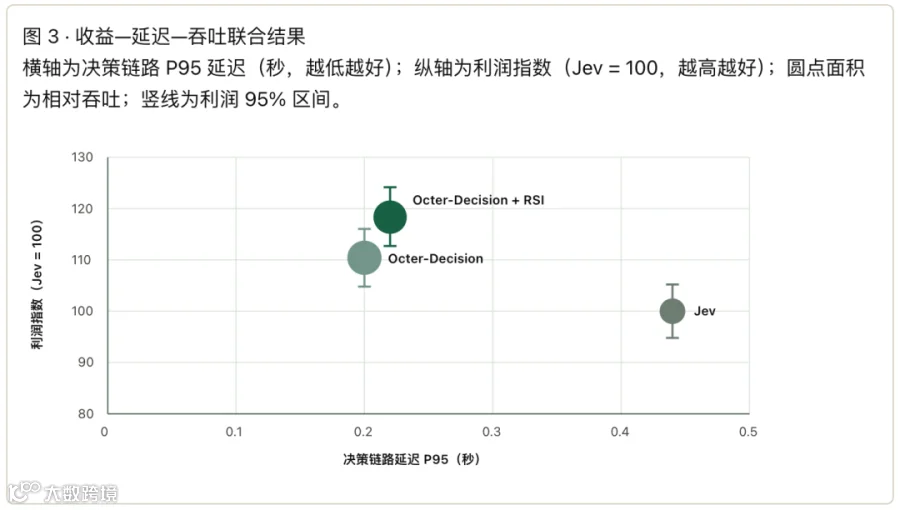
图 3:每个点概括同一随机实验组(100 个活动)。利润区间按活动聚类Bootstrap 计算;P95 与吞吐包括状态准备、模型推断、策略组合及安全检查。Octer-Decision + RSI 的延迟统计包含按需生成新动作的路径。
Octer 在 4.2% 的决策窗口生成新候选,实现动作空间的按需扩展
实验同时记录了新动作生成的触发情况。Octer-Decision + RSI 在 95.8% 的决策窗口中直接选择已有动作,在 4.2% 的窗口中启动新候选生成。生成候选中,94.1% 通过规则层面的可执行性校验,实际执行仍须经过共用安全门。
最终,8.6% 的窗口产生了广告平台写入。本次 300 个活动的实验未记录实际执行操作违反预设强制约束的情况。
这些结果表明,系统能够在保留直接选择路径的同时,按需补充候选集之外的行动方案。新候选的生成比例与可执行率验证了这一机制的运行情况;其独立收益贡献仍需通过进一步对照评估。本次实验确认的整体结果是:Octer-Decision + RSI 在统一投放条件下获得更高的单位花费净利润,并相对 Jev 实现更低延迟与更高吞吐。
04
从投放优化到扰动恢复,Octer-Decision 在 ManiSkill 仿真中
提高自主恢复成功率,减少人工接管
广告实验检验了连续决策的经济回报。我们进一步在 ManiSkill 仿真中考察:当环境扰动使已有动作失效时,同一决策机制能否支持自主恢复,并通过递归更新改善任务完成表现。
六类扰动检验 Octer 在原有动作失效后重新组织恢复方案的能力
我们基于 ManiSkill 仿真环境构建移动取放任务的中断恢复评测,由 Octer 团队设计六类扰动与恢复协议。LLM 提供任务计划,Octer-Decision 在扰动发生后决定下一项技能。例如,当目标位置被占用、既有放置动作无法执行时,开放分支可以提出“先临时放置,再调整位置”的技能组合,经控制器校验可达性与碰撞约束后执行。
每类扰动采用 240 个配对初始状态评测三组模型,各组共用感知、技能库、安全校验和计算预算。RSI 使用独立开发轨迹,评测中的物体与布局不参与开发。恢复成功要求自主完成任务且无不安全接触;人工接管率统计需要人工介入的回合。抓取方向受限、放置区域被占用和复合扰动三类场景,重点检验已有候选不足时的恢复能力。
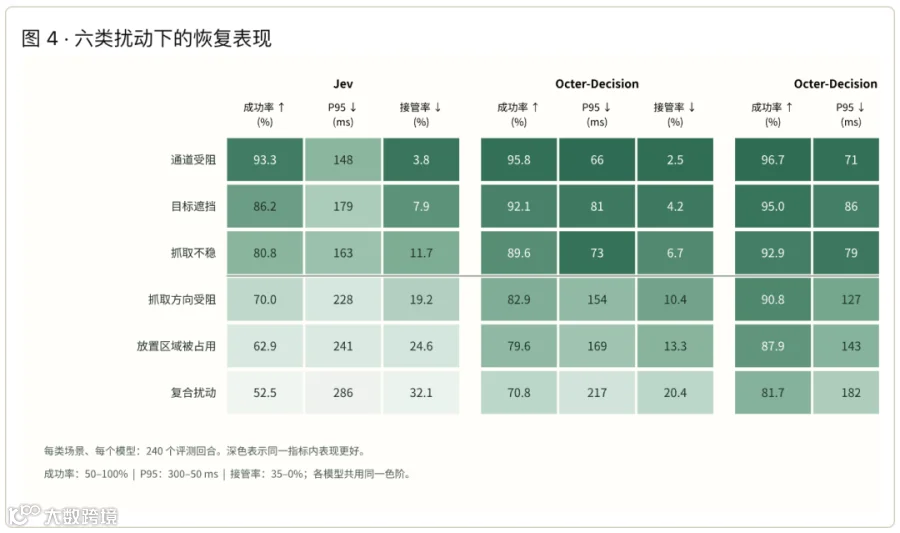
图 4|Octer 基于 ManiSkill 构建的仿真扰动恢复评测。每类场景、每组模型均评测 240 个回合,比较恢复成功率、P95 决策延迟与人工接管率;相同指标共用色阶。
复合扰动下,递归更新使恢复成功率再提高 10.9 个百分点;相对 Jev,人工接管率降至 12.5%
在复合扰动下,Jev、固定版本 Octer-Decision 和 Octer-Decision + RSI 的恢复成功率分别为 52.5%、70.8% 和 81.7%。RSI 组相比 Jev 提高 29.2 个百分点,相比固定版本进一步提高 10.9 个百分点,支持递归更新在本组仿真任务中的增量效果。
人工接管率从 Jev 的 32.1%、固定版本的 20.4%,降至 RSI 组的 12.5%。更多受扰动中断的任务能够由系统自主恢复并完成。
随着任务复杂度上升,RSI 组的 P95 决策延迟从通道受阻时的 71 毫秒增至复合扰动时的 182 毫秒,仍低于固定版本的 217 毫秒和 Jev 的 286 毫秒。该指标从状态就绪计至动作通过校验,包含按需生成新动作的过程;即时停车由独立控制器负责。
广告投放与扰动恢复具有不同的目标和执行条件,两类评测共同支持了 Octer 决策机制的跨场景适用性。在本组 ManiSkill 仿真中,模型与执行系统的联合更新提高了自主恢复成功率,并减少人工接管。 这一结果验证了同一决策范式在不同任务中的应用潜力,跨任务经验迁移及真实机器人部署表现仍有待进一步检验。
05
结语
综合来看,Octer-Decision 与 RSI 在高频广告决策和 ManiSkill 仿真扰动恢复两类任务中,展现了快速选择、候选空间扩展与结果驱动更新的协同能力。经过验证的执行经验能够进入后续版本,为决策能力的持续积累提供基础。
下一步,我们将推动这一递归决策机制向更多高频、动态且受约束的任务场景泛化,重点检验改进能否跨周期保持有效,以及不同任务中的经验能否沉淀为可复用的能力。这是 Octer 构建决策基础设施的长期方向:让持续执行成为系统能力增长的来源。
完整技术说明、实验协议与评测结果,请见 Octer-Decision 研究页面。更多研究与产品进展,可访问 Octer 官网。
Website:https://octer.ai/zh/research/octer-decision
关于 Octer.ai
Octer.AI 是一家面向全球企业个性化智能的 AI Native 创业公司,以自研“AI for AI 持续学习引擎”为技术核心,沿 RSI(递归自我改进)路径,将企业专有数据、历史经验与业务反馈转化为可验证、可复用、持续积累的经验与技能。公司的核心愿景是让每家企业拥有理解自身业务、自主执行并持续进化的专属智能,推动中国企业以 Agentic 新范式拓展全球市场。核心团队来自字节跳动、Google、腾讯、小米等科技企业。
Octer:品牌专属的自进化增长引擎
从AI工具到AI伙伴:Octer.AI入选“人工智能国际公共产品图谱”,代表中国领先AI产品进入全球视野
Octer创始人余博士亮相WAIC浙大校友创业论坛——从技术追逐到行业深耕,AI创业正在进入新阶段
点击关注「Octer.ai」
获取Octer-Decision Research最新进展👇
