


导读本文整理自方彪在Agentic AI Summit-2026-深圳站上的分享。小米围绕 Data Agent 从榜单评测走向生产落地进行了持续实践。本文重点介绍分析 Agent 的产品形态,以及数据质量、生成稳定性、评测构建、自动优化、长期运维等环节的解法,并结合金融销售、人力资源、账单分析等场景说明实际落地效果与后续方向。
主要内容包括以下几个部分:
1. 为什么周活 5 万的 BI 之上,还需要 Data Agent
2. 从“能答对”到“持续答对”,生产落地卡在哪
3. 三个真实场景,看 Data Agent 怎么进入业务
4. 人人都能做 Agent 之后,中台还应该做什么
为什么周活 5 万的 BI 之上,还需要 Data Agent
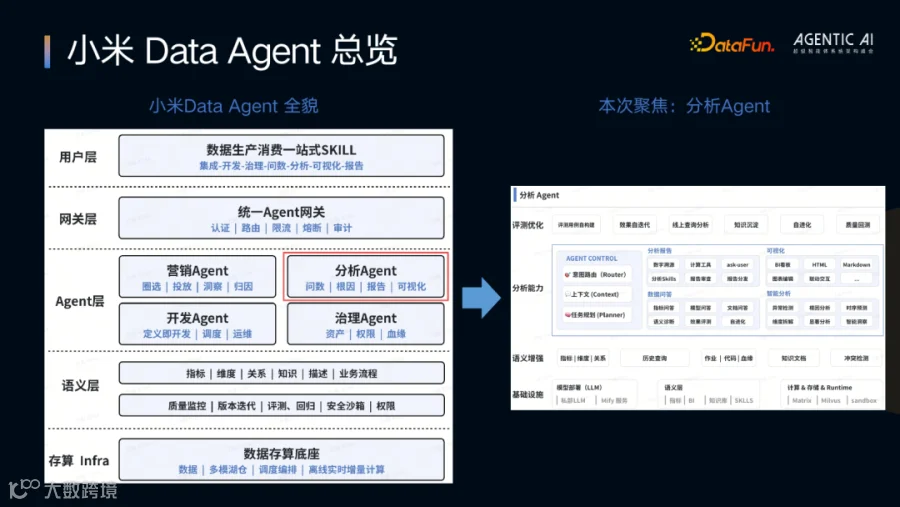
小米 Data Agent 并不是一个单纯的对话机器人,而是从底层数据存算底座,到中间语义层与语言模型,再到营销 Agent、分析 Agent、开发 Agent、治理 Agent 的完整体系。本次分享聚焦分析 Agent,覆盖问数、分析、洞察、报告和可视化等能力。

在公司内部,已经有一个周活 5 万的 BI 平台。但 BI 仍有四堵墙:专业要求高,搭看板、写 SQL、建报表对非技术用户不友好;不够智能,只展示数值,异常原因仍依赖分析师;灵活性差,新增指标或调整看板要排期;决策链路也容易在“看完数据”之后中断。分析 Agent 不是替代 BI,而是作为增强层补足长尾诉求:自然语言问数、根因分析、灵活下钻,以及规则与 Action 的行动闭环。
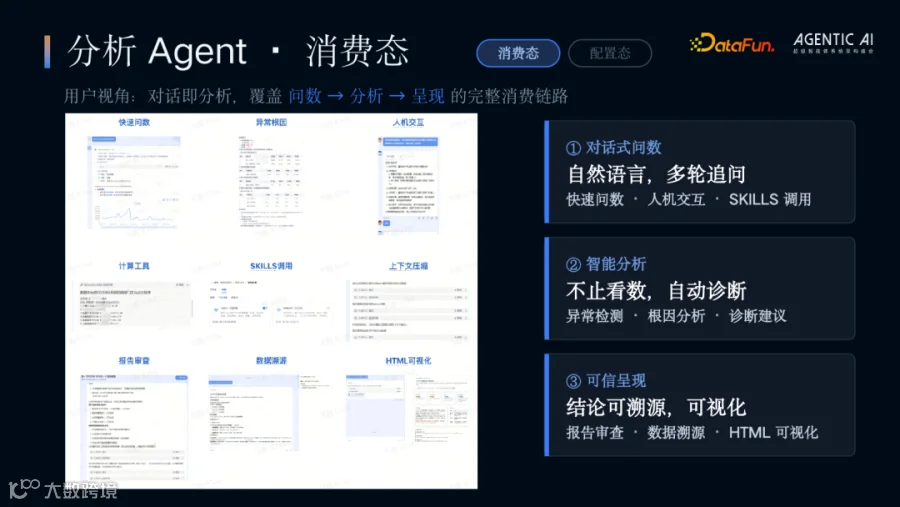
从产品形态上,分析 Agent 分为消费态和配置态。消费态面向用户,覆盖“问数—分析—呈现”:对话式问数支持自然语言、多轮追问、快速问数、人机交互和 Skills 调用;智能分析提供异常检测、根因分析和诊断建议;可信呈现通过报告审查、数据溯源和 HTML 可视化,让结论可回查。
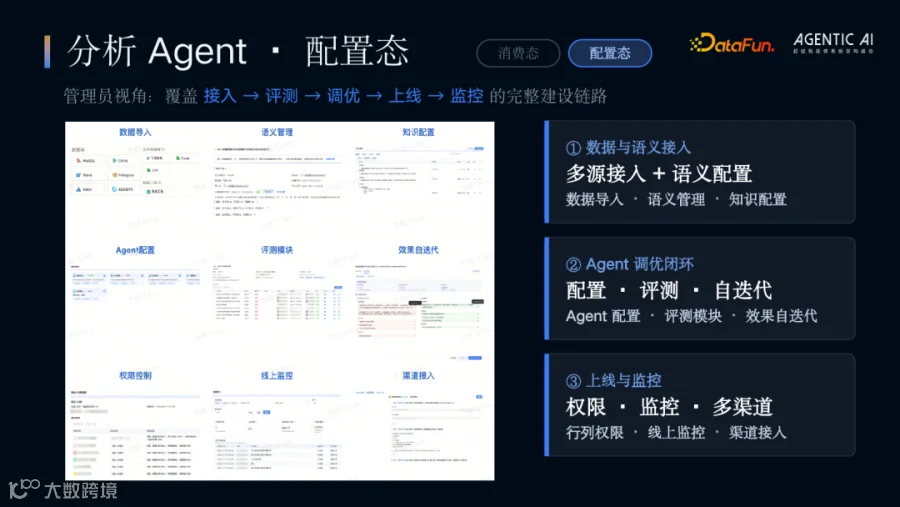
配置态面向管理员,覆盖“接入—评测—调优—上线—监控”。数据与语义接入支持数据导入、语义管理和知识配置;Agent 调优闭环包含 Agent 配置、评测模块和效果自迭代;上线后还要处理行列权限、线上监控和多渠道接入。

目前,这套分析 Agent 已在 10+ 业务领域规模化落地,保持千级周活,持续产出数千份分析报告与数据洞察,用数、分析和决策效率提升 10x+。外部评测上,团队在 BIRD Text-to-SQL 榜单位列全球第三。但榜单回答的是“能不能解题”,生产环境真正要解决的是“能不能长期稳定地答对”。
从“能答对”到“持续答对”,生产落地卡在哪
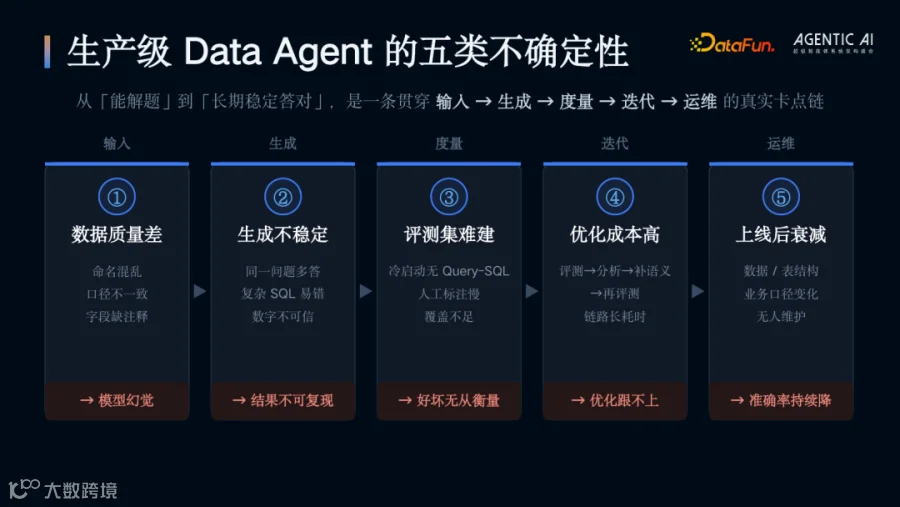
从榜单走到生产,问题贯穿输入、生成、度量、迭代和运维:数据质量差会放大模型幻觉;同一问题多答、复杂 SQL 易错,结果难复现;没有 Query-SQL 评测集,好坏无法衡量;人工分析、补语义、再评测的迭代成本很高;上线后数据、表结构和业务口径持续变化,准确率还会自然衰减。
① 数据质量|多级语义回退架构:Metric → DSL → Reject
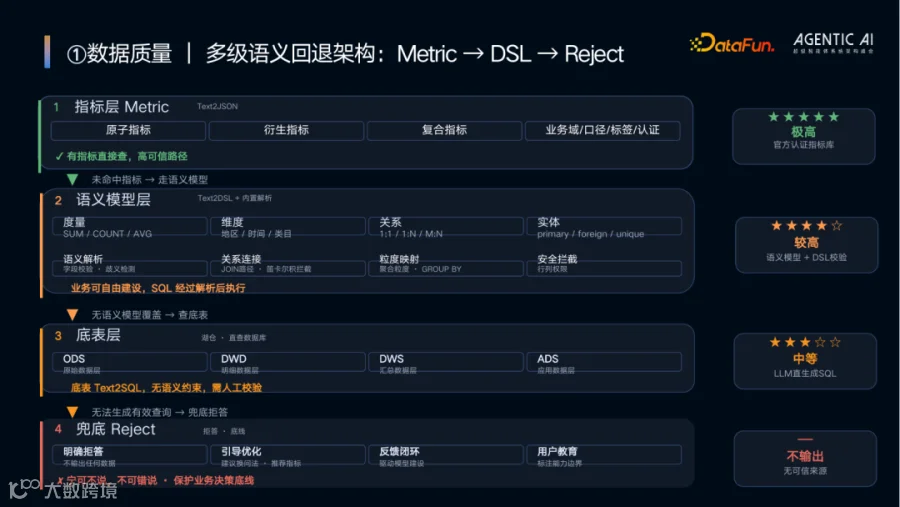
数据质量不行,后面的 Harness 再精巧也没有意义。第一层是指标层,走 Text2JSON,把用户问题映射到经过认证和持续维护的原子、衍生、复合指标,属于最高可信路径;未命中后进入语义模型层,走 Text2DSL + 内置解析,把度量、维度、关系、实体映射为 DSL,并处理 JOIN 路径、粒度、GROUP BY 和行列权限等约束。再往下是底表层,直接面向 ODS、DWD、DWS、ADS 做 Text2SQL,需要人工校验;若仍无法形成有效查询,则进入 Reject。核心原则是宁可不说,也不能在没有可信来源时错说。多层架构也是为了兼容不同业务的语义成熟度。
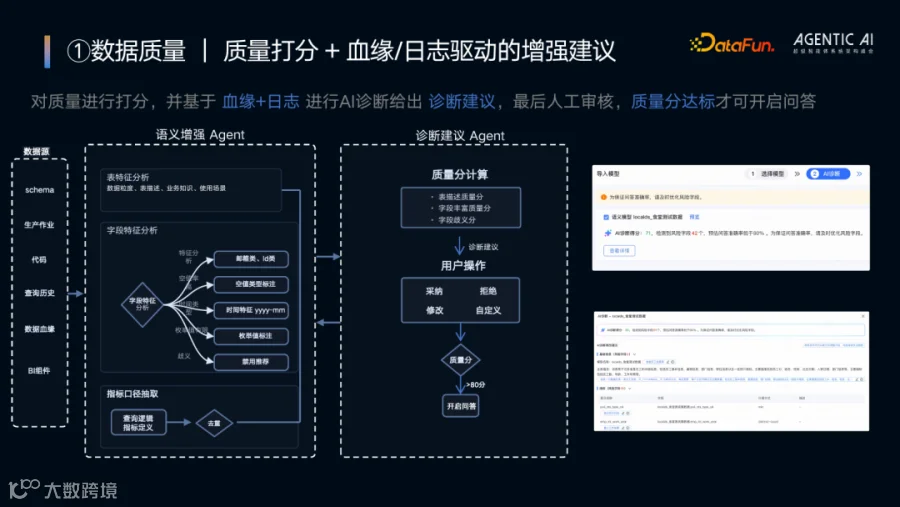
已有 BI 语义模型也不能直接交给大模型。系统基于 schema、生产作业、代码、查询历史、数据血缘、BI 组件和指标定义,做表特征、字段特征、用户行为和指标口径分析,再由诊断建议 Agent 计算质量分并给出补全建议。用户可以采纳、拒绝、修改或自定义,质量分超过 80 分后才开启问答。
② 生成稳定|多路生成投票提高稳定性
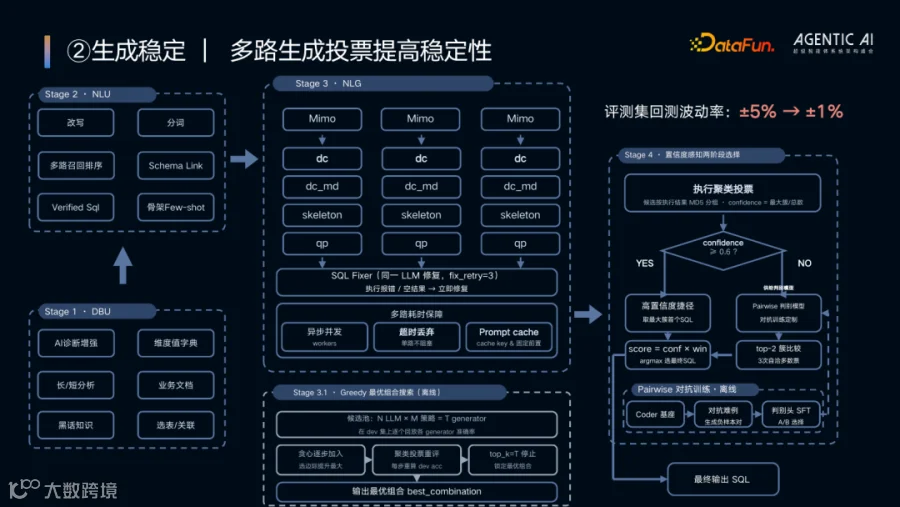
即使采用低 temperature,同一 query 在不同 batch、MoE 路由等情况下仍可能出现细小差异,复杂 SQL 会继续放大波动。方案是多路生成加投票:前两阶段完成数据理解和语义理解,包括 AI 诊断增强、维度值字典、业务文档、改写、分词、多路召回排序、Schema Link、Verified SQL 和骨架 Few-shot;生成阶段由多个模型和策略产生候选 SQL,SQL Fixer 对报错或空结果最多修复 3 次,并用异步并发、超时丢弃和 Prompt cache 控制耗时。
选择阶段按执行结果聚类,confidence 为最大簇占候选总数的比例。confidence ≥ 0.6 时直接取最大簇 SQL;低置信度进入 Pairwise 判别,对 top-2 簇比较并结合多次自洽结果选择最终 SQL。离线还会用 Greedy 搜索不同 LLM 与策略的最优组合。回测中,波动率从 ±5% 收敛到 ±1%。这套方案默认不开启,因为本质上是用更多推理成本换稳定性。
② 生成可信|可解释即可信任:数据溯源
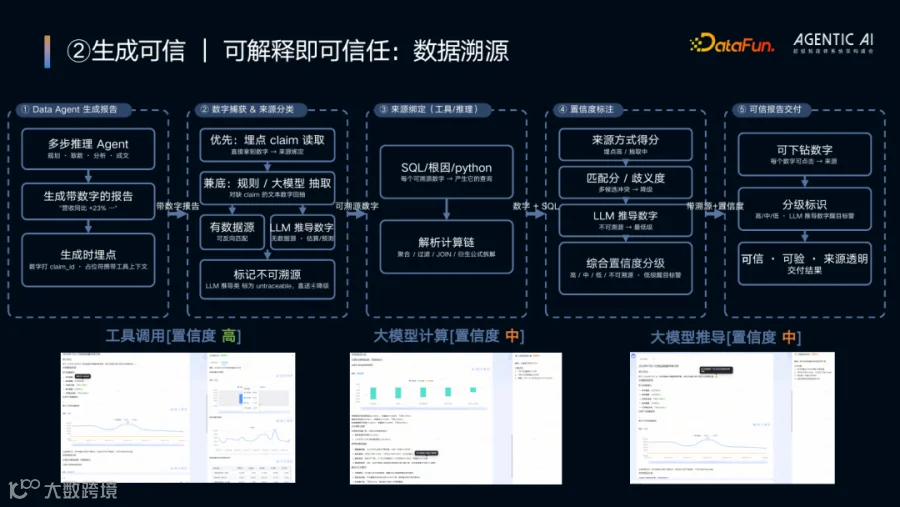
分析报告背后可能有多次工具调用,分析路径也不唯一。与其强求两篇报告完全一致,更重要的是让用户知道每一个数字从哪里来。系统把数字来源区分为工具调用、大模型计算和大模型推导:工具调用时保存原始数据和上下文,生成报告时写入 claim_id;能绑定到 SQL、根因分析或 Python 结果的数字继续解析聚合、过滤、JOIN 和衍生公式等计算链;无法反向匹配、属于估算或预测的数字标记为不可溯源并降级。最终按来源方式、匹配分和歧义度给出高、中、低或不可溯源的置信度,用户可以直接下钻查看来源。
③ 评测构建|冷启动:BI 看板 + 智能生成
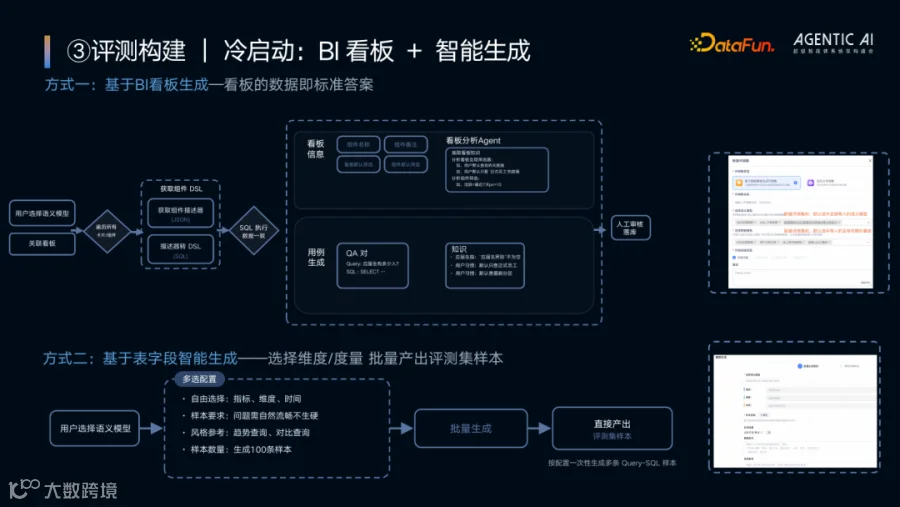
业务上线前必须有评测集,但人工逐条写 Query-SQL 成本很高。已有 BI 看板可以直接作为冷启动资产:系统遍历组件,把描述器转换成 DSL 并校验取数一致;看板分析 Agent 再结合全局筛选、组件筛选、标题和用户习惯生成自然语言 query,组成 QA 对,最后人工审核落库。没有看板时,也可以从语义模型和表字段批量生成,用户配置常用指标、维度、时间、问题风格和样本数量,再注入业务知识。

上线后,真实 query 继续进入评测体系。点赞是强正信号,点踩或报错是强负信号,多轮、空结果等属于弱信号。AI 只负责给出错因、SQL 草稿和建议知识,人工确认样本、SQL 与知识后再落库。目标不是替代人工,而是把“从零写”变成“审草稿”。
④ 优化提效|Loop:评测-归因-增强闭环

有了评测集,就能持续发现 bad case。系统把“评测—分析—补语义—再评测”沉淀成 Loop:全量评测采用 Text2SQL + Judge,错误分类 Agent 将失败样本归为选表错误、SQL 语法、SQL 逻辑、语义理解、结果偏差等类型,再按人工经验路由修复。审查 Agent 检查修复是否具备泛化性、是否与已有知识冲突、是否引入新错误,通过后应用修改、保存版本快照并重新评测;达到目标、遇到瓶颈或出现退化时停止,退化则回退。用户只需要一键开启优化,收到飞书通知后审核变更。
⑤ 抗衰减|回测监控 + 增量沉淀 + 语义层 CI

达到 90% 准确率并上线并不等于结束。系统设置三道防线:定期自动回测,效果下降就告警;把线上真实 query 持续沉淀为增量评测集;语义层变更像代码一样走 CI,变更前后自动比较评测效果。上线只是起点,持续衰减才是数据系统的常态。
三个真实场景,看 Data Agent 怎么进入业务

落地后,快速问数从 1 小时到 1 天缩短到 17 秒,根因分析从 1—3 天降到 2—5 分钟,分析报告从 1 周降到 10 分钟,新业务接入从月级缩短到天级。效率提升的核心不是单纯“更快”,而是把人从重复取数中释放出来。
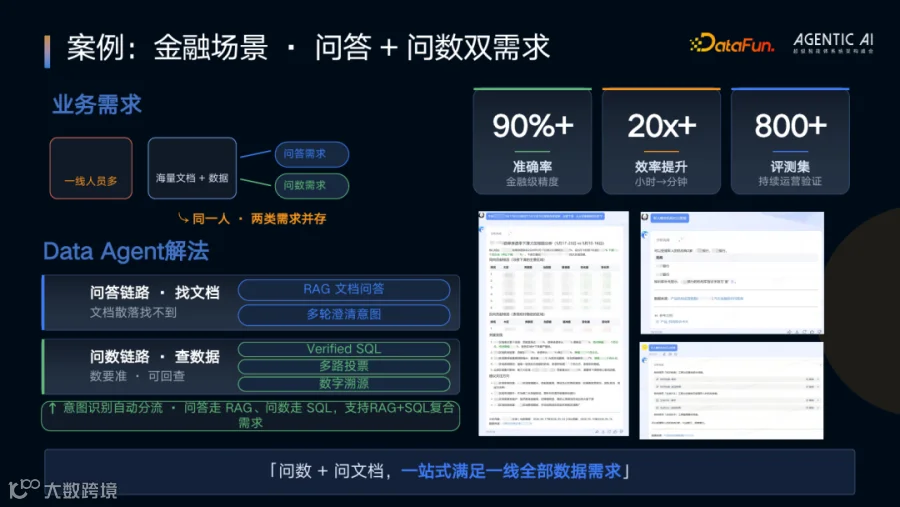
金融销售场景同时存在问文档和问数据两类需求。问答链路使用 RAG 文档问答和多轮澄清,问数链路使用 Verified SQL、多路投票和数字溯源,由意图识别自动分流,也支持 RAG + SQL 复合需求。该场景准确率保持在 90%+,效率提升 20x+,并构建了 800+ 条评测集持续运营。

人力资源场景面向大量非技术 HR,同一批数据会按应届生、中管、蓝领、白领等不同维度分析,报告模板也各不相同。这里用 Skills 沉淀分析思路和可视化模板,并通过 HTML 快速切换深度、精简、月度等报告风格。目前月活 200+,周人均对话 3.2 次,非技术 HR 也可以自主取数和生成报告。

账单分析场景关注的不只是“多花了多少钱”,还要解释为什么多花、由谁负责。系统用数字溯源和异常根因诊断把数据变成洞察,再通过“生成报告—找到负责人—签字确认—落实整改—跟进验收”把洞察推到行动。报告生成从 3 天降到 10 分钟,并覆盖 10+ 领域。
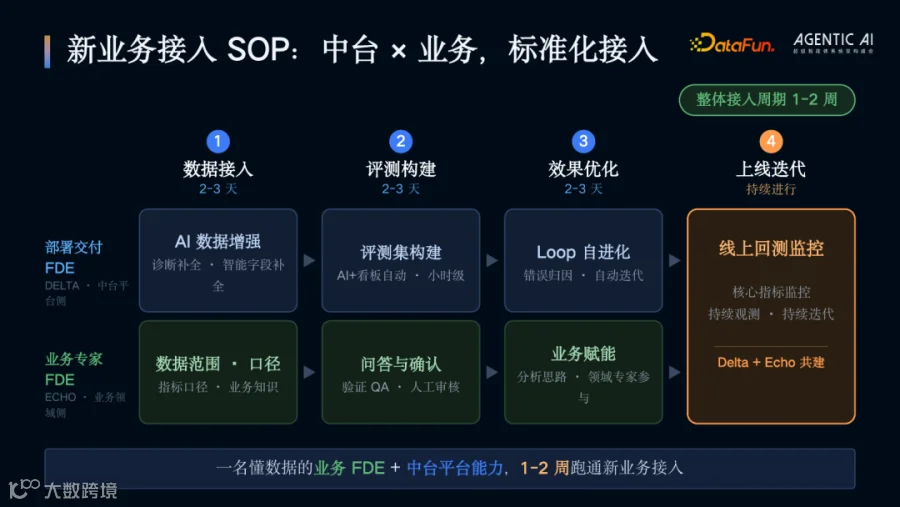
新业务接入也被做成标准 SOP。中台侧由部署交付 FDE 提供平台能力,业务侧由懂数据的业务专家 FDE 配合,数据接入、评测构建、效果优化各约 2—3 天,上线迭代持续进行,整体 1—2 周可以跑通一个新业务。
人人都能做 Agent 之后,中台还应该做什么

只靠模型不够,可靠性来自 Harness 工程闭环。BIRD 同一榜单中,工程闭环排到第 3,而纯模型 baseline 多在 30—90 名开外。数据分析和写代码也不一样:上下文中的数据质量更差;生成阶段很多问题的答案相对唯一;验证阶段即使 SQL 能正确生成并执行,也不代表最终数据一定正确,因为业务口径往往存在于人的知识和语义体系中。

分析 Agent 的启动门槛已经明显降低。元数据获取和数据查询接口通过 CLI 开放后,团队无需自建一整套基础设施;垂域团队只关注自身数据,表量级更小,也更了解业务口径;Claude、Codex 等 AI 工具和 Skills 机制继续降低开发与知识复用成本。因此,各业务团队都有条件快速构建自己的垂域分析 Agent。

门槛低不代表长期维护成本低。中台更适合集中解决三类问题:建设语义层治理基础设施,把语义层结构、业务知识导入、CI、版本和血缘影响分析做成标准能力;让 Harness 持续进化,把评测、回测、监控和业务接入成本继续压低;打通开发、治理、分析三类 Agent,并开放 CLI 和 Skills,补齐单个业务团队难以独立建设的全链路能力。
站在中台角度,重点不是做别人做不了的事情,而是把业务团队自己做起来成本高、维护久、效率低的事情,沉淀为可复用的平台能力。
往期推荐
51Talk 工作流 DAG 生产治理实践
高德用Agent评估营销补贴ROI,结果如何可信?
腾讯新一代数据智能体DataBuddy在真实场景的落地探索!
本体多Agent实践:AI如何参与企业复杂业务决策?
基于Harness+记忆+Skill的Agent增长实践!
WorkBuddy同款数据智能体在真实场景的落地探索!
基于Harness+Skill+Data Agent的Agent Growth实践!
阿里集团2000+数字员工上岗,从试点到规模化的血泪经验
Foundation Protocol:Agent 社会的基础协议与协调底座
Palantir多Agent实践:AI如何参与企业复杂业务决策?

点个在看你最好看
SPRING HAS ARRIVED
