启元机器人新进展:北大董豪团队推出 HIL-UMI,让后训练摆脱「真机依赖」
 AI科技评论
继无本体预训练之后,具身智能后训练范式迎来新突破。
作者丨齐铖湧
编辑丨岑 峰
![]()
近期,具身智能领域关于“无本体进行后训练”的讨论热度攀升,但行业内尚未出现可行的落地方案。启元机器人首席科学家董豪指出:“预训练决定下限,后训练决定上限。”当前,具身机器人在进厂、家政等真实场景的落地竞争,本质是后训练实力的比拼。
传统后训练依赖真机数据,成本高昂且难以规模化;而无本体预训练虽能扩大数据量,却缺乏关键的“纠错”环节。针对这一痛点,北京大学与启元机器人董豪团队联合推出了HIL-UMI方案,旨在解决无本体条件下的后训练纠错难题。
论文地址:https://arxiv.org/pdf/2609.20659
项目主页:https://hil-umi.github.io
与大语言模型相比,具身智能的后训练成本极高,成为制约其规模化的主要瓶颈。大模型的RLHF(人类反馈强化学习)仅需人工标注,而具身机器人需与物理世界交互。
传统的DAgger流程(如HG-DAgger)要求人类操作员在旁监控,待机器人出现错误时接管并记录正确轨迹,随后还需人工恢复现场。这种模式耗时费力,绝大部分时间消耗在机械臂缓慢动作和环境复位上,导致有效数据产出率低,严重阻碍了数据规模的扩展。
02
HIL-UMI底层逻辑:为UMI采集赋予“模型大脑”
HIL-UMI(Human-In-the-Loop UMI)的核心理念是“无需机器人,即可为模型补课”。与传统UMI(手持夹爪)盲目采集不同,HIL-UMI引入了模型参与采集过程:
1. 真人操作:操作员手持UMI夹爪执行任务(如抓取、折叠),摄像头同步记录画面。
2. 模型预测:后台模型接收相同画面和指令,预测后续动作轨迹,但不控制任何硬件。
3. 分歧触发:系统实时比对人类动作与模型预测。若两者一致,说明模型已掌握;若偏差较大,表明模型在此场景下存在盲区,系统提示操作员重点示范该片段。
该过程无需机械臂在场,也无需机器人实际犯错,即可在示范同时精准捕获模型在真实部署中可能出错的场景。
HIL-UMI建立了一套让模型自动识别“错题”的闭环系统,包含两大技术支柱:
第一步:动作分歧检测。通过并行采样多组动作块计算“能量分布”,判断模型置信度。若模型动作分布分散且与人类偏离大,判定为“分布外状态(OOD)”,触发补录。
第二步:优势估计器。引入评估“任务推进程度”的估计器,采用“优势条件”训练,确保模型不仅学习纠正动作,更专注于能实质推进任务的有效动作,剔除无效晃动。
随着模型迭代,其盲区不断向更深、更难的边缘场景推移,形成“暴露盲区-针对性示范-模型进化”的自我迭代闭环,摆脱了低效的海量正向数据刷取模式。
真机遥操作/DAgger:数据保真度高,但单机成本高、折旧快、操作门槛高,难以大规模铺开。
仿真(Sim2Real):成本低、数据量大,但在柔性物体、摩擦力及复杂光照下存在巨大的仿真与现实差距,难以直接用于真机后训练。
海量视频预训练:规模无限,但缺乏物理力学信息与精准动作维度,主要用于建立常识感知,无法直接转化为精准控制。
传统UMI:低成本、易规模化,但仅能采集正例,无法解决长尾错误恢复问题,通常仅用于预训练。
HIL-UMI结合了UMI的低成本与DAgger的纠错能力,克服了两者缺点,处于极佳的平衡点。
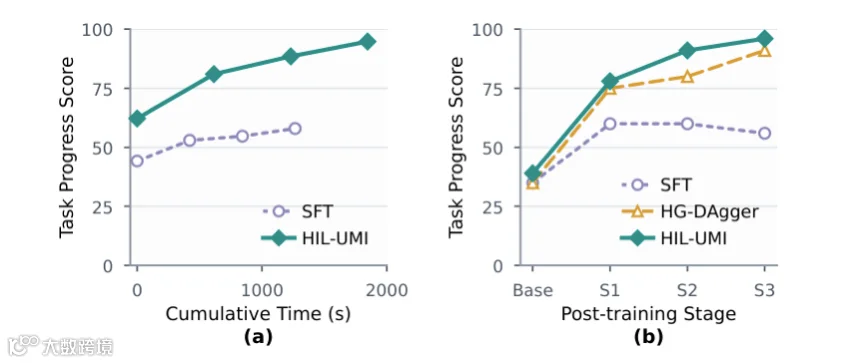
实验数据显示,在折毛巾、整理桌面等四项任务中,相同数据预算下,常规SFT微调的任务平均进度分(TPS)仅从44.3提升至58.0;而采用HIL-UMI定向纠错后,平均分达94.8,高精度任务成功率达100%。
在复杂的“整理桌面”任务中,真机HG-DAgger采集一帧有效数据耗时412.99毫秒,HIL-UMI仅需73.40毫秒,采集效率提升5.63倍。节省的时间主要来自消除机械臂移动、等待及人工复位现场的无效损耗。
此外,手持采集对操作者技能要求低,轨迹质量高,使得后训练具备“分布式”潜力。未来可通过兼职人员在各地使用简易设备采集,后台云端模型自动捕获高质量差分数据,彻底改变局限于实验室的后训练模式。
董豪认为,预训练与后训练是阶段性更替关系。如同AlphaGo从模仿学习到自我博弈强化,具身智能的下半场竞争在于谁能以最低边际成本、最快速度构建纠错网络。随着具身模型从Demo走向规模化应用,可规模化的后训练体系将成为决定胜负的关键。
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
AI科技评论
聚焦AI前沿研究,关注AI工程落地。