

关注我们
AI TIME
AI TIME 欢迎每一位 AI 爱好者的加入!
导读:强化学习与智能体的交汇
强化学习聚焦于“怎么学”,即智能体通过在环境中试错,依据回报信号优化策略,无需依赖人工标注。从 AlphaGo 到大模型后训练,均遵循此路径。然而,该领域长期面临回报稀疏、策略泛化能力弱、多智能体协作空间爆炸以及因果归因不明等挑战。
智能体(Agent)则侧重于“怎么做事”,即模型自主规划、调用工具,将模糊目标拆解为长链条行动执行。
当两者结合形成 agentic RL(智能体强化学习),被视为当前关键演进方向:智能体不再局限于预设提示词,而是在环境反馈中自我增强,甚至实现递归式自我改进。
本期 AI 前沿青年讲者计划首期专场,四位嘉宾将从无模型强化学习的记忆机制、无监督强化学习的泛化提升、大规模订单调度的多智能体必要性,到智能体的递归自我改进展开深入探讨。圆桌环节将进一步剖析奖励来源、回报信号有效性及“递归自我改进”的理论边界等核心议题。
活动信息
AI 前沿青年讲者计划 · 首期「强化学习与智能体」专场
时间:10 月 21 日(周三)14:00
形式:线上直播,无需报名
嘉宾与报告信息
何哲:探究无模型强化学习中的记忆机制

何哲
澳门大学计算机科学博士生,研究流式强化学习与持续学习
分享主题:Investigating Memory in Model-Free RL with POPGym Arcade
报告简介:如何判断强化学习智能体是否有效利用记忆?团队提出 POPGym Arcade,利用配对的完全与部分可观测任务,结合评估指标和梯度可视化分析记忆。研究表明,仅凭回报难以公平比较记忆模型;价值函数可能将信用分配给无关历史,异常观测还可能污染记忆,持续影响后续决策。
应铖阳:无监督强化学习视角下的泛性提升

应铖阳
清华大学 TSAIL 组博士生,研究强化学习在智能体与具身智能中的泛化性
分享主题:从无监督强化学习视角提升强化学习泛化性
报告简介:泛化性是强化学习的核心挑战。无监督强化学习旨在无奖励环境中预训练智能体,使其习得任务无关知识,从而快速适应下游任务。本报告介绍两项工作:基于扩散模型提升无监督强化学习表现,以及跨本体无监督强化学习,统一考量任务泛化和本体泛化。
赵子健:网约车调度中多智能体强化学习的必要性探讨

赵子健
香港科技大学博士生,研究多智能体强化学习与智慧交通
分享主题:Triple-BERT: Do We Really Need MARL for Order Dispatch on Ride-Sharing Platforms?
报告简介:针对网约车平台大规模订单调度中观测空间大、协作效率低、动作空间复杂等问题,提出首个基于集中式单智能体强化学习的调度方法。该方法通过动作分解降低联合动作空间复杂度,并设计参数共享的 BERT 网络,利用注意力机制建模司机与订单间的复杂关系。
赵思杰:遥感模型的递归自我改进
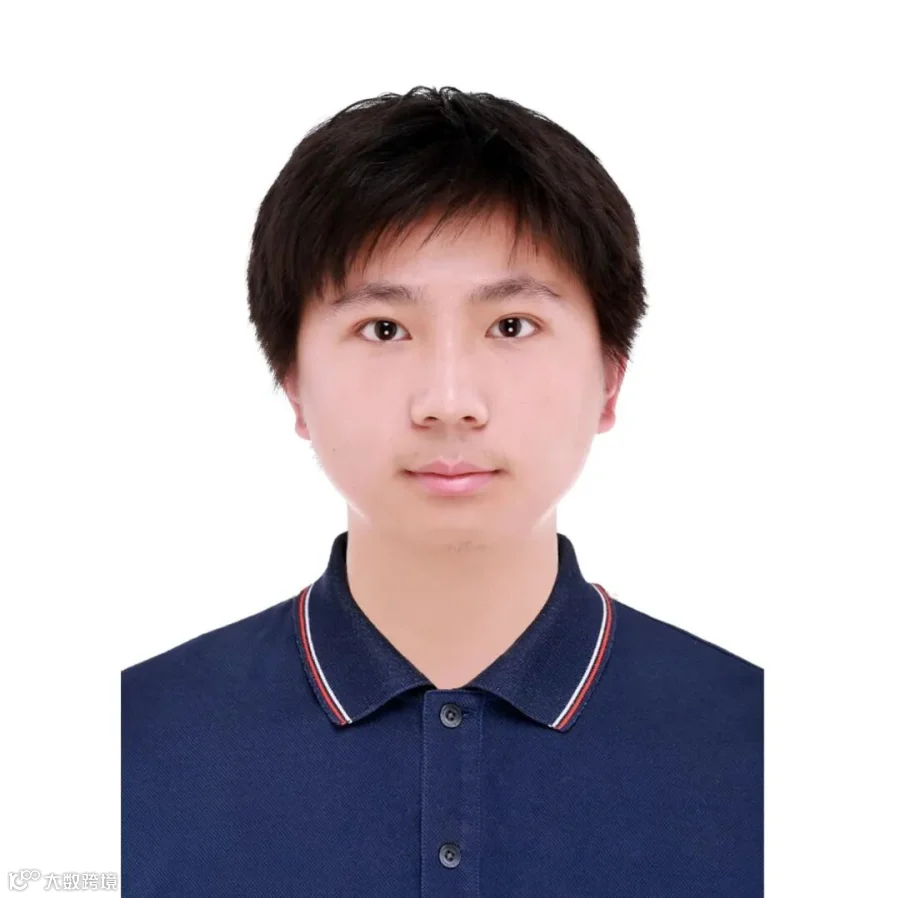
赵思杰
东京大学博士生,研究遥感智能体与递归自我改进
分享主题:最后一个由人类构建的遥感模型?——将任意地球观测任务转化为递归自我改进
报告简介:传统遥感模型依赖专家逐任务手工设计。本报告介绍 RSI4EO:将任意可验证的地球观测任务表述为“运行环境+封闭验证器”,由通用编码智能体自主编写和训练模型,并基于上一代模型输出迭代改进下一代。实验显示,智能体构建的模型在四个基准上超越现有最优方法,仅用 0.2%–1.4% 的标注数据即可保持 69%–84% 的精度。
拟讨论话题
| 序号 | 议题 |
| 话题一 | 回报不足以准确描述智能体利用记忆 |
| 话题二 | 奖励来源——可验证奖励 vs 内在奖励? |
| 话题三 | RSI——开放域智能体的递归自我进化,是工程问题还是原则性不可能? |
| 话题四 | 当智能体越来越自主,人类应该保留哪些决定权? |
观看方式
01
B站直播
哔哩哔哩直播通道
扫码关注 AITIME 哔哩哔哩官方账号预约直播

02
微信视频号直播
点击预约按钮接收直播提醒
关于 AI TIME
AI TIME 源起于 2019 年,旨在发扬科学思辨精神,邀请各界人士对人工智能理论、算法和场景应用的本质问题进行探索,加强思想碰撞,链接全球 AI 学者、行业专家和爱好者,希望以辩论的形式,探讨人工智能和人类未来之间的矛盾,探索人工智能领域的未来。
迄今为止,AI TIME 已经邀请了 2000 多位海内外讲者,举办了逾 800 场活动,超 2000 万人次观看。