


该研究聚焦临床现实痛点:右上腹(RUQ)超声是肝胆胰急症首选影像,但判读高度依赖操作者水平,报告书写耗时、不同阅片者一致性差。作者构建一套多任务视觉语言智能体(VLM),基于单中心9189例训练,在斯坦福、科罗拉多大学两个独立外部数据集完成验证;模型同时完成16项临床发现分类、超声诊断报告自动生成、胆囊切除术临床决策支持三项任务。盲法图灵测试显示,经过少量后期编辑的AI报告,放射科医生很难区分与专家手写报告的差异。该工作证明视觉语言模型有潜力提升超声诊断一致性、报告效率以及外科分诊能力,但模型尚不能替代医师,需要人类审核校对,仍需前瞻性临床验证。
论文信息

01 临床问题
现实问题:右上腹超声广泛用于胆结石、胆囊壁增厚、胆管扩张等肝胆疾病评估,直接指导外科决策;但超声受图像噪声、伪影、扫查操作差异、阅片医师经验影响,诊断一致性不稳定。传统CNN模型大多只能做单一任务(二分类、分割),难以完成多任务临床推理;现有医学视觉语言模型尚未拓展到超声动态视频片段(cine loop),缺少从图像判读‑报告生成‑外科决策的完整多任务超声AI系统。
研究难点
1.超声为变长动态视频序列,帧数量差异巨大,需要统一预处理适配模型输入;
2.原始临床报告为自由文本,缺少结构化标签,需要弱监督抽取标签用于模型训练;
3.不仅要做图像分类,还要生成符合放射科规范的临床报告,报告不能只看文本相似度,要保证临床事实准确;
4.不仅输出影像结果,还要支撑下游外科决策,同时需要多中心外部泛化验证+放射科医生盲法人工评测。
02 研究方法
输入什么
1.输入为临床右上腹超声动态cine视频序列(帧数20‑200不等),电子病历人口学信息、ICD诊断编码、原始放射科自由文本报告。
2.图像预处理:对变长超声视频做均匀时间采样,标准化到固定32帧;短序列循环补帧;裁剪扇形超声扫查区域,去除文字标记;图像resize到224×224,像素归一化。
3.标签获取:本地部署Llama3大模型,从原始自由文本报告抽取结构化二分类标签,覆盖肝脏、胆道、肾脏、胰腺、腹腔等,筛选患病率5%共16个标签用于训练。
模型框架(US‑Agent三阶段多任务智能体)
1.异常分类模块(USFM超声基础模型):基于ViT‑B/16超声预训练基础模型;对32帧图像提取特征,注意力聚合多帧特征得到患者级表征;输出16项病理发现的多标签分类概率。损失函数采用ASL非对称损失,搭配梯度裁剪、多标签Mixup、样本重加权处理类别不平衡。
2.胆囊切除手术预测模块:Llama3少样本二分类;输入可以是【人口学变量+ICD编码+人类原始报告/AI生成报告】,预测是否需要胆囊切除术。
怎么评测?两套评测体系
1.自动指标:
分类任务:AUROC、AP;设定90%、95%特异度阈值统计灵敏度;
报告生成:传统NLG指标(BLEU、ROUGE、METEOR、BERT‑F1);临床专用评测框架FORTE(程度、解剖标志、影像特征、诊断印象4维度F1)、DocLens(LLM‑as‑judge事实校验得分,抑制幻觉)。
2.人工盲法评测(图灵测试):放射科医生区分AI生成报告vs人类报告;分为原始未编辑AI报告、放射科医师后期校对编辑后的AI报告;设置仅文本、文本+超声图像两种条件;区分专家放射医师与住院医师两组阅片者。
03 研究设计
总数据集11001例右上腹超声图文序列

图1 右上腹超声临床流程与US-Agent模型整体框架
1.内部训练/测试队列:约翰霍普金斯大学JHU,9189例(594099张图像);时间2016‑07‑31至2023‑12‑31;过滤掉数据不全、图像质量差无法诊断的病例。
2.外部验证队列1:科罗拉多大学CU,1704例(90616张图像)
3.外部验证队列2:斯坦福大学Stanford,108例(3240张图像)
4.胆囊切除术预测子队列:从JHU筛选确诊胆囊炎2170例;80%训练(1736)、20%测试(434);金标准为电子病历手术操作编码。
伦理:3家机构IRB审批,全部为去标识回顾性数据,豁免知情同意。
验证安排
1.内部测试集评估分类性能;将JHU确定的固定特异度阈值直接迁移到两个外部队列,不重新调参,检验跨机构泛化;做消融对比USFM预训练骨干vs ImageNet预训练ResNet‑50。
2.报告生成:内部+两个外部队列同时评测;对比传统NLG指标与FORTE、DocLens临床指标。
3.手术预测:做输入模态消融实验(仅人口学;人口学+ICD;人口学+报告;人口学+ICD+报告),分别使用人类原始报告、AI生成报告做输入对比。
4.放射科医生盲态图灵测试,评估AI报告真实感;对比未编辑AI报告、医师校对后AI报告;分层专家/受训医师、有无图像辅助。
04 主要结果
1.病理异常分类结果
(1)JHU内部测试:宏AUROC=0.820,微AUROC=0.865;右侧胸腔积液(AUROC=0.926)、腹水(0.904)、肝脂肪变性(0.904)表现最优;仅“胰腺显示欠佳”AUROC=0.670性能有限。疾病患病率和模型AUROC无统计学相关(r=-0.040,p=0.874),说明模型对标签不平衡鲁棒。
(2)外部验证:CU队列宏AUROC=0.794;Stanford队列宏AUROC=0.775。
(3)固定阈值(JHU设定90%特异度)迁移到外部:腹水、脂肪肝、胆结石、胸腔积液保持可用灵敏度,适合分诊筛查。
(4)消融:USFM超声预训练骨干全面优于通用ResNet‑50,证明超声领域预训练价值。
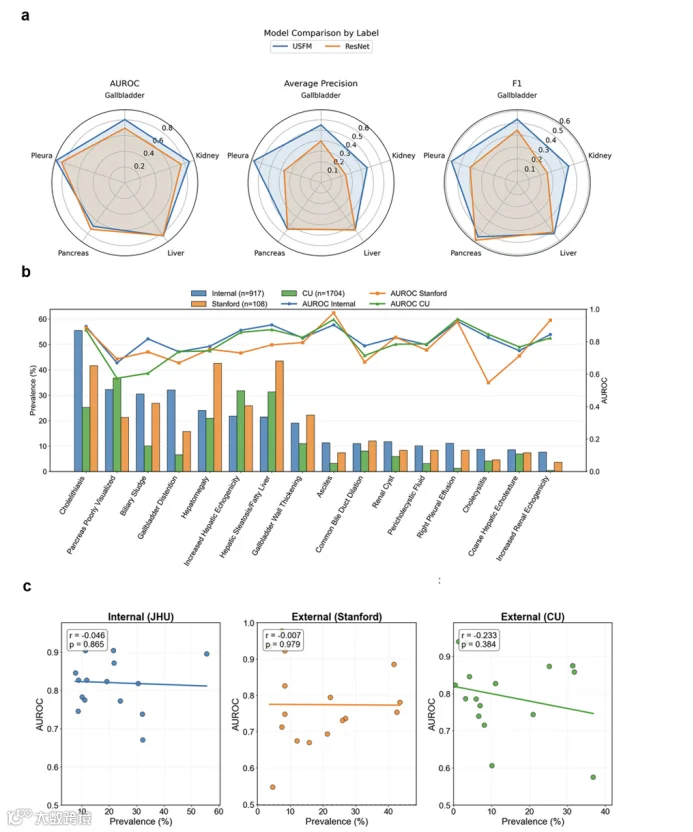
图2 USFM 模型在内部及外部验证队列中 16 项超声征象的分类性能
2.胆囊切除术预测结果
以【人口学+ICD编码+人类原始放射报告】全部特征输入为基准:准确率0.843,召回0.665。
把人类报告替换为VLM生成的AI报告后:准确率0.718,召回0.602。
虽然准确率下降,但召回保持较高水平,证明AI生成报告保留了外科决策所需要的核心临床信息,可作为下游任务有效代理;消融实验证实每一类输入模态(人口学、ICD、报告)均贡献预测信号。
05 学习借鉴
方法层面
1.真实世界超声数据处理方案:针对超声动态cine‑loop视频帧数长短不一的现实问题,采用均匀时间采样统一至固定帧数,兼顾时序信息与模型输入要求;面对临床缺少结构化标注的痛点,使用本地大模型从自由文本报告做弱监督标签抽取,同时必须搭配小样本人工校验,保障标签抽取的可靠性。
2.医学报告的综合评价思路:不局限于BLEU、ROUGE等文本相似度指标,引入FORTE、DocLens以临床事实为核心的评测工具,重点管控AI报告幻觉、关键影像特征漏写问题,更贴合医学文本的评估逻辑。
3.链式多任务架构设计:构建“图像异常分类‑报告生成‑下游临床决策”的串联工作流,前序模块输出作为后序任务输入,打通影像、文本、临床推理完整链路,而不是只做孤立的单任务图像分类。
4.贴近临床的验证方式:除AUC等机器量化指标外,增加放射科医生参与的盲法图灵测试,区分模型原始输出、医生修订后的AI辅助版本,还原AI‑医师协同的真实工作场景。
研究设计层面
1.将复杂临床目标拆解为多个子任务,影像分类、报告生成、结局预测分别设置自动指标+人工验证两套评价体系;
2.重视消融实验,开展骨干网络、输入模态的对比,内部数据集确定的阈值直接迁移外部队列、不重新调参,客观检验跨中心泛化能力;
3.人工评测设置多组对照变量,覆盖有无图像辅助、不同年资阅片者,模拟临床真实工作条件。
06 专科迁移
1.心脏超声领域:借鉴动态视频标准化采样、大模型抽取报告标签的方案,搭建多任务框架,实现心腔结构异常分类、自动报告生成,进一步探索介入或手术风险预测;研究过程需要配置独立外部验证集,同时增加超声医师盲态人工评测。
2.妇产/胎儿超声领域:将动态超声视频转换为固定帧输入,实现多标签征象分类联合报告生成;需要重点做好幻觉抑制,优先使用FORTE、DocLens这类临床事实指标校验报告内容质量。
3.CT/MRI其他影像模态:可以参考该链式多任务范式,完成影像特征提取、结构化报告生成,进一步延伸至下游临床事件预测;不能仅依赖机器自动指标,必须补充临床人员的盲法评估。
原文与复现入口
[1] Nat Commun17, 10587(2026).https://doi.org/10.1038/s41467-026-77498-w
参与瓴智医工协作:
希望发挥专业能力、参与项目协作,可通过「医工中心—入驻申请」提交专业背景与合作意向。
有科研问题、需要技术支持,可通过「业务合作—发布需求」描述研究目标与现有基础。
提交后由团队联系沟通。入驻申请不代表审核通过或保证获得项目。
编辑:陈宣辰
审核:吴朝

ICML 2026|PathwayLLM 把临床轨迹与结构化路径接入大模型
Nature Communications|多模态AI评估阿尔茨海默病标志物,顶刊证据链怎么搭?
Nature Biomedical Engineering(一区,IF=26.3)NeuroSTORM:面向功能磁共振 fMRI 的通用基础模型
Science(一区 ,IF=47.3)DAMO‑RADAR:面向腹部 CT 的专家级通用多模态诊断大模型