

导读DAS 是一套自动写学术综述的多 Agent 系统。它先组织文献、规划段落职责,再为具体论断安排引文,并通过审查和局部修复完善稿件。本文沿着这条流程解释“为什么在这里写”和“凭什么这样说”如何落实,再结合自动评分、专家盲评与消融实验,判断生成综述的质量及其边界。
本文 2895 字,阅读约 7 分钟
参考文献列得长,具体判断仍要有出处
先把论文变成可复用材料,再决定怎样分类
为什么在这里写,凭什么这样说
审查发现问题后,回到对应层级修复
生成的综述写得怎么样,哪些机制起了作用
把生成结果交给研究者继续核验
参考文献列得长,具体判断仍要有出处
一段综述可能列了十几篇论文,却没有交代清楚:哪篇支持方法分类,哪篇提供实验结果,又有哪些只是背景材料。读者看到的是一串编号,想核验具体判断时,仍得重新寻找证据。
综述论文要组织、比较和评价已有研究,让读者理解一个领域有哪些路线、结论和待解问题。它的贡献在于综合分析,而不仅是把各篇论文缩写后拼起来。因此,怎样分类、怎样比较、哪些结论由哪些文献支持,都属于写作的核心工作。
2026 年 8 月 18 日首次提交至 arXiv 的 Deep Academic Survey 论文,介绍了浙江大学、上海交通大学团队提出的 DAS 系统。这篇研究论文提出自动综述方法,再用生成的综述评估效果:一方面解释系统如何工作,另一方面检验它写出的稿件质量。
DAS 采用多 Agent 工作流,将规划、写作和审查等任务交给不同的智能体角色。各角色读取和更新共享的材料与计划,后续步骤使用前面的结果继续工作。
理解这套系统,可以抓住两件事:这一段为什么写,段落中的判断凭什么成立。前者关乎内容的职责,后者关乎证据支持。DAS 把这些安排保存下来,供写作和后续修稿使用。
先把论文变成可复用材料,再决定怎样分类
DAS 的基础是 DAS-2M,一个存储结构化论文信息的文献库。论文报告的实验快照覆盖 2020 年 1 月至 2026 年 6 月间约 200 万篇 arXiv 论文。
系统先用文档解析工具 MinerU 提取 PDF 内容,再让大模型整理方法、数据集、实验发现和局限等信息。这样,不同综述选题可以复用同一篇论文的分析结果,减少重复读取全文的工作。系统也设计了持续补充新论文的处理流程。
用户输入主题后,系统通过关键词和语义检索找出候选文献。接下来构建 Taxonomy,也就是组织研究方向及其层级关系的分类树。每个节点都有讨论范围和写作目标,分类会参考实际检索到的论文内容。
分类确定后,论文路由器逐篇判断候选材料能够支持哪些章节。一篇论文可以分配到多个相关节点,也可以因为关联不足而不被采用。这一步给后续写作划出了可用文献的范围。
用一个假设的机器人操作综述举例:一篇同时讨论视觉感知和动作学习的论文,可能进入两个相关章节。路由器需要依据其实际内容,分别判断它能为各章节提供什么材料。
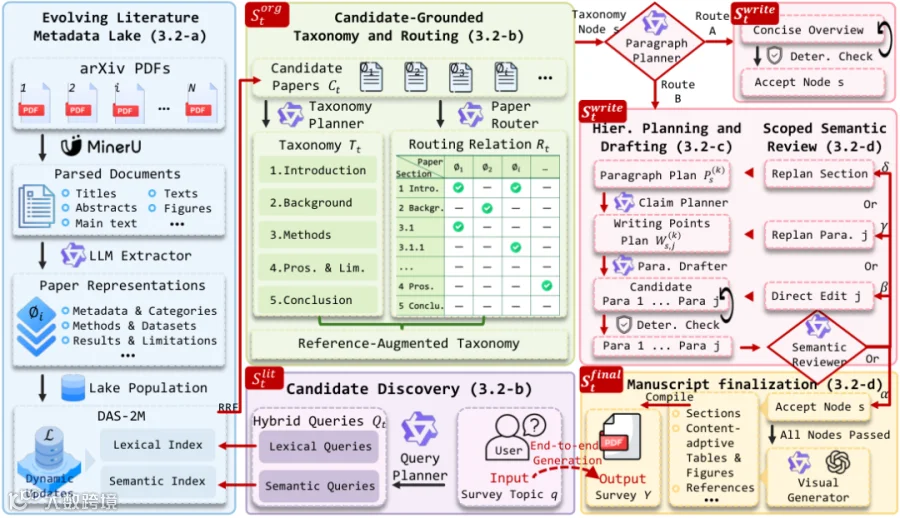 左侧是可复用的文献表示,中间建立分类与论文分配,右侧展开写作和审查修复;红色回路表示受影响部分可以重新执行。 | 来源:DAS 论文 v1,Figure 2
为什么在这里写,凭什么这样说
有了章节和候选文献,还需要决定各段怎样推进。DAS 会先区分节点的写作需求:导航性质或文献不足以支持多段技术讨论的节点,只生成简短概述;其余节点进入分层规划、写作与语义审查流程。
在需要深入展开的小节里,段落规划器先决定各段讲什么、承担怎样的论证职责,以及使用哪些已分配的论文。沿用机器人操作的例子,一段可以解释视觉方法怎样处理遮挡,下一段比较各项实验的遮挡条件,避免把不同条件下的成绩直接放在一起判断优劣。
随后,论断规划器把每段拆成具体写作点,为每个预期判断配上支撑它的引文组和必要技术细节。写作智能体根据这些计划生成段落。段落计划安排论述怎样推进,论断与引文计划落实判断的依据。
例如,要写“这种方法改善了遮挡条件下的表现”,就需要找到支持这个判断的实验条件与结果。把论文分到“视觉感知”章节,只确认了相关性;具体论断是否成立,还要再检查一次。
多篇论文共同支持同一个判断时,可以组成引文组。同一篇论文再次出现时,也应支持不同的具体方面。如果结构化记录缺少必要细节,规划器可以对相应原文发起有范围限制的定向查询,把取得的证据附到写作点上。
这也解释了为什么不必每句话都附引用:过渡句负责承接,结构说明帮助定位;具体事实、实验结果和跨论文比较,才需要相应的证据。关键是读者能够分清各个引用支持哪些判断。
DAS 在章节、段落和论断层级记录写作安排。这些计划为检查提供了入口,实际生成的内容是否履行计划、是否准确使用证据,还要由下一步审查。
审查发现问题后,回到对应层级修复
DAS 用共享的稿件状态保存候选文献、分类与分配关系、段落计划、草稿、审查结果,以及最终图表和稿件文件。这里的“状态”,就是流程运行中明确记录、能够继续更新的中间产物。
检查分成两类。确定性校验按程序规则处理引用编号、未解决的占位符、格式和排版语法等约束;语义审查由智能体判断内容是否切题、段落是否递进、是否重复,以及核心论断有没有文献支持。
语义审查发现缺陷后,可以选择不同范围的修复:
•直接修改段落:保留计划,调整现有草稿。
•重新规划段落:保留小节的段落安排,重做该段的论断、引文计划和正文。
•重新规划整个小节:重建段落安排,并重做依赖它的写作内容。
修复后的段落要再次通过确定性校验,小节重新组装后再接受语义审查。这样,系统可以按问题范围返工,而无需每次重写全文。
不过,重试预算耗尽时,DAS 会保留最近一个通过确定性校验的完整版本作为回退。它可能还没有通过语义审查。能编译、文件完整,与内容已获审查接受,需要分开判断。
最终组装环节继续处理图表、参考文献、交叉引用和 LaTeX 文件,编译得到 PDF。
生成的综述写得怎么样,哪些机制起了作用
作者让各系统围绕给定主题生成综述,再评价稿件。评测集 DAS-Bench 包含 30 个主题,其中 21 个属于计算机科学,9 个来自其他领域。评分体系 DAS-Eval 检查引文质量、文献分类综合、篇章论述和稿件组装可靠性,每个维度有四项指标,采用 1–5 分量表。
自动评分和专家盲评是两条不同的证据。自动评分由多模态大模型裁判结合稿件页面和结构化引文信息完成,主裁判为 Qwen3.5;人工评估则隐藏系统身份,由三位外部评估者比较稿件。
在完成全部 30 个主题的系统中,DAS 生成综述的自动评分总均分为 4.34,Naive RAG 为 4.03,均为 16 项指标的平均值。Naive RAG 是直接利用共享论文元数据写作的基线,没有显式分类规划和审查。
人工盲评中,DAS 的稿件在 27/30 个主题上获得相对 Naive RAG 的多数票偏好;与另一套自动综述系统 AutoSurvey 比较时,在共同覆盖的 21 个主题中获得 19 次多数票偏好。
这些作者报告的结果,支持 DAS 在所设任务和评价标准下具有稿件质量优势。比较仍受配置约束:闭源研究系统使用原生配置,可复现系统保留原有流程并统一生成骨干,检索资源也未全部统一。因此,这是一组系统配置之间的比较,不能归结为某个基座模型全面更强。
大模型长程 Agent 怎么测?美团工业级评测体系与双环演进实践
稿件整体表现更好,还需要解释哪些设计起了作用。为此,作者用消融实验逐一移除组件:移除论文到章节的路由后,文献组织维度从 4.22 降到 4.10;移除语义审查后降到 4.06。完整系统成功编译 30/30 篇稿件,移除确定性验证的版本为 27/30。
但并非所有组件都让所有分数上升。移除分类规划后,文献组织维度下降,部分其他指标改善,总均分从 4.34 略升至 4.35。不同组件存在取舍,不能因为完整系统得分较高,就推定每个设计都有全面增益。
 作者展示的代表性样稿页面:上方标注了引文堆叠、归属粗糙等问题,下方展示 DAS 的分类、图表与论断引用组织;这是选定页面的定性比较。 | 来源:DAS 论文 v1,Figure 3
时间口径也要说准确。附录报告 DAS 平均每篇用时 1.49 小时,按五任务并发条件下,单篇从启动到生成原始中等长度 PDF 计时。它复用了提前构建的文献库,不能理解为从零读完近 200 万篇论文再完成写作。
把生成结果交给研究者继续核验
DAS 的实验文献快照有明确覆盖范围,较早工作、非 arXiv 论文、书籍和领域数据库仍可能缺失。自动提取也可能漏掉条件或误写结果;分类和写作再完整,也可能建立在不完整的材料上。
人工盲评没有逐条核验每个领域的技术判断,不同模型裁判的细粒度评分也存在差异。因此,稿件评分与偏好结果可以说明相对质量,尚不能证明生成的综述可以直接投稿或获得录用。
截至 2026 年 10 月 18 日核验,官方仓库已公开评测工具、文献元数据和 220 篇生成样稿,核心生成方法代码仍标为待发布。
因此,我会把 DAS 的价值理解为:它给自动综述留下了写作目的、证据支持与修改过程的记录。研究者拿到稿件后,既能检查内容是否完成了所在段落的任务,也能沿着具体论断和引文回查依据。投稿前的专业核验,仍要落实到原始文献和具体判断上。
参考资料
•Deep Academic Survey:方法、实验与限制,arXiv v1 完整论文: https://arxiv.org/pdf/2608.18034v1
•DAS 官方仓库:组件发布状态、评测说明与生成样稿: https://github.com/ZhikaiXu24/DAS
文章仅做学术分享,如有侵权请联系删除,非常感谢!