

浮点乘法是处理器中最基础也最常用的运算之一。无论是神经网络的矩阵乘、图形渲染的顶点变换,还是科学计算里的向量点积,背后都离不开它。这篇文章从解包开始,一步步搭出一个 3 级流水的 FP32 乘法器,最后扩展到数组接口。代码贯穿始终,每段代码配上解释与图表。
📌 本文所有代码均为可综合的 SystemVerilog,舍入模式采用 IEEE 754 默认的 RNE(最近偶数)。
一、先想清楚:浮点乘法到底在算什么
浮点数不是普通的二进制数。一个 IEEE 754 单精度浮点数由三部分组成:1 位符号、8 位指数、23 位尾数。它表示的值是:
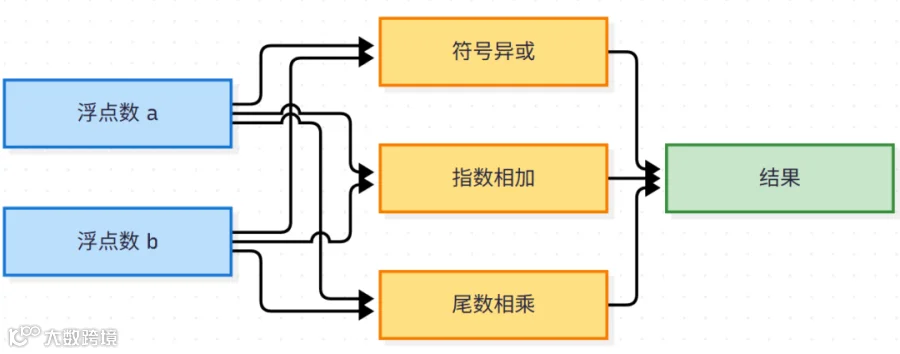
两个浮点数相乘,就是把它们的符号、指数、尾数分别处理:
这就是浮点乘法比浮点加法简单的地方。浮点加法要先对阶,两个数的指数差多少,尾数就要移多少位,还要处理大数吃小数、前导零检测等。浮点乘法不需要对阶,尾数直接乘,乘积范围固定在 之间,规格化最多右移一位。
二、解包:把 32 位拆开
拿到一个 32 位输入,第一件事是把它拆成符号、指数、尾数三段。这段代码是整个设计的起点:
   assign sa = a[31];
assign ea = a[30:23];
assign fa = a[22:0];

assign sb = b[31];
assign eb = b[30:23];
assign fb = b[22:0];
这里没有做任何运算,只是把线网切开。综合工具看到这几行,只会接几根线,几乎不消耗逻辑资源。
三、识别特殊值
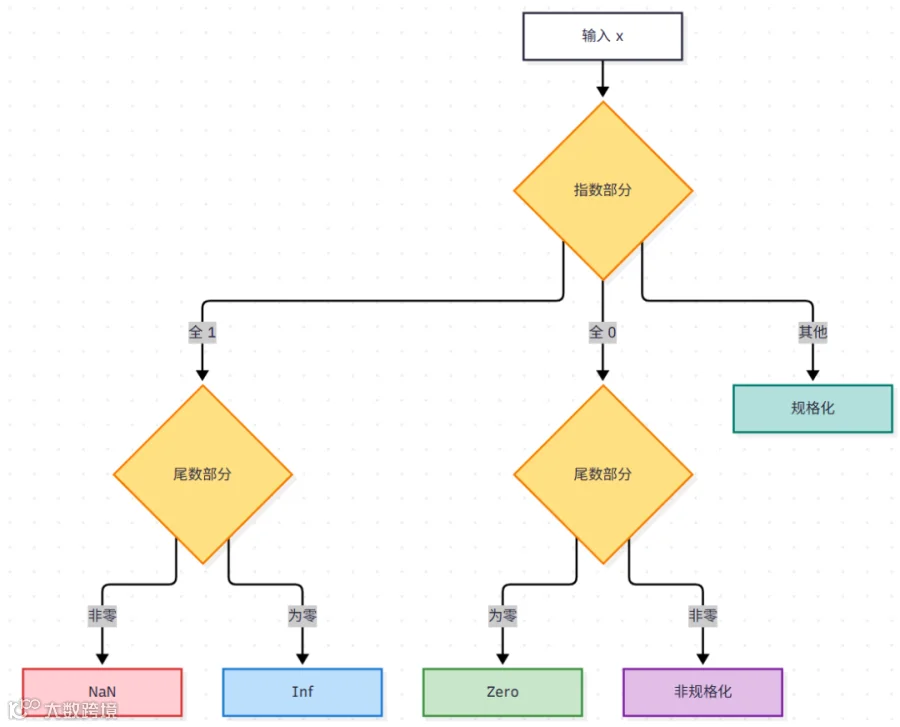
浮点数里有一批特殊值,不能按正常流程算。比如 NaN 乘任何数都是 NaN,Inf 乘 0 是 NaN,Inf 乘非零是 Inf,0 乘非零是 0。这些情况必须在主数据通路之外单独判断:
   assign a_nan  = (ea == 8'hFF) && (fa != 0);
assign b_nan  = (eb == 8'hFF) && (fb != 0);
assign a_inf  = (ea == 8'hFF) && (fa == 0);
assign b_inf  = (eb == 8'hFF) && (fb == 0);
assign a_zero = (ea == 0)      && (fa == 0);
assign b_zero = (eb == 0)      && (fb == 0);
这几个表达式的逻辑很直白:
四、非规格化数的修正
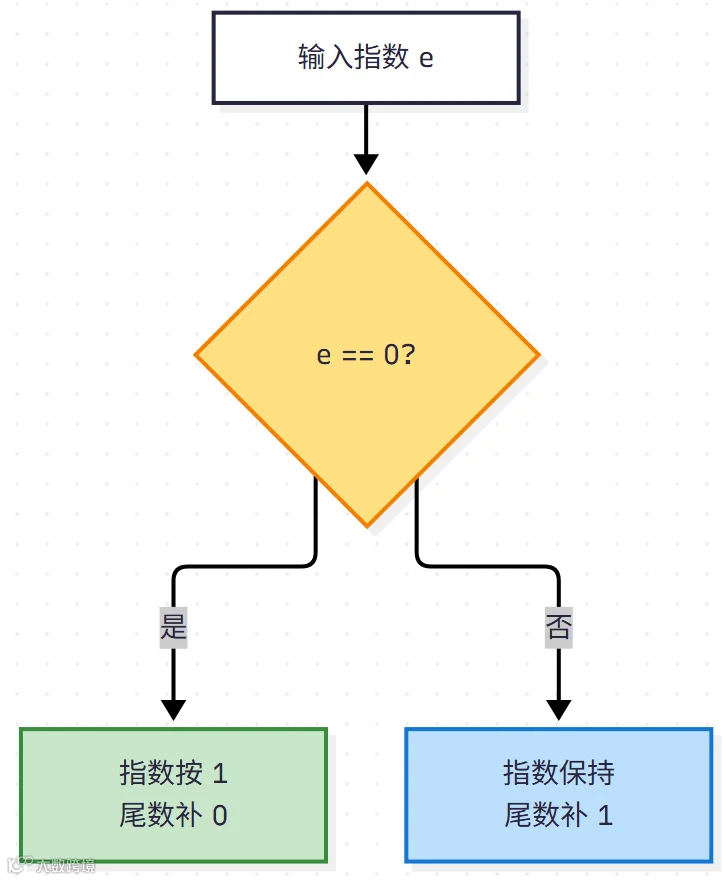
非规格化数的指数编码是 0,但它的实际指数按 1 处理。同时它的尾数没有隐含的整数位 1,只有一个 0。所以要把这两个修正统一做掉:
   assign ea_adj = (ea == 0) ? 8'd1 : ea;
assign eb_adj = (eb == 0) ? 8'd1 : eb;
assign ma     = (ea == 0) ? {1'b0, fa} : {1'b1, fa};
assign mb     = (eb == 0) ? {1'b0, fb} : {1'b1, fb};
这段代码的含义是:对规格化数,尾数前面补一个 1,变成 24 位;对非规格化数,尾数前面补一个 0,也变成 24 位。这样后面做乘法时,输入永远是 24 位,不用再分支。
五、符号与指数
符号最简单,一个异或门就够:
s1_sign <= sa ^ sb;
指数相加时要注意位宽。8 位加 8 位可能产生 9 位结果,所以要先扩展一位再相加:
s1_exp_sum <= {1'b0, ea_adj} + {1'b0, eb_adj};
六、尾数乘法
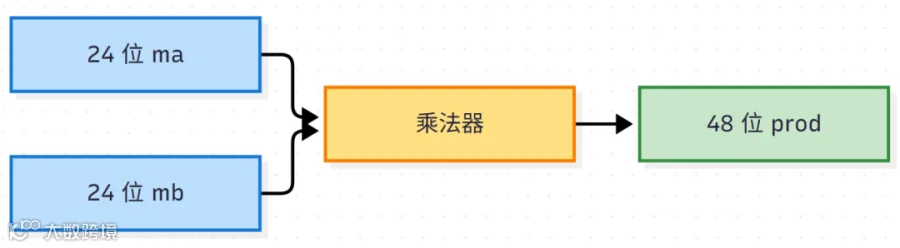
两个 24 位尾数相乘,得到一个 48 位乘积:
assign prod = s1_ma * s1_mb;
这一步是整个设计里最耗资源的部分。综合工具会把它映射到 DSP 硬核,或者用 Booth 编码 + Wallace 树 实现。乘积的范围是:
为什么是 46 或 47?因为 1.0 乘 1.0 等于 1.0,最高位在 bit 46;1.5 乘 1.5 等于 2.25,最高位在 bit 47。乘积的隐含位要么在 46 要么在 47,不会更靠前,也不会更靠后。
七、找最高位
乘积是 48 位,最高位不一定在 bit 47。为了做规格化,要先找到最高位的位置:
   always_comb begin
    msb_idx = 6'd0;
    for (int i = 0; i < 48; i++)
        if (prod[i]) msb_idx = i[5:0];
end
这个循环从低位扫到高位,遇到 1 就更新 msb_idx,最后留下的就是最高位的位置。综合后它是一个 48 位优先编码器,本质是一串多级 MUX。

八、规格化
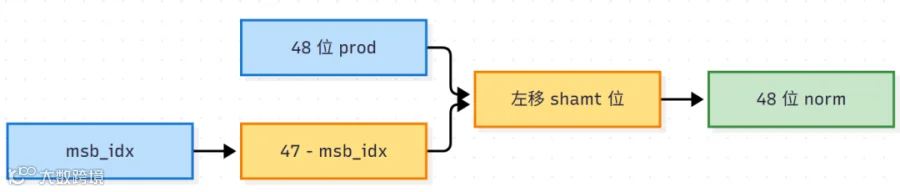
规格化的目的是把最高位对齐到 bit 47,这样尾数的隐含 1 就统一在 bit 47 上:
   assign shamt = 6'd47 - msb_idx;
assign norm  = s2_prod << shamt;
左移量等于 47 减去最高位位置:
这个移位器综合后是一个 6 级桶形移位器,每一级都是一个 2:1 MUX,根据 shamt 的某一位决定移不移。
九、指数计算
指数不能直接用 ea_adj + eb_adj,因为还要补偿尾数乘法的隐含位偏移。完整的公式是:
   assign exp_biased = $signed({3'b0, s2_exp_sum})
                  + $signed({6'b0, msb_idx})
                  - 12'sd173;
173 这个数字怎么来的?
✅ 验证:1.0 × 1.0,ea_adj = 127,eb_adj = 127,msb_idx = 46,代入得 ,即真实值 1.0。
✅ 验证:1.5 × 1.5,msb_idx = 47,代入得 ,即真实值 2.25。
十、取尾数
规格化之后,尾数的隐含 1 在 bit 47,接下来的 23 位是小数部分:
assign mant24 = norm[47:24];
mant24 是 24 位,其中最高位是隐含 1,低 23 位是小数。但这时还不能直接输出,因为低位可能被丢弃,需要舍入。
十一、舍入
IEEE 754 默认的舍入模式是 RNE(Round to Nearest Even,最近偶数)。它需要三个位来判断:
   assign guard  = norm[23];
assign sticky = |norm[22:0];
assign lsb    = mant24[0];
舍入规则是:如果 guard 为 1 且(sticky 为 1 或 lsb 为 1),就进位;否则不进位。写成代码:
   always_comb begin
    if (guard && (sticky || lsb))
        mant_rnd = {1'b0, mant24} + 1'b1;
    else
        mant_rnd = {1'b0, mant24};
end

十二、舍入溢出
舍入时可能发生进位溢出。比如尾数全是 1,加 1 之后就会变成 25 位:
   always_comb begin
    if (mant_rnd[24]) begin
        mant_final = mant_rnd[24:1];
        exp_final  = exp_biased + 12'sd1;
    end else begin
        mant_final = mant_rnd[23:0];
        exp_final  = exp_biased;
    end
end
这和十进制里 9.99 进位成 10.0 类似,尾数右移一位,指数加一。
十三、打包与特殊值
正常结果的打包分几种情况:
   always_comb begin
    if (s3_zero_prod)
        y_norm = {s3_sign, 31'd0};
    else if (s3_exp >= 12'sd255)
        y_norm = {s3_sign, 8'hFF, 23'd0};
    else if (s3_exp <= 12'sd0)
        y_norm = {s3_sign, 31'd0};
    else
        y_norm = {s3_sign, s3_exp[7:0], s3_mant[22:0]};
end
特殊值的优先级选择:
   always_comb begin
    if (s3_a_nan || s3_b_nan)
        y_result = {s3_sign, 8'hFF, 23'h400000};
    else if (s3_a_inf || s3_b_inf) begin
        if ((s3_a_inf && s3_b_zero) || (s3_b_inf && s3_a_zero))
            y_result = {s3_sign, 8'hFF, 23'h400000};
        else
            y_result = {s3_sign, 8'hFF, 23'd0};
    end
    else if (s3_a_zero || s3_b_zero)
        y_result = {s3_sign, 31'd0};
    else
        y_result = y_norm;
end

十四、纯组合版本的问题
如果把上面所有逻辑放在一个 always_comb 里,中间不插寄存器,那么综合工具看到的是一条从输入到输出的串联路径:
   always_comb begin
    // 解包
    // 特殊值判断
    // 指数相加
    // 尾数乘法
    // 规格化
    // 舍入
    // 打包
end
always_ff @(posedge clk) y <= result;
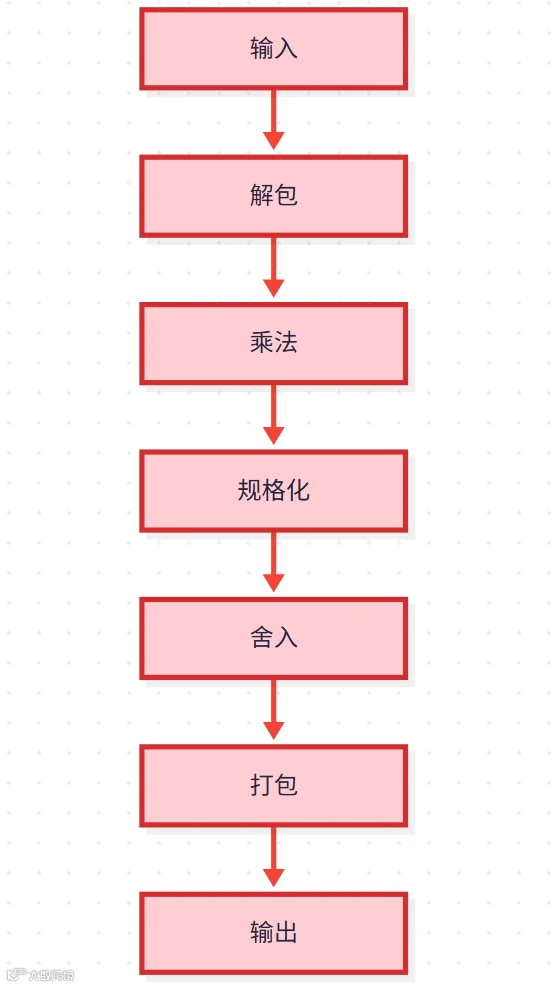
⚠️ 关键路径是所有这些延迟之和。乘法器本身就要几纳秒,再加上优先编码器、移位器、舍入 MUX,整条路径可能十几纳秒,频率只能跑到几十兆赫兹。这就是纯组合版本的瓶颈。
十五、插入寄存器:3 级流水线
解决方案是在关键位置插入寄存器,把长路径切成几段。每一段单独算延迟,周期只取最慢的那一段:
   always_ff @(posedge clk) s1_ma   <= ma;
always_ff @(posedge clk) s2_prod <= prod;
always_ff @(posedge clk) s3_mant <= mant_final;
always_ff @(posedge clk) y       <= y_packed;
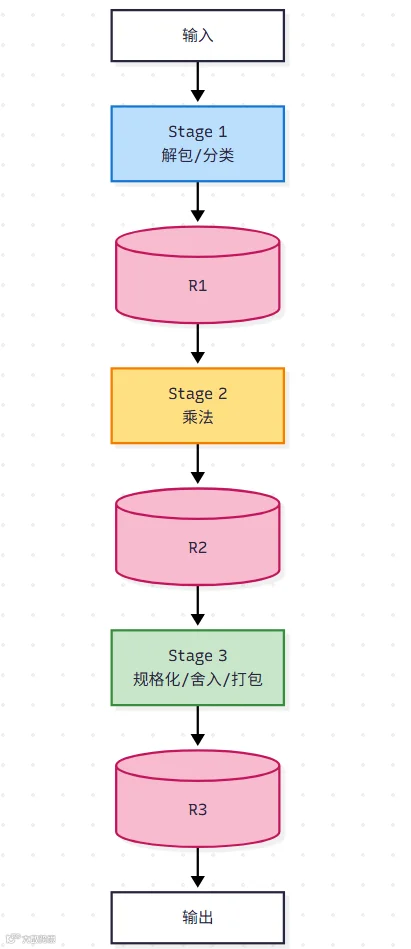
三级的分工:
十六、第一级寄存器
第一级寄存器的写法:
   always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        s1_valid   <= 1'b0;
        s1_sign    <= 1'b0;
        s1_ma      <= 24'd0;
        s1_mb      <= 24'd0;
        s1_exp_sum <= 9'd0;
    end else begin
        s1_valid   <= in_valid;
        s1_sign    <= sa ^ sb;
        s1_ma      <= ma;
        s1_mb      <= mb;
        s1_exp_sum <= {1'b0, ea_adj} + {1'b0, eb_adj};
    end
end
📝 注意 s1_valid 直接来自 in_valid,因为这是第一级。后面的级就不一样了。
十七、第二级寄存器
   always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        s2_valid   <= 1'b0;
        s2_sign    <= 1'b0;
        s2_prod    <= 48'd0;
        s2_exp_sum <= 9'd0;
    end else begin
        s2_valid   <= s1_valid;
        s2_sign    <= s1_sign;
        s2_prod    <= prod;
        s2_exp_sum <= s1_exp_sum;
    end
end
📝 注意 s2_valid 来自 s1_valid,不是来自 in_valid。这是流水线里 valid 传递的关键:valid 和数据一起走,每经过一级寄存器就存一次。
十八、第三级寄存器
   always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        s3_valid <= 1'b0;
        s3_sign  <= 1'b0;
        s3_mant  <= 24'd0;
        s3_exp   <= 12'd0;
    end else begin
        s3_valid <= s2_valid;
        s3_sign  <= s2_sign;
        s3_mant  <= mant_final;
        s3_exp   <= exp_final;
    end
end
第三级存的是规格化和舍入后的结果。
十九、输出寄存器
   always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        out_valid <= 1'b0;
        y         <= 32'd0;
    end else begin
        out_valid <= s3_valid;
        y         <= y_result;
    end
end
输出寄存器是最后一级,把打包后的结果和 valid 一起送出。
二十、valid 传递链
数据和 valid 是两条并排的路径:
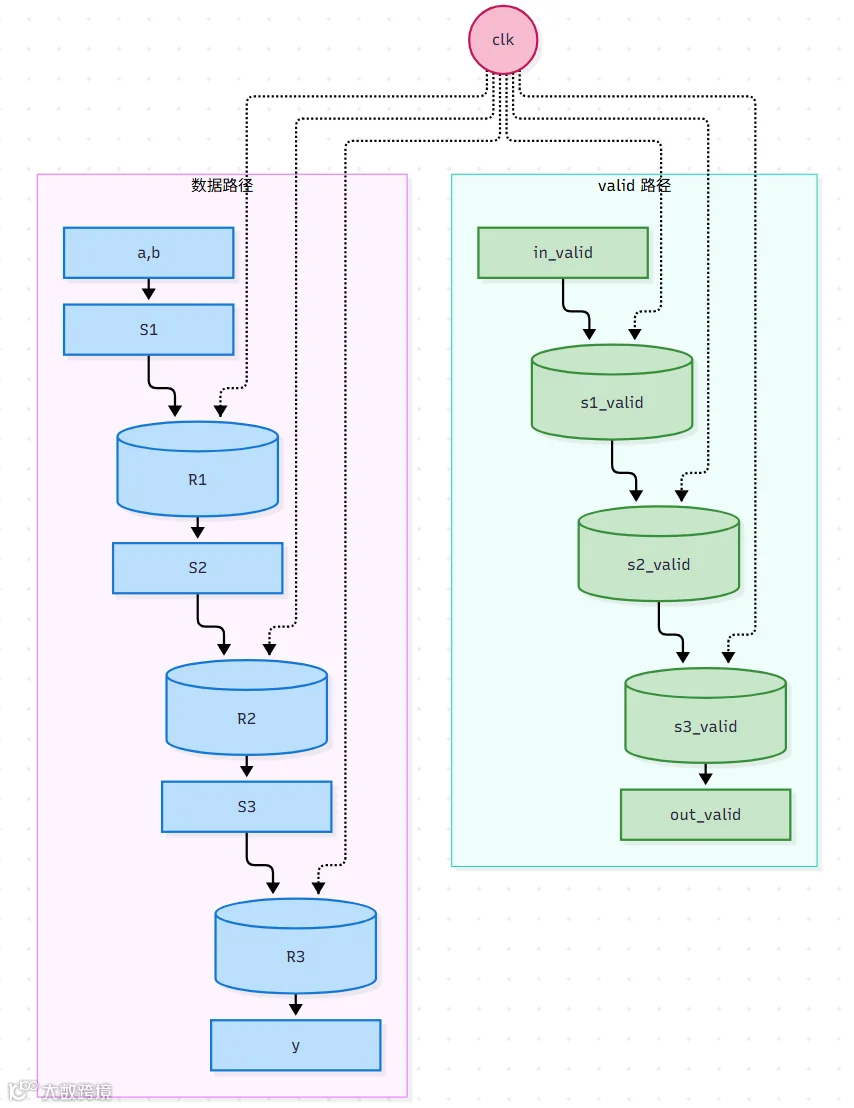
各级 valid 的含义:
⚠️ 同一拍里,s1_valid、s2_valid、s3_valid 描述的是三个不同数据,所以不能用它们全部相与来判断输出是否有效。正确的做法是只取最后一级:
   always_ff @(posedge clk or negedge rst_n)
    if (!rst_n) out_valid <= 1'b0;
    else        out_valid <= s3_valid;
二十一、三级并行的时间关系
三级流水的意义在于,同一时刻不同 stage 在处理不同数据:
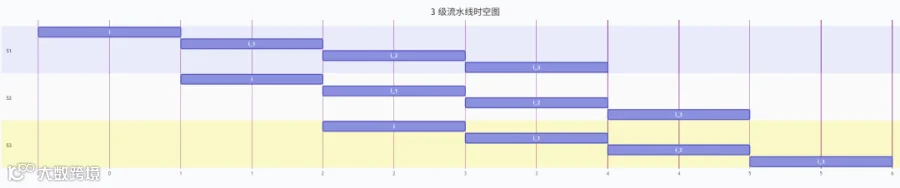
第 3 拍时,S1 处理 i+2,S2 处理 i+1,S3 处理 i。三个数据在三条不同的路径上,互不干扰。

二十二、同一时钟沿的作用
所有边界寄存器由同一个时钟沿驱动,这是流水线能工作的根本:
   always_ff @(posedge clk or negedge rst_n) s1_ma   <= ma;
always_ff @(posedge clk or negedge rst_n) s2_prod <= prod;
always_ff @(posedge clk or negedge rst_n) s3_mant <= mant_final;
always_ff @(posedge clk or negedge rst_n) y       <= y_result;
时钟沿到来时,所有寄存器同时采样、同时切换:
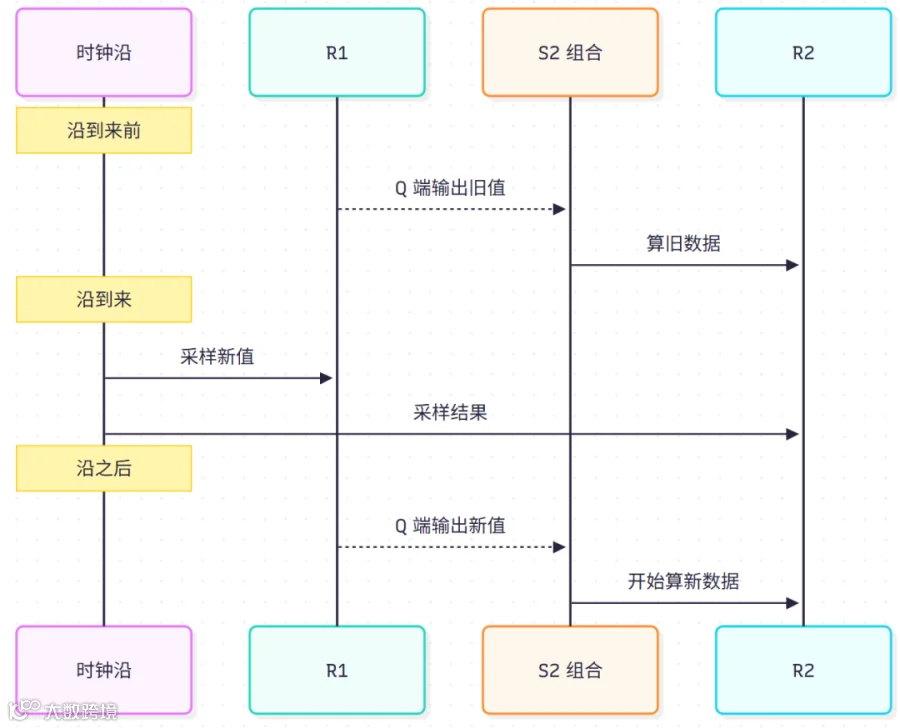
💡 因为所有寄存器在同一个瞬间切换,每一级看到的上一拍数据是对齐的。如果 R1 和 R2 用不同时钟,就会出现 R1 已更新、R2 还没更新 的错位,数据就乱了。
二十三、周期由最慢级决定
既然所有寄存器在同一个时钟沿采样,那么时钟周期必须大于最慢那一级的延迟:

一拍内的时间分配:
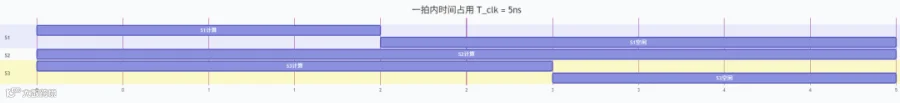
💡 S2 占满整拍,S1 和 S3 有空闲。空闲时间无法被利用,因为寄存器只在时钟沿统一更新。如果 S2 太慢,就把它拆成两级:
   always_ff @(posedge clk) partial <= booth_encode(s1_ma, s1_mb);
always_ff @(posedge clk) prod    <= wallace_tree(partial);
这样最慢一级变小,周期可以缩短,代价是多一级寄存器和一拍延迟。
二十四、子模块划分
把组合逻辑拆成子模块,顶层只放寄存器,这样结构清晰,也方便替换:
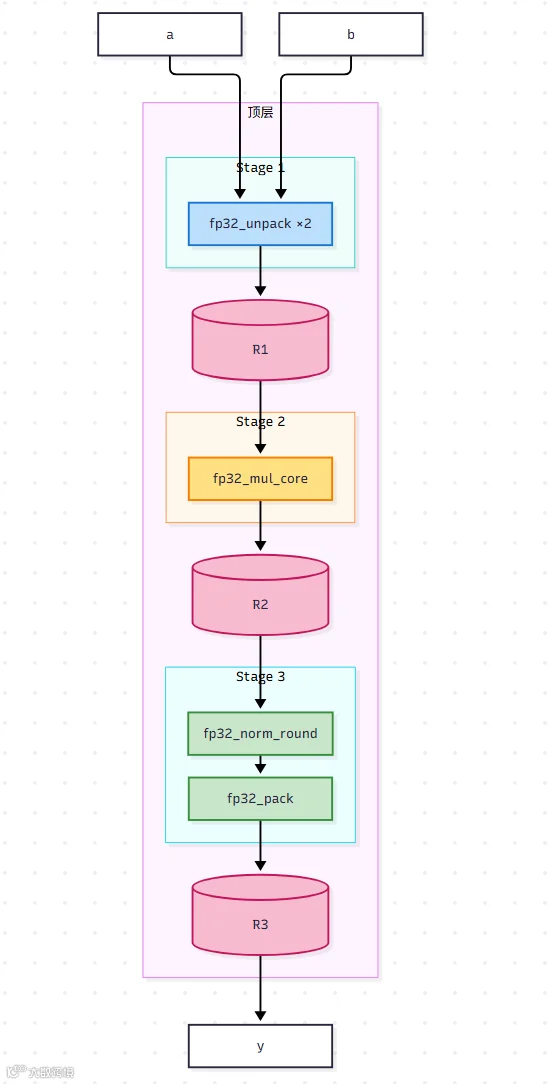
二十五、子模块代码
解包模块:
   module fp32_unpack (
    input  logic [31:0] x,
    output logic        sign,
    output logic [7:0]  exp_raw,
    output logic [22:0] frac,
    output logic        is_nan,
    output logic        is_inf,
    output logic        is_zero,
    output logic [7:0]  exp_adj,
    output logic [23:0] mant
);
    assign sign    = x[31];
    assign exp_raw = x[30:23];
    assign frac    = x[22:0];

    assign is_nan  = (exp_raw == 8'hFF) && (frac != 0);
    assign is_inf  = (exp_raw == 8'hFF) && (frac == 0);
    assign is_zero = (exp_raw == 0)      && (frac == 0);

    assign exp_adj = (exp_raw == 0) ? 8'd1 : exp_raw;
    assign mant    = (exp_raw == 0) ? {1'b0, frac} : {1'b1, frac};
endmodule
乘法模块:
   module fp32_mul_core (
    input  logic [23:0] ma,
    input  logic [23:0] mb,
    output logic [47:0] prod
);
    assign prod = ma * mb;
endmodule
规格化舍入模块:
   module fp32_norm_round (
    input  logic [47:0] prod,
    input  logic [8:0]  exp_sum,
    output logic [23:0] mant_final,
    output logic [11:0] exp_final,
    output logic        is_zero_prod
);
    // 找最高位
    logic [5:0] msb_idx;
    always_comb begin
        msb_idx = 6'd0;
        for (int i = 0; i < 48; i++)
            if (prod[i]) msb_idx = i[5:0];
    end

    // 规格化
    logic [5:0]  shamt;
    logic [47:0] norm;
    assign shamt = 6'd47 - msb_idx;
    assign norm  = prod << shamt;

    // 指数
    logic signed [11:0] exp_biased;
    assign exp_biased = $signed({3'b0, exp_sum})
                      + $signed({6'b0, msb_idx})
                      - 12'sd173;

    // 舍入
    logic [23:0] mant24;
    assign mant24 = norm[47:24];

    logic guard, sticky, lsb;
    assign guard  = norm[23];
    assign sticky = |norm[22:0];
    assign lsb    = mant24[0];

    logic [24:0] mant_rnd;
    always_comb begin
        if (guard && (sticky || lsb))
            mant_rnd = {1'b0, mant24} + 1'b1;
        else
            mant_rnd = {1'b0, mant24};
    end

    always_comb begin
        if (mant_rnd[24]) begin
            mant_final = mant_rnd[24:1];
            exp_final  = exp_biased + 12'sd1;
        end else begin
            mant_final = mant_rnd[23:0];
            exp_final  = exp_biased;
        end
    end

    assign is_zero_prod = (prod == 48'd0);
endmodule
打包模块:
   module fp32_pack (
    input  logic        sign,
    input  logic [11:0] exp_final,
    input  logic [23:0] mant_final,
    input  logic        is_zero_prod,
    input  logic        a_nan, b_nan,
    input  logic        a_inf, b_inf,
    input  logic        a_zero, b_zero,
    output logic [31:0] y
);
    logic [31:0] y_norm;
    always_comb begin
        if (is_zero_prod)
            y_norm = {sign, 31'd0};
        else if (exp_final >= 12'sd255)
            y_norm = {sign, 8'hFF, 23'd0};
        else if (exp_final <= 12'sd0)
            y_norm = {sign, 31'd0};
        else
            y_norm = {sign, exp_final[7:0], mant_final[22:0]};
    end

    always_comb begin
        if (a_nan || b_nan)
            y = {sign, 8'hFF, 23'h400000};
        else if (a_inf || b_inf) begin
            if ((a_inf && b_zero) || (b_inf && a_zero))
                y = {sign, 8'hFF, 23'h400000};
            else
                y = {sign, 8'hFF, 23'd0};
        end
        else if (a_zero || b_zero)
            y = {sign, 31'd0};
        else
            y = y_norm;
    end
endmodule
二十六、数组接口:N 路并行
如果一次要算很多组乘法,最简单的方式是例化 N 份独立的流水线:
   generate
    for (genvar k = 0; k < N; k++) begin : g_pipe
        // 每路独立的 unpack / mul / norm / pack
    end
endgenerate
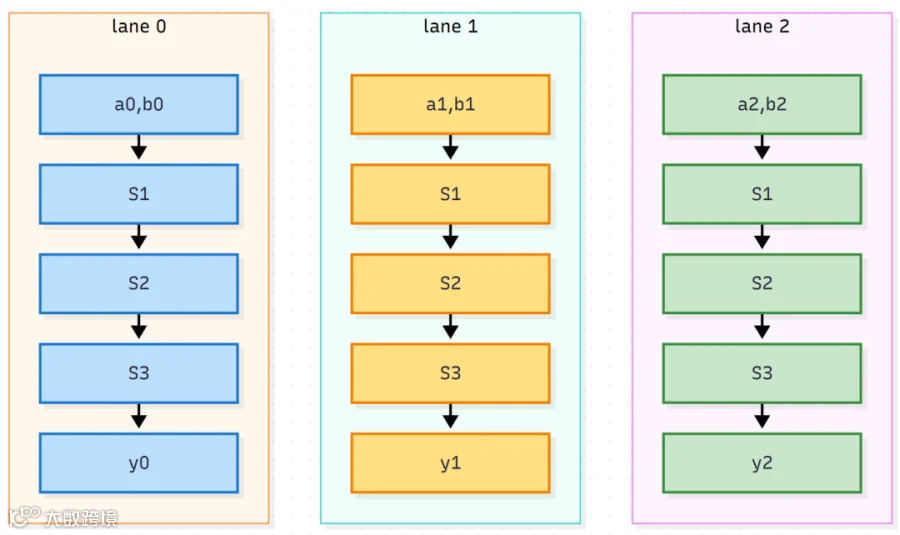
这种方式吞吐最高,但面积也最大。适合面积不敏感、吞吐要求高的场景。
二十七、数组接口:单份硬件分时复用
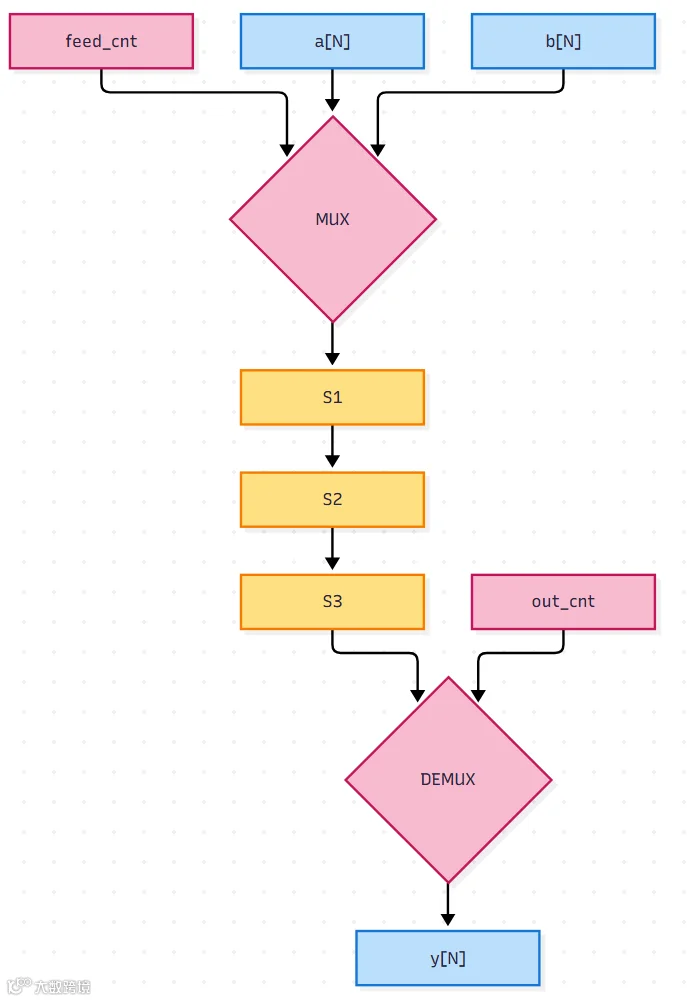
如果面积敏感,可以只用一份硬件,按顺序把数组元素喂进去:
   logic [CW-1:0] feed_cnt;
logic          feeding;

always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        feed_cnt <= '0;
        feeding  <= 1'b0;
    end else if (in_start && !feeding) begin
        feed_cnt <= '0;
        feeding  <= 1'b1;
    end else if (feeding) begin
        if (feed_cnt == N-1) begin
            feed_cnt <= '0;
            feeding  <= 1'b0;
        end else begin
            feed_cnt <= feed_cnt + 1'b1;
        end
    end
end

assign a_sel = a[feed_cnt];
assign b_sel = b[feed_cnt];
assign feed_valid = feeding;
输出侧按计数写回:
   logic [CW-1:0] out_cnt;
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) out_cnt <= '0;
    else if (s3_valid) out_cnt <= (out_cnt == N-1) ? '0 : out_cnt + 1'b1;
end

generate
    for (genvar k = 0; k < N; k++) begin : g_y
        always_ff @(posedge clk or negedge rst_n) begin
            if (!rst_n) y[k] <= 32'd0;
            else if (s3_valid && (out_cnt == k[CW-1:0]))
                y[k] <= y_packed;
        end
    end
endgenerate
N=4 时的分时复用时间表:
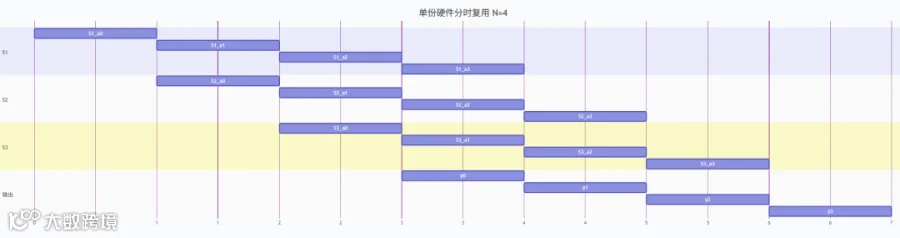
💡 每个周期 S1、S2、S3 都在工作,但处理的是不同元素。S1 的 unpack 模块被 4 个元素轮流使用,S2 的乘法器被 4 个元素轮流使用,S3 的 norm/round/pack 也被轮流使用。这就是分时复用。
二十八、两种策略对比
折中方案是 M 份硬件(M < N),吞吐 M/周期,面积 M 倍,适合既要一定吞吐又要控制面积的场景。
二十九、如何保证 i、i+1、i+2 不冲突
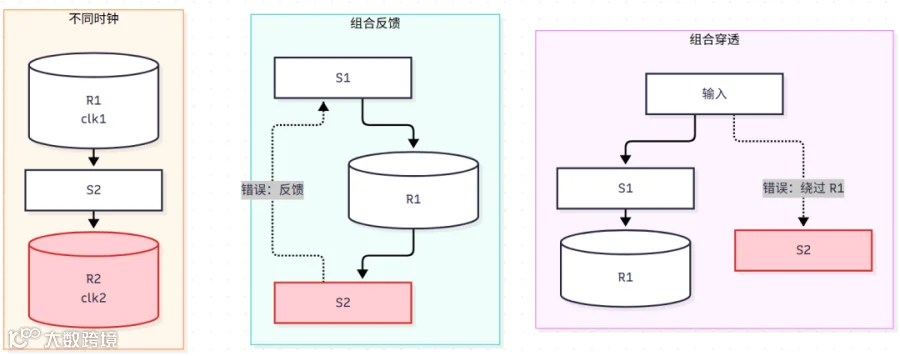
流水线能正常工作的前提是各级数据不打架。这靠的是几条结构性约束,不需要任何额外的逻辑:

五条规则:
违反规则的几种写法:
三十、完整顶层代码
   module fp32_mul_pipe (
    input  logic        clk, rst_n, in_valid,
    input  logic [31:0] a, b,
    output logic        out_valid,
    output logic [31:0] y
);
    // ========== Stage 1: 解包 ==========
    logic sa, sb;
    logic [7:0] ea, eb;
    logic [22:0] fa, fb;
    logic a_nan, b_nan, a_inf, b_inf, a_zero, b_zero;
    logic [7:0] ea_adj, eb_adj;
    logic [23:0] ma, mb;

    assign sa = a[31]; assign ea = a[30:23]; assign fa = a[22:0];
    assign sb = b[31]; assign eb = b[30:23]; assign fb = b[22:0];

    assign a_nan  = (ea == 8'hFF) && (fa != 0);
    assign b_nan  = (eb == 8'hFF) && (fb != 0);
    assign a_inf  = (ea == 8'hFF) && (fa == 0);
    assign b_inf  = (eb == 8'hFF) && (fb == 0);
    assign a_zero = (ea == 0) && (fa == 0);
    assign b_zero = (eb == 0) && (fb == 0);

    assign ea_adj = (ea == 0) ? 8'd1 : ea;
    assign eb_adj = (eb == 0) ? 8'd1 : eb;
    assign ma     = (ea == 0) ? {1'b0, fa} : {1'b1, fa};
    assign mb     = (eb == 0) ? {1'b0, fb} : {1'b1, fb};

    // S1 寄存器
    logic s1_valid, s1_sign;
    logic [23:0] s1_ma, s1_mb;
    logic [8:0]  s1_exp_sum;
    logic s1_a_nan, s1_b_nan, s1_a_inf, s1_b_inf, s1_a_zero, s1_b_zero;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            s1_valid <= 1'b0; s1_sign <= 1'b0;
            s1_ma <= 24'd0; s1_mb <= 24'd0; s1_exp_sum <= 9'd0;
            s1_a_nan <= 1'b0; s1_b_nan <= 1'b0;
            s1_a_inf <= 1'b0; s1_b_inf <= 1'b0;
            s1_a_zero <= 1'b0; s1_b_zero <= 1'b0;
        end else begin
            s1_valid   <= in_valid;
            s1_sign    <= sa ^ sb;
            s1_ma      <= ma;
            s1_mb      <= mb;
            s1_exp_sum <= {1'b0, ea_adj} + {1'b0, eb_adj};
            s1_a_nan <= a_nan; s1_b_nan <= b_nan;
            s1_a_inf <= a_inf; s1_b_inf <= b_inf;
            s1_a_zero <= a_zero; s1_b_zero <= b_zero;
        end
    end

    // ========== Stage 2: 乘法 ==========
    logic [47:0] prod;
    assign prod = s1_ma * s1_mb;

    logic s2_valid, s2_sign;
    logic [47:0] s2_prod;
    logic [8:0]  s2_exp_sum;
    logic s2_a_nan, s2_b_nan, s2_a_inf, s2_b_inf, s2_a_zero, s2_b_zero;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            s2_valid <= 1'b0; s2_sign <= 1'b0;
            s2_prod <= 48'd0; s2_exp_sum <= 9'd0;
            s2_a_nan <= 1'b0; s2_b_nan <= 1'b0;
            s2_a_inf <= 1'b0; s2_b_inf <= 1'b0;
            s2_a_zero <= 1'b0; s2_b_zero <= 1'b0;
        end else begin
            s2_valid   <= s1_valid;
            s2_sign    <= s1_sign;
            s2_prod    <= prod;
            s2_exp_sum <= s1_exp_sum;
            s2_a_nan <= s1_a_nan; s2_b_nan <= s1_b_nan;
            s2_a_inf <= s1_a_inf; s2_b_inf <= s1_b_inf;
            s2_a_zero <= s1_a_zero; s2_b_zero <= s1_b_zero;
        end
    end

    // ========== Stage 3: 规格化 + 舍入 ==========
    logic [5:0] msb_idx;
    always_comb begin
        msb_idx = 6'd0;
        for (int i = 0; i < 48; i++)
            if (s2_prod[i]) msb_idx = i[5:0];
    end

    logic [5:0]  shamt;
    logic [47:0] norm;
    assign shamt = 6'd47 - msb_idx;
    assign norm  = s2_prod << shamt;

    logic signed [11:0] exp_biased;
    assign exp_biased = $signed({3'b0, s2_exp_sum})
                      + $signed({6'b0, msb_idx}) - 12'sd173;

    logic [23:0] mant24;
    assign mant24 = norm[47:24];

    logic guard, sticky, lsb;
    assign guard  = norm[23];
    assign sticky = |norm[22:0];
    assign lsb    = mant24[0];

    logic [24:0] mant_rnd;
    always_comb begin
        if (guard && (sticky || lsb))
            mant_rnd = {1'b0, mant24} + 1'b1;
        else
            mant_rnd = {1'b0, mant24};
    end

    logic [23:0] mant_final;
    logic signed [11:0] exp_final;
    always_comb begin
        if (mant_rnd[24]) begin
            mant_final = mant_rnd[24:1];
            exp_final  = exp_biased + 12'sd1;
        end else begin
            mant_final = mant_rnd[23:0];
            exp_final  = exp_biased;
        end
    end

    logic is_zero_prod;
    assign is_zero_prod = (s2_prod == 48'd0);

    // S3 寄存器
    logic s3_valid, s3_sign;
    logic [23:0] s3_mant;
    logic [11:0] s3_exp;
    logic s3_zero_prod;
    logic s3_a_nan, s3_b_nan, s3_a_inf, s3_b_inf, s3_a_zero, s3_b_zero;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            s3_valid <= 1'b0; s3_sign <= 1'b0;
            s3_mant <= 24'd0; s3_exp <= 12'd0;
            s3_zero_prod <= 1'b0;
            s3_a_nan <= 1'b0; s3_b_nan <= 1'b0;
            s3_a_inf <= 1'b0; s3_b_inf <= 1'b0;
            s3_a_zero <= 1'b0; s3_b_zero <= 1'b0;
        end else begin
            s3_valid   <= s2_valid;
            s3_sign    <= s2_sign;
            s3_mant    <= mant_final;
            s3_exp     <= exp_final;
            s3_zero_prod <= is_zero_prod;
            s3_a_nan <= s2_a_nan; s3_b_nan <= s2_b_nan;
            s3_a_inf <= s2_a_inf; s3_b_inf <= s2_b_inf;
            s3_a_zero <= s2_a_zero; s3_b_zero <= s2_b_zero;
        end
    end

    // ========== Stage 3 后半: 打包 ==========
    logic [31:0] y_norm;
    always_comb begin
        if (s3_zero_prod)
            y_norm = {s3_sign, 31'd0};
        else if (s3_exp >= 12'sd255)
            y_norm = {s3_sign, 8'hFF, 23'd0};
        else if (s3_exp <= 12'sd0)
            y_norm = {s3_sign, 31'd0};
        else
            y_norm = {s3_sign, s3_exp[7:0], s3_mant[22:0]};
    end

    logic [31:0] y_result;
    always_comb begin
        if (s3_a_nan || s3_b_nan)
            y_result = {s3_sign, 8'hFF, 23'h400000};
        else if (s3_a_inf || s3_b_inf) begin
            if ((s3_a_inf && s3_b_zero) || (s3_b_inf && s3_a_zero))
                y_result = {s3_sign, 8'hFF, 23'h400000};
            else
                y_result = {s3_sign, 8'hFF, 23'd0};
        end
        else if (s3_a_zero || s3_b_zero)
            y_result = {s3_sign, 31'd0};
        else
            y_result = y_norm;
    end

    // 输出寄存器
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            out_valid <= 1'b0;
            y         <= 32'd0;
        end else begin
            out_valid <= s3_valid;
            y         <= y_result;
        end
    end
endmodule
三十一、总结
从一段解包代码开始,到三级流水线,再到数组接口,整个设计可以归纳成下面这张图:
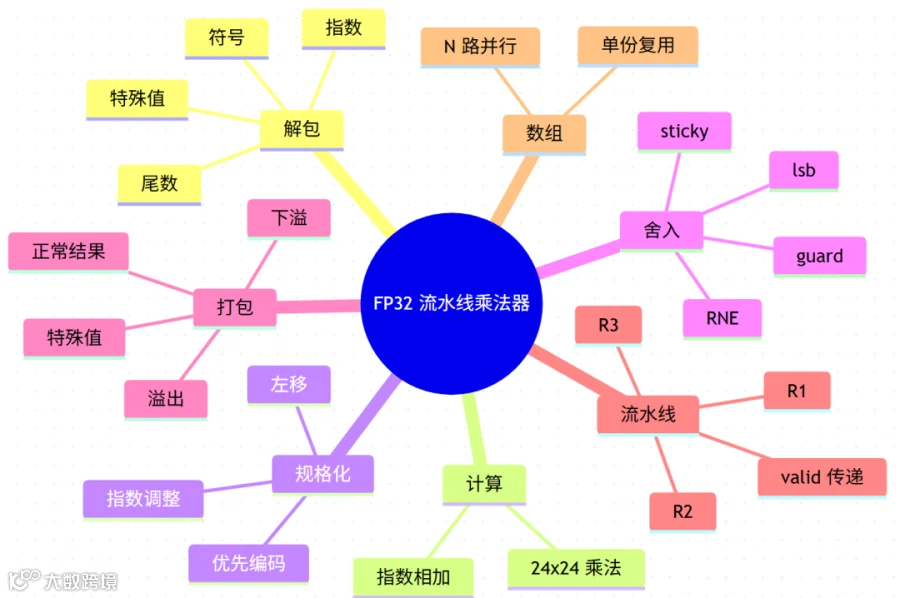
核心要点:
🎯 到这里,一个从零开始的 FP32 流水线乘法器就完整了。每一段代码都对应一个具体的计算步骤,每一个寄存器都切出一条清晰的流水线边界。理解了这个设计,再去看更复杂的 FMA、双精度乘法、SIMD 乘法单元,思路都是一样的。