

组合逻辑在硬件里是并排的电路,信号像水流一样从输入流到输出。但在仿真器里,它却是另一番景象:没有物理延迟,没有门电路,只有事件队列和零时间的 delta 循环。这篇文章从最简单的组合逻辑出发,逐步解释仿真器如何并行求值、如何迭代收敛,以及依赖图作为一种加速技巧在其中扮演什么角色。
📌 本文讨论的是 SystemVerilog 仿真语义,不涉及具体算法实现。所有例子均为抽象的组合逻辑片段。
一、组合逻辑:算法串行,硬件并行
先看一个最简单的例子:
   assign s = a + b;
assign y = s << 1;
从算法上看,这是两步串行:
-
• 先算 s = a + b -
• 再算 y = s << 1
第 2 步依赖第 1 步的结果。但在硬件里,这两个运算物理上并排存在,用导线连接:
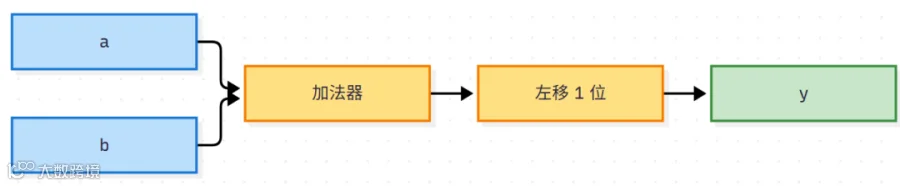
信号从 a,b 进去,经过加法器,再经过移位器,从 y 出来。要点如下:
-
• 没有时钟,不需要节拍; -
• 没有寄存器,不需要保存中间结果; -
• 一拍都不用,纯粹靠传播延迟。
这就是组合逻辑:算法上的串行步骤,在硬件上展开成空间并排的电路。
交换两句 assign 的顺序,结果完全一样:
   wire [7:0] s;
wire [8:0] y;

assign y = s << 1;
assign s = a + b;
原因在于:
-
• assign是并发语句; -
• 仿真器按依赖关系求值,而不是按语句顺序; -
• 只要依赖关系无环,顺序无关。
二、仿真器不综合,它解释过程
综合工具会把 if/else 展开成 MUX,把 for 循环展开成并行逻辑,最终生成门级网表。但仿真器不这么做。
仿真器的目标是模拟语言语义,包括:
只要设计里出现任何一项,纯静态展开就不够了。通用仿真器不能假设用户只写纯组合网络,所以必须用统一的调度机制兜底。
三、并行求值:delta 内同时进行
仿真器是单线程程序,不能真正并行求值。但它用 delta 循环模拟并行行为:
在同一个 delta 内,所有 RHS 读旧值,LHS 在 NBA 区统一更新。效果上等价于并行求值。
关键是同一个 delta 内的多个信号更新:
   assign x = a + b;
assign y = c + d;
assign z = e + f;
a 变化时,delta 1 里:
-
• x重新求值; -
• y不变(c, d没变); -
• z不变(e, f没变)。
如果 a 和 c 同时变化,delta 1 里 x 和 y同时重新求值,互不影响。这就是并行求值。
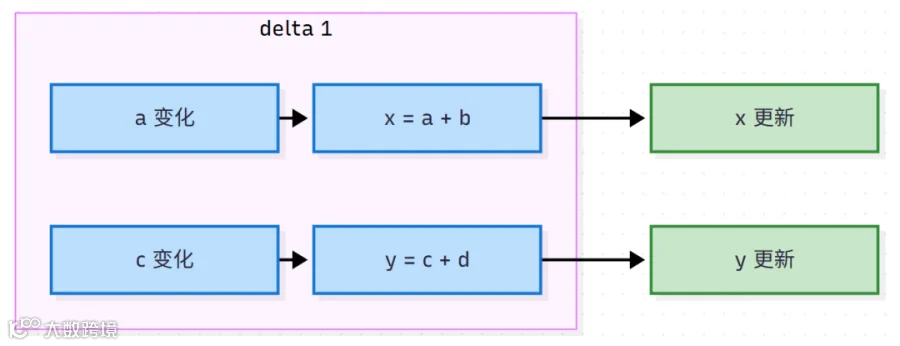
同一个 delta 内,多个信号独立求值,互不依赖。这就是“并行”的体现。
四、NBA 的两阶段语义
   always_ff @(posedge clk) begin
    a <= b;
    c <= d;
end
执行要点:
-
• a和c的 RHS 在 Active 区并行求值(读b, d的旧值); -
• a和c的 LHS 在 NBA 区同时更新。
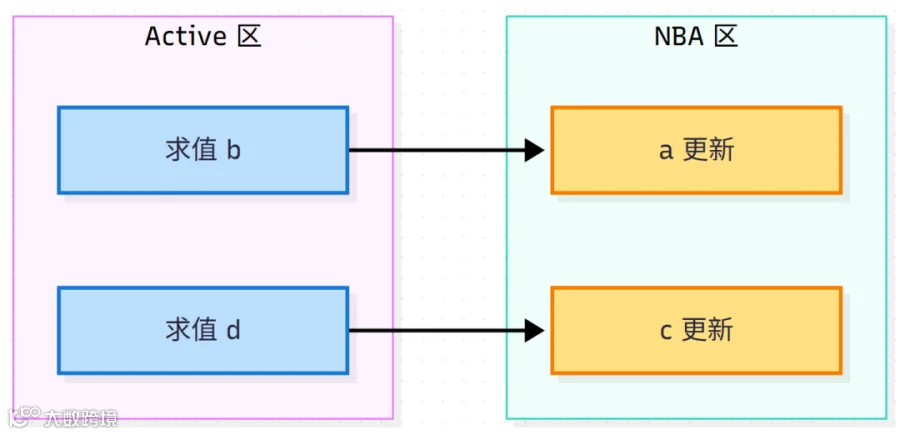
RHS 读旧值,LHS 在 NBA 区统一更新。 这就是为什么 NBA 能模拟“所有寄存器同时更新”。
五、收敛过程:迭代到稳定
并行求值只做一轮还不够,因为信号之间有依赖:
   assign s1 = a + b;
assign s2 = s1 + c;
assign s3 = s2 + d;
迭代过程:
-
• delta 1: s1更新; -
• delta 2: s2更新(依赖 s1 的新值); -
• delta 3: s3更新(依赖 s2 的新值); -
• delta 4:没有新事件,收敛。
从图上看,可以把“下一轮迭代读上一轮结果”画成一条回边,表示迭代到不动点:

这条回边不是电路里的环,而是迭代求解的回边:每一轮 delta 用上一轮的输出作为输入,直到所有信号不再变化。
每一轮 delta 内部并行求值,轮与轮之间通过回边迭代,直到稳定。 迭代次数取决于信号传播的逻辑深度:
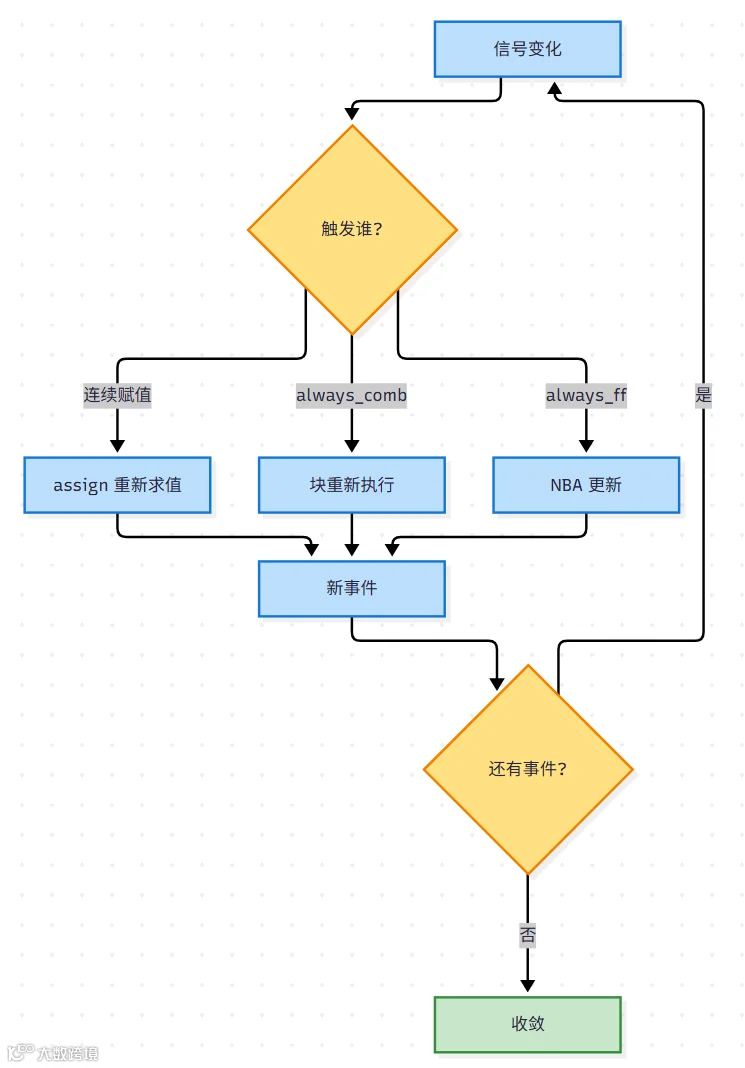
六、delta 循环的触发与退出
6.1 什么时候触发 delta 循环
只要一个信号在当前 delta 内被更新,而这个更新又触发了另一个进程或连续赋值重新求值,就会进入下一个 delta。
6.2 退出判据:队列为空
delta 循环的唯一退出判据是:
当前仿真时刻内,Active 队列和 NBA 队列都为空。

6.3 eval 的内部实现
仿真器的主循环伪代码:
   while (仿真时间未结束) {
    while (Active 队列非空 || NBA 队列非空) {
        // 一个 delta
        处理 Active 队列
        处理 Inactive 队列
        处理 NBA 队列
        处理 Observed 队列
    }
    推进仿真时间到下一个事件
}
内层 while 就是 delta 循环。 它一直执行,直到所有队列为空。
七、与真实电路收敛的相似性
delta 循环和真实电路的信号收敛,在逻辑语义上高度相似:

关键区别:
-
• 时间消耗:delta 循环是零时间,真实电路是纳秒级; -
• 仿真时间:delta 循环不前进,真实电路持续前进; -
• 毛刺:delta 循环通常不可见,真实电路可见; -
• 传播速度:delta 循环无限快,真实电路受门延迟限制。
🎯 delta 循环是真实电路传播的“零时间抽象”。它不模拟延迟,但模拟顺序;不模拟毛刺,但模拟稳定值。两者最终稳定值一致,但时间模型不同。
八、有环时不收敛
   assign a = b & c;
assign b = a | d;

执行过程:
事件队列永远非空,仿真器最后报:
Zero-delay loop detected
真实电路里,组合环也会振荡。 所以综合工具拒绝这种设计。
九、加速技巧:依赖图与拓扑排序
delta 循环是语义兜底,保证任何合法设计都能被正确仿真。但它的代价是:每个 delta 只推进一级逻辑,迭代次数等于逻辑深度。对于纯组合网络,这意味着仿真器做了大量“本可以一次性算完”的工作。
依赖图和拓扑排序就是针对这个代价的加速技巧。
9.1 加速的核心思路

9.2 纯组合网络:拓扑排序一次性求值
   assign s1 = a + b;
assign s2 = s1 + c;
assign s3 = s2 + d;
assign y  = s3 << 1;
构建依赖图:

拓扑排序:s1 → s2 → s3 → y。按这个顺序求值,一次算完,不需要 4 个 delta。
💡 *这就是依赖图加速的本质:用静态分析把“逐级迭代”变成“一次遍历”。*
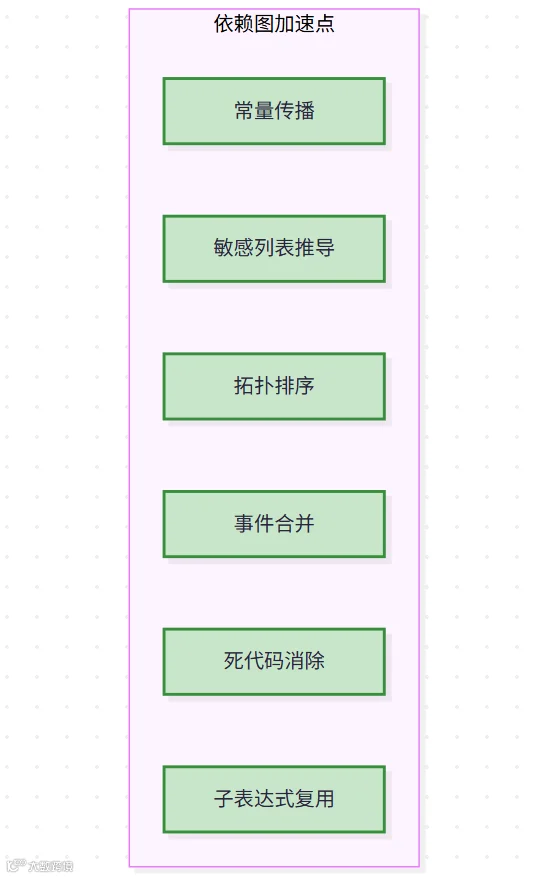
9.3 依赖图在仿真里的其他加速点
9.4 依赖图在综合/STA/形式验证中的核心地位
依赖图不仅是仿真加速技巧,在静态分析工具里它更是核心数据结构:

💡 在这些场合,依赖图不是“加速手段”,而是*唯一可行的方法。没有它,综合、STA、形式验证都做不了。*
9.5 加速的边界:为什么不能完全替代 delta 循环
依赖图加速有一个前提:依赖关系是静态可确定的。一旦涉及动态语义,这个前提就不成立:

以 if/else 为例:
   always_comb begin
    if (sel) y = a + b;
    else     y = c + d;
end
静态依赖可以保守画成 MUX:
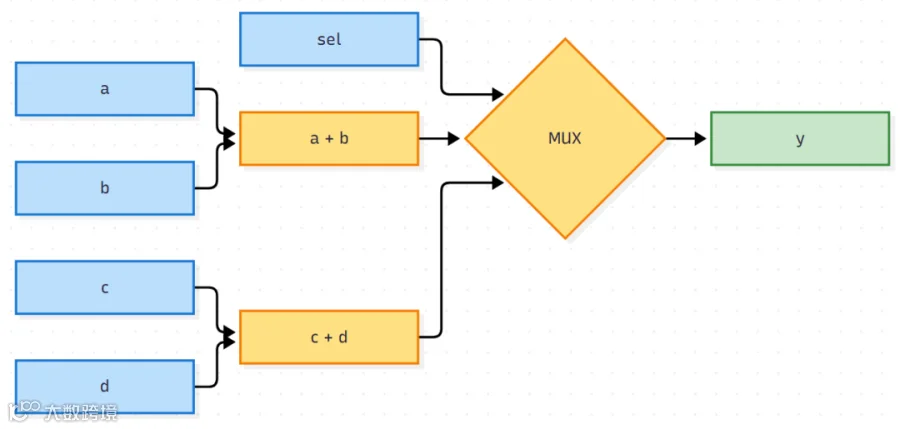
这在综合里是正确的:综合工具确实会生成 MUX。但在仿真里,这丢失了两个信息:
-
• 运行时只执行一条分支,另一条分支的副作用(如 $display)不应该发生; -
• 敏感列表是动态的: sel=1时y只敏感于a,b,sel,不敏感于c,d。
所以仿真器不能把过程代码展开成 MUX,只能逐句解释执行,靠 delta 循环传播。
9.6 实际仿真器的混合策略
真实仿真器不是“要么依赖图,要么 delta 循环”,而是分层混合:

🎯 依赖图是*加速技巧,delta 循环是语义兜底。两者不是替代关系,而是分工关系:能静态确定的部分用图加速,不能静态确定的部分用事件迭代。通用仿真器选择“静态分析加速 + delta 循环兜底”,是为了同时兼顾性能和语义正确性。*
十、深度判定:理论可行,实际不用
理论上,可以根据依赖图的最长路径确定最大收敛步数:
无环 DAG 的最长路径有限,delta 次数 ≤ 路径长度。超过则必然有环。
但实际仿真器不这么做,原因在于:
实际工程倾向于“简单 + 通用 + 足够快”。 组合环检测通常用全局迭代上限,超过就报错。

十一、总结
🎯 组合逻辑仿真本质上是一个信号收敛过程:输入变化后,仿真器沿依赖关系逐级迭代求值,直到所有信号不再变化。概念上就是并行求值,然后迭代到稳定。从图上看,这个过程可以表示为一组前馈节点加上一条回边——每一轮迭代把上一轮的输出作为输入,直到到达不动点。
在这个基础上,依赖图和拓扑排序是一种加速技巧:对纯组合、无过程语义的网络,用静态排序把“逐级迭代”变成“一次遍历”;对敏感列表推导、常量传播、死代码消除,也能显著减少运行时工作。依赖图在综合、STA、形式验证里更是核心数据结构。
但加速有边界:动态控制流、NBA 两阶段语义、副作用顺序、
force/release、PLI 调用,都无法用静态图完整表达。所以通用仿真器选择“静态分析加速 + delta 循环兜底”:能静态确定的部分用图加速,不能静态确定的部分用事件迭代。两者分工,共同保证仿真器的性能和语义正确性**。delta 循环不是优化,而是语义正确性的最后一道防线。**