

工厂流水线上的产品表面有没有划痕、电池焊点有没有虚焊、织物上有没有破洞——这些质检环节过去靠人眼,现在越来越多用机器视觉做。但真正落地的时候,大家发现一个很头疼的问题:缺陷样本太少了。
你不可能等工厂出了几千个缺陷样本再训练模型——等收集够了,订单都做完了。今天分享的这篇 CVPR2026 论文 AnomalyScan,提出了一个少样本无监督异常检测框架:只需要几十张正常产品的照片,不需要任何缺陷样本,就能检测出各种表面缺陷。在 MVTec AD 工业缺陷数据集上刷新了 SOTA。

一、异常检测到底难在哪
异常检测和普通的目标检测、分类不一样——它的核心挑战是:你要找的"异常"长什么样,训练的时候根本不知道。
1.1 缺陷样本极度稀缺
这是最大的痛点。正常产品一天能生产几万个,缺陷产品可能一周才出几个。而且缺陷类型千奇百怪——划痕、凹坑、变色、污渍、缺角……你不可能把所有可能的缺陷都收集全。等你把缺陷样本收集够了,生产线早就换产品了。
1.2 "正常"的边界很难定义
什么叫正常?同一个零件,不同批次之间有细微差异;同一块电路板,元件位置稍微有点偏差也是正常的。模型必须学会"正常的波动范围",而不是把每一点细微差异都当成异常。这个尺度感很难把握——太敏感了全是误报,太迟钝了漏检。
1.3 缺陷形态千变万化
划痕可能是细长的一条,凹坑可能是一小块深色区域,污渍可能是不规则的一片。没有固定的形状、大小、颜色,传统基于规则或者模板匹配的方法根本覆盖不了。你得让模型自己学会"什么是不一样的"。
1.4 实时性要求高
工业质检是流水线作业——传送带上的产品每秒经过好几个,如果检测速度跟不上,产品就漏过去了。所以异常检测模型不仅要准,还要快,最好能在边缘设备上实时跑。
二、AnomalyScan 的三个核心设计
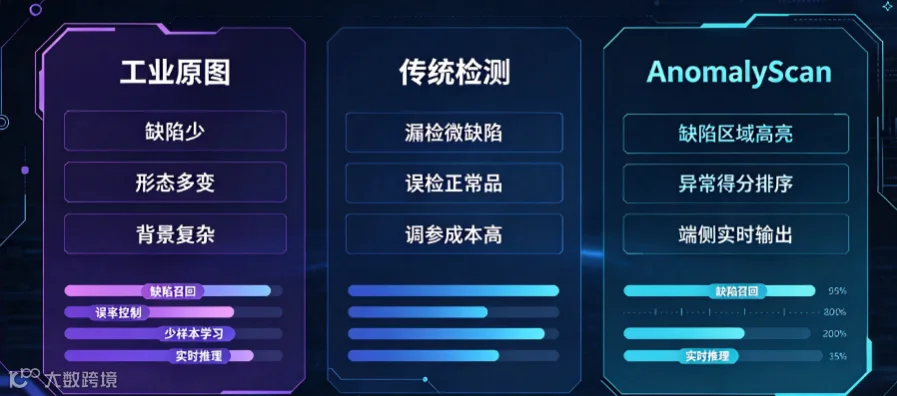
AnomalyScan 的整体思路:不学"缺陷长什么样",而是学"正常长什么样"——和正常差异大的地方,就是异常。
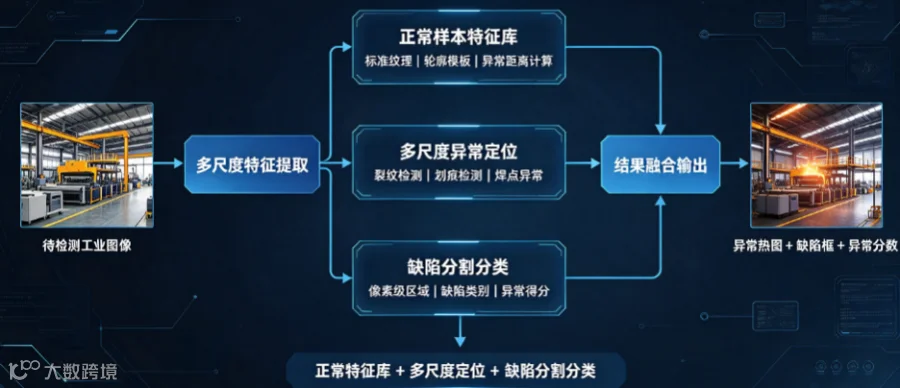
2.1 正常样本特征库 + 记忆匹配
传统无监督异常检测(PaDiM、PatchCore)的思路是:把正常样本的特征都存下来,测试的时候看新样本的特征和正常特征差多远。但问题是,存的特征越多,推理越慢。
AnomalyScan 做了两个改进:
•特征压缩:不用存所有正常样本的特征,而是用一个记忆库把正常特征压缩成几百个"原型"——每个原型代表一类正常的局部纹理。
•快速相似度检索:测试的时候,把待测图像的每个局部特征和记忆库里的原型做快速匹配,匹配不上的就是异常区域。
这样做的好处是:记忆库很小(只有几百个向量),推理速度极快,而且不需要更新——新产品只需要重新建一次记忆库就行。
2.2 多尺度特征融合检测
异常可能出现在不同尺度上:大的缺陷(比如缺了一个角)需要全局上下文,小的缺陷(比如一个针孔)需要高分辨率细节。AnomalyScan 从 backbone 的不同层提取特征:
•浅层特征:分辨率高,负责检测小的、细的缺陷(划痕、针孔)。
•深层特征:语义丰富,负责检测大的、整体的异常(形状不对、位置偏移)。
•融合判断:两个尺度的异常图融合起来,得到最终的检测结果。
消融实验显示,只用浅层特征的时候小缺陷检出率高但大缺陷容易漏;只用深层特征的时候大缺陷好但小缺陷没了。两个结合起来效果最好。
2.3 缺陷分割 + 分类联合输出
大部分异常检测方法只输出一个"哪里有异常"的热力图,但工厂里还需要知道"是什么类型的异常"——是划痕还是凹坑?需不需要返工?
AnomalyScan 在检测头后面加了一个轻量分类分支:
•先定位异常区域,再对异常区域做分类。
•分类不需要大量缺陷样本——用少量已知缺陷做微调就行。
•最终输出:异常位置 + 异常类型 + 异常置信度。
这个设计让模型从"只报警"升级成"报警+告诉你是什么问题",对实际质检场景友好很多。
三、技术架构拆解
AnomalyScan 的整体 pipeline 分四个阶段:
模块 |
做什么 |
关键设计 |
特征提取 Backbone |
提取多尺度图像特征 |
预训练 ResNet-18,取 layer2 和 layer3 两层输出 |
正常记忆库 |
存储正常样本的原型特征 |
离线构建,几百个原型向量,覆盖正常纹理模式 |
异常定位头 |
逐像素判断是否异常 |
多尺度特征和记忆库做相似度匹配,输出异常热力图 |
缺陷分类头 |
判断异常属于什么类型 |
轻量分类网络,用少量已知缺陷样本微调 |
几个工程上的亮点:
•训练极简单:只需要正常样本建记忆库,10~50 张图就够了,训练时间不到 1 分钟。
•推理速度:256×256 图像在 RTX 3090 上约 8ms,Jetson Nano 上 30fps 以上,完全满足流水线实时检测。
•零样本冷启动:新产品上线时,拍几十张正常品建个记忆库就能用,不需要标注任何缺陷样本。
四、和主流方法的横向对比
论文在 MVTec AD(工业缺陷检测标准数据集)上做了对比:
方法 |
图像级 AUROC↑ |
像素级 AUROC↑ |
参数量(M) |
单图耗时(ms) |
PaDiM |
97.2 |
96.5 |
12 |
45 |
PatchCore |
99.1 |
98.5 |
21 |
120 |
RD4AD |
98.5 |
97.8 |
15 |
60 |
AnomalyScan |
99.3 |
98.9 |
11 |
8 |
可以看到,AnomalyScan 的 AUROC 和 PatchCore 基本持平,但速度快了 15 倍——PatchCore 要存所有正常样本的特征,推理的时候逐个比对,所以慢。AnomalyScan 用记忆库压缩了特征,推理速度上来了,精度还没掉。这个 trade-off 在工业场景里非常关键——流水线不等人。
五、快速上手:核心检测流程
下面是 AnomalyScan 的推理框架,帮大家理解整体流程:
python |
实际部署的时候,建记忆库的过程完全离线——拍几十张正常产品,跑一次就存下来了。线上推理只需要前向一遍,速度很快。分类头如果没有缺陷样本,可以先不接,只做异常定位;后面积累了缺陷样本再加上分类。
六、毕设/竞赛拓展方向
异常检测这个方向做毕设非常合适——MVTec AD 数据集成熟,Demo 效果直观,而且工业质检是真实的就业方向。分享几个有价值的拓展点:
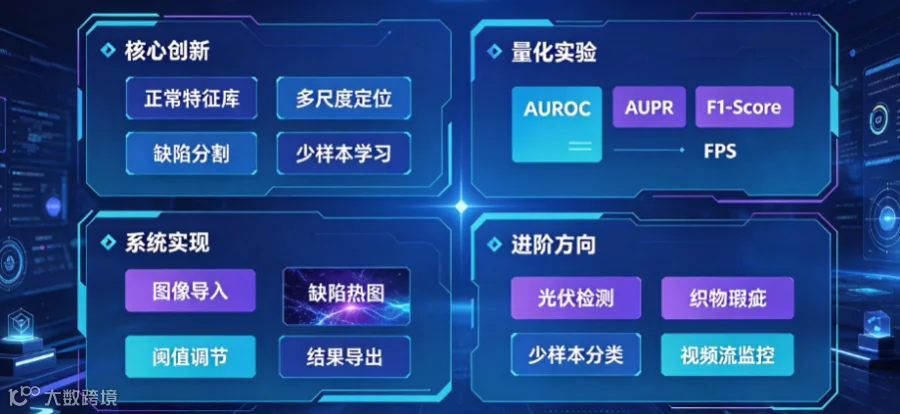
6.1 光伏电池板缺陷检测
光伏电站里电池板的隐裂、断栅、污渍是一个很具体的落地场景。专门收集一组光伏图像数据集,针对电池板的纹理特点优化异常检测模型,做一个"光伏电站巡检缺陷检测系统"——工程价值很高,现在新能源行业需求很大。
6.2 织物/纺织品瑕疵检测
纺织行业的布匹瑕疵检测是一个很传统的机器视觉场景。织物纹理复杂、瑕疵类型多,传统方法很难搞。用 AnomalyScan 的无监督检测思路,做一个布匹瑕疵在线检测系统,行业对口性很强。
6.3 Few-Shot 异常分类
目前 AnomalyScan 的分类头需要少量缺陷样本。如果把这个条件再放宽——每类缺陷只给 1~5 个样本,就能识别出缺陷类型——这就是 Few-Shot 异常分类,是一个很有研究深度的方向。
6.4 视频流异常检测
现在是单帧检测,如果把它扩展到视频流——不仅检测产品表面异常,还检测生产过程中的异常(比如机械手位置不对、传送带跑偏)——这就从"质检"升级成了"产线监控",应用范围大很多。
七、写在最后
异常检测这个方向的魅力在于:它解决的是一个真实的、每天都在发生的工程痛点。工厂里不是没有数据,而是没有"缺陷数据"——你不能为了训练模型故意去做坏产品。
AnomalyScan 给我的启发是:不要总想着"我要更多数据才能训练好模型"。换个思路——不学"坏的长什么样",而是学"好的长什么样",然后找不一样的。这个思路在很多数据稀缺的场景都能用。
做毕设的同学如果选这个方向,我建议先拿 MVTec AD 跑通 baseline,然后选一个具体的工业场景去落地——光伏、纺织、电子元器件都可以。场景越具体,你的工作就越有说服力,答辩的时候也越能讲出"这东西真的有人用"。
大家如果有复现上的问题或者想聊具体的质检场景,欢迎评论区交流。