

【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址🔗:https://ai-mzq.github.io/From-Zero-to-AGI/[1]
往期推荐:
-
一文讲透 AI 算力平台 8 个核心概念:GPU、显存、NVLink、InfiniBand、调度、存储、容器、监控 -
一文详解大模型 12 个核心机制:Token、Embedding、Attention、Transformer、MoE、预训练、后训练、对齐、RAG、工具调用、推理、评测 -
一文讲透大模型推理服务 8 个核心指标:TTFT、TPOT、ITL、端到端延迟、吞吐、并发、请求率与 Goodput
欢迎关注【魔方AI空间】👇
本文聚焦于 GPU 集群中的 PCIe、NVLink、RoCE 与 InfiniBand。我们沿着一块数据从本地 GPU 显存到远端 GPU 显存的路径,看看四种互联各自负责哪一段,以及训练为什么仍会被通信拖慢。
一台装有 8 张 GPU 的服务器训练正常。扩展到两台服务器、16 张 GPU 后,单步计算时间缩短了,训练速度却远没有翻倍。
从日志看,部分 Rank(分布式训练中的独立进程,通常一个进程对应一张 GPU)已经完成反向计算,却还在等待 AllReduce;网卡标称 400 Gb/s,NCCL 实测带宽却低得多。偶尔一条链路出现波动,其他 GPU 也只能跟着等。
问题未必出在网卡本身。一次跨节点通信从 GPU 显存出发,要经过 GPU 互联或 PCIe、NIC/HCA 和交换网络,最后再沿远端服务器的设备路径进入目标 GPU。中间任何一段绕路、拥塞或降速,都会反映到训练时间里。
PCIe、NVLink、RoCE、InfiniBand 经常被放在一起比较,但是它们实际负责的是通信路径上的不同环节。PCIe 连接节点内的通用设备,NVLink/NVSwitch 扩大 GPU 的高速 Scale-up 域,RoCE 和 InfiniBand 负责跨节点 RDMA 通信。判断训练速度,得看完整路径、集合通信算法和最慢 Rank;只看某个端口的峰值,很难解释任务为什么慢。
如图 1 所示,GPU 数量翻倍后,计算时间虽然缩短,跨节点 AllReduce 和等待时间也进入了关键路径。

图1:GPU 数量翻倍后,计算段缩短,但跨节点 AllReduce 与慢 Rank 等待仍会限制整体 step time。
GPU 为什么要频繁通信
只用一张 GPU 训练时,前向和反向计算都在这张卡完成。训练扩展到多张 GPU 后,各张卡之间还要频繁交换梯度、参数分片和中间结果。于是,通信几乎出现在每一个训练 step 中。
以数据并行(DP)为例。每张 GPU 持有一份模型副本,读取不同的数据,各自完成前向和反向计算。等这一轮反向传播结束,各张卡还要汇总梯度,保证下一次参数更新保持一致。
这一步通常由 AllReduce 完成:先归约所有 Rank 的梯度,再把结果发回每一个 Rank。ZeRO、FSDP 和 MoE 采用了不同的切分方式,对应的通信操作也会变化:
· ReduceScatter 一边归约,一边把不同分片交给各个 Rank;
· AllGather 在计算需要时,把分散的参数或结果重新收集起来;
· All-to-All 让多个 Rank 彼此发送数据,常见于 MoE 的 token 路由;
· Point-to-Point 在流水线并行的相邻 Stage 之间传递激活和梯度。
NCCL[2] 提供这些集合通信与点对点操作。数据并行、张量并行和 MoE 产生的流量各有特点:数据并行更看重持续带宽,张量并行更在意低时延和局部拓扑,MoE 的 All-to-All 则会考验二分带宽、拥塞控制和尾延迟。
在同步训练里,一个 step 什么时候结束,往往由最慢的 Rank 决定。 某条链路降速、GPU 与 NIC 跨 NUMA,或者一个节点偶尔变慢,其他 Rank 都可能在同步点等它。
NUMA(非一致性内存访问)会让不同 CPU、内存、GPU 和网卡之间的访问距离不同。GPU 若使用另一颗 CPU 下的网卡,数据路径可能更长,通信性能也会下降。
如图 2 所示,AllReduce、AllGather、ReduceScatter 和 All-to-All 的数据流向不同,对网络的压力也不一样。
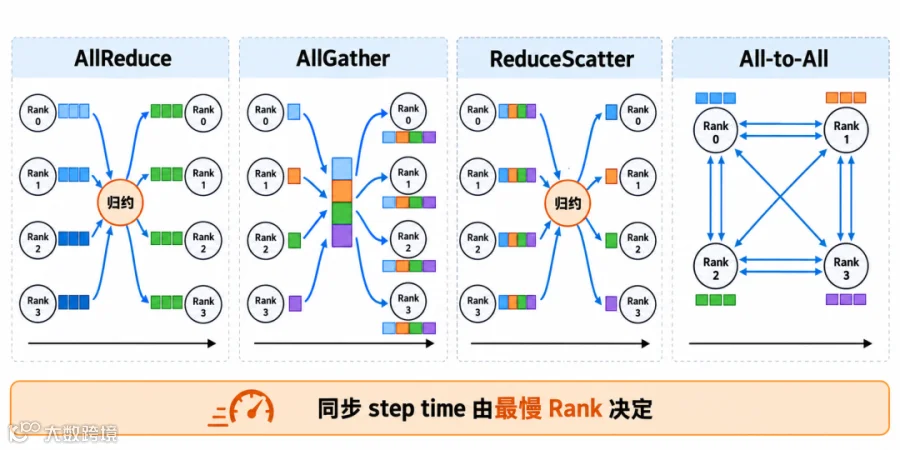
图2:四种集合通信的数据流向不同,其中 All-to-All 会形成更密集的多对多流量;同步训练的 step time 受最慢 Rank 约束。
这些通信最终都要落到具体的硬件路径上。
同一节点内,两张 GPU 之间可能走 NVLink/NVSwitch,也可能走 PCIe P2P:
源 GPU HBM
    ↓
PCIe 或平台直接路径
    ↓
本地 NIC/HCA
    ↓
RoCE Ethernet Fabric 或 InfiniBand Fabric
    ↓
远端 NIC/HCA
    ↓
远端设备互联路径
    ↓
目标 GPU HBM
如图 3 所示,四种技术往往会同时出现在一条通信路径中。
RoCE 或 InfiniBand 负责跨节点传输时,数据仍要先经过 GPU 到网卡之间的设备路径;NVLink 加快了 Scale-up 域内的 GPU 通信,流量跨出这个域后仍要依靠节点间网络。
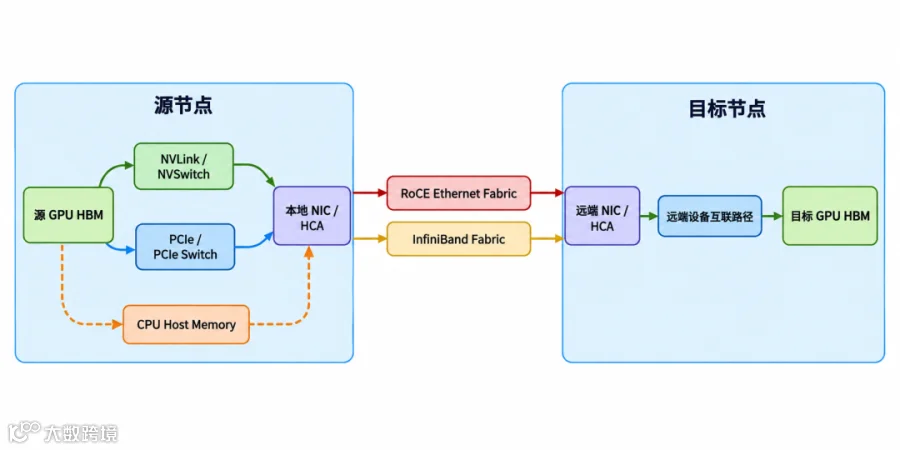
图3:GPU 显存之间的数据传输会经过节点内互联、NIC/HCA 与跨节点网络,Host Memory 可能成为额外的中转路径。
PCIe:设备都连上了,不代表路径都一样快
通俗理解:PCIe 把 CPU、GPU、NIC 和 NVMe 接入同一套 I/O 体系;即使跨节点使用 RoCE 或 InfiniBand,GPU 到网卡的这一段仍可能卡在 PCIe 拓扑上。
PCIe 是服务器里的通用设备互联。GPU、网卡、NVMe 盘和其他加速器,通常都通过 PCIe 接入 CPU 或 PCIe Switch。它不像 NVLink 那样专门围绕 GPU 高速通信设计,但覆盖面更广,也构成了大量 GPU 数据路径的基础。
一条 PCIe Link 由若干 Lane 组成,常见配置包括 x4、x8、x16。代际提高后,每条 Lane 的传输速率提升;Lane 数增加后,链路总能力也提高。
但 GT/s 表示每秒传输次数,不等于应用可直接获得的 GB/s。编码、协议头、流控和事务开销都会占用链路能力。PCIe 6.0 引入 64 GT/s、PAM4、FLIT、FEC 等机制,计算有效带宽时也要使用对应代际的编码方式。PCI-SIG 的 PCIe 6.0 说明[3]给出了这些变化。
数据具体怎么走,还要看拓扑。
在双路 CPU 服务器里,GPU 0 和 NIC 0 可能挂在 CPU 0 下,GPU 7 与 NIC 1 则挂在 CPU 1 下。GPU 0 把数据发给 NIC 0,路径相对直接;如果它被分配去使用 NIC 1,数据可能跨越 CPU Socket 或更远的 Root Complex。
多块设备也可能共享同一个 PCIe Switch 上行。每个下行口看起来都有 x16,汇聚后却可能出现超卖。单设备压测正常,多张 GPU 同时访问 NIC 或存储时才发生争用,常见原因就在这里。
超卖是指多个设备的下行带宽总和超过共享上行带宽。单设备测试可能正常,多设备同时传输时则会争抢带宽。
如图 4 所示,双路 CPU、PCIe Switch、GPU 和 NIC 的挂载位置共同决定了短路径、绕行路径和共享上行。

图4:同侧 GPU-NIC 路径通常更短;跨 Socket 绕行和共享 PCIe 上行可能引入额外延迟与带宽竞争。
NVIDIA DCGM 的拓扑说明[4]会区分 GPU 之间经过 NVLink、单个 PCIe Switch、多个 PCIe Switch、Host Bridge 还是 NUMA 互联。nvidia-smi topo -m 也能帮助确认 GPU、CPU 与 NIC 的相对位置。不过,拓扑标签只说明可能的路径,最终仍要通过 P2P、RDMA 和集合通信测试确认。
GPUDirect RDMA 也没有绕过 PCIe。 它允许第三方 PCIe 设备直接访问 GPU 显存,减少额外的 CPU Host Memory 中转和 CPU 参与,却不会让 GPU 与 NIC 之间凭空出现一条不受拓扑限制的新通道。
CUDA GPUDirect RDMA 文档[5]专门讨论了 PCIe Peer Device、共享 Root Complex 等条件。GPU 与 NIC 不在合适的拓扑下,或者受到 ACS、IOMMU、BAR 映射和驱动配置影响,直接路径可能不可用,性能也可能低于预期。
服务器支持新一代 PCIe,只能说明平台具备相应的接口能力。设备实际运行在哪一代、链路宽度是多少、汇聚路径是否超卖,还要结合拓扑和实测判断。
NVLink 与 NVSwitch:把 GPU 放进更大的高速互联域
通俗理解:NVLink 为 GPU 提供高带宽、低时延互联,NVSwitch 再把多条 NVLink 组织成更大、更均衡的交换式 GPU Fabric。
PCIe 要连接各种设备,需要兼顾通用性。张量并行和高频 GPU 集合通信更在意 GPU 之间的带宽、时延和显存访问路径,NVLink 主要解决这类通信需求。
NVLink 属于 GPU 高速互联,不按普通 Ethernet 网络工作。它主要连接 GPU-GPU,也用于部分平台中的 CPU-GPU 高速通信。训练框架通过 NCCL 等软件使用这些链路,应用通常不需要按 IP 网络的方式操作它。
少量 GPU 可以通过点对点 NVLink 直连。GPU 数量增加后,如果仍靠每张卡逐一连接,链路数量、布线和拓扑都会迅速复杂化,不同 GPU 对之间的路径也可能不一致。
NVSwitch 的作用,是把多条 NVLink 组织成交换结构。 多张 GPU 接入 NVSwitch 后,可以形成更大的高带宽 GPU 域,并让更多 GPU 对拥有相对一致的通信路径。NVIDIA 对 NVSwitch 的说明[6]也强调了它连接多个 GPU、形成高带宽 Fabric 的作用。
Tensor Parallel 尤其依赖这种紧密互联。一个 Transformer 层被切到多张 GPU 后,每层计算都可能触发 AllReduce 或 AllGather。跨出 NVLink 域进入较慢路径,单次差距会在大量网络层和训练 step 中不断累积。
NVLink 与 PCIe 通常同时存在。NVLink 负责 GPU 高速互联,CPU 访问设备、GPU 连接 NIC、NVMe 和控制面数据仍可能依赖 PCIe。判断一次通信会走多快,要看通信端点之间有没有 NVLink、NCCL 是否使用了这条路径,以及数据跨出 NVLink 域后还要经过哪些设备。
在过去大量 4 卡、8 卡服务器中,NVLink 主要承担节点内互联。到了新一代系统,它的范围已经扩展到机架级和特定的多节点域。
Hopper 架构[7]中的第四代 NVLink,给出的口径是每 GPU 900 GB/s 双向聚合带宽。NVL72 组件说明[8]则把第五代 NVLink、NVSwitch Tray 与 72 张 GPU 组织成机架级 NVLink Domain,每 GPU 最高双向聚合带宽达到 1800 GB/s。
这些数字描述的是特定代际、特定系统、每 GPU 的双向聚合能力,不能直接与单个 PCIe Lane、单向网卡端口或应用实测带宽排在一起。
NVLink Network 与 IMEX[9]还把 GPU P2P 内存访问扩展到多个 OS Domain。NVLink 的定位是 GPU Scale-up Fabric;更大范围的 Scale-out 通信,仍常由 RoCE 或 InfiniBand 承担。
如图 5 所示,GPU 互联可以从 PCIe-only、点对点 NVLink,扩展到通过 NVSwitch 组织的大型 NVLink Domain。
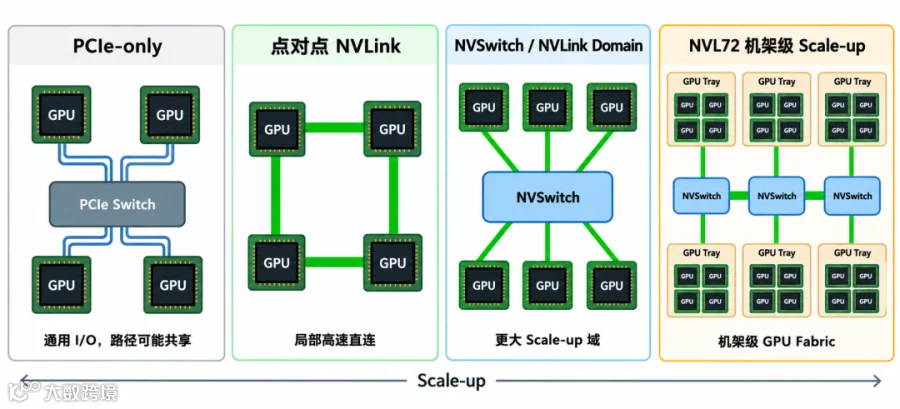
图5:GPU 互联从 PCIe-only、点对点 NVLink,逐步扩展到 NVSwitch 组织的大型 NVLink Domain 和机架级 Scale-up。
RoCE:在 Ethernet 上承载 RDMA
通俗理解:RoCE 在 Ethernet 上承载 RDMA,让支持 RoCE 的 NIC 直接搬运已注册内存,减少 CPU 参与和传统网络软件栈开销。
RDMA(Remote Direct Memory Access,远程直接内存访问)允许一台机器的网络设备直接读写另一台机器已经注册的内存区域,减少 CPU 介入、内核协议栈处理和额外拷贝。RoCE 的全称是 RDMA over Converged Ethernet,它把 RDMA 语义带到了 Ethernet 网络上。
RoCE 运行在 Ethernet 之上,使用支持 RoCE 的 NIC、Ethernet 交换机和链路,也能复用一部分既有的 IP/Ethernet 布线、路由和自动化能力。要稳定承载大规模 GPU 通信,网络还需要针对队列、拥塞和流量突发进行配置。
RoCEv1 工作在二层,使用专用 EtherType,通常受二层网络范围限制。RoCEv2 把 RDMA 数据包封装进 UDP/IP,可以经过三层路由,常用 UDP 端口 4791。MLNX_OFED 的 RoCE 模式说明[10]给出了两者的协议层差异。
在大规模数据中心里,RoCEv2 更适合配合 IP 路由、ECMP 和 Leaf-Spine 拓扑扩展。可路由解决的是数据包如何跨越更多网络设备,拥塞、乱序、队列积压和负载不均仍要单独处理。
GPU 集合通信会给网络带来不同于普通业务流量的压力:AllReduce 可能形成持续大流,All-to-All 让大量端点彼此发送,多个发送端同时指向一个接收端时还会出现 incast。交换机队列一旦积压,时延和尾部抖动会迅速放大。
高性能 RoCE 通常要端到端处理队列与优先级、ECN、端点拥塞控制、Buffer、Hash、ECMP、流量隔离和 Telemetry。某一个环节配置不一致,都可能在大规模通信中暴露出来。
PFC 可以在指定优先级的队列出现压力时暂停上游发送,减少丢包,但配置不当会造成暂停扩散和 Head-of-Line Blocking。RoCE 也存在结合 ECN、端点拥塞控制和重传能力的 lossy 设计,PFC 并非唯一方案。NVIDIA Cumulus 的 RoCE 文档[11]分别讨论了 lossless 与 lossy 模式。
如图 6 所示,RoCEv1 与 RoCEv2 的封装方式不同,RoCEv2 的拥塞反馈还会经过交换机、接收端和发送端。
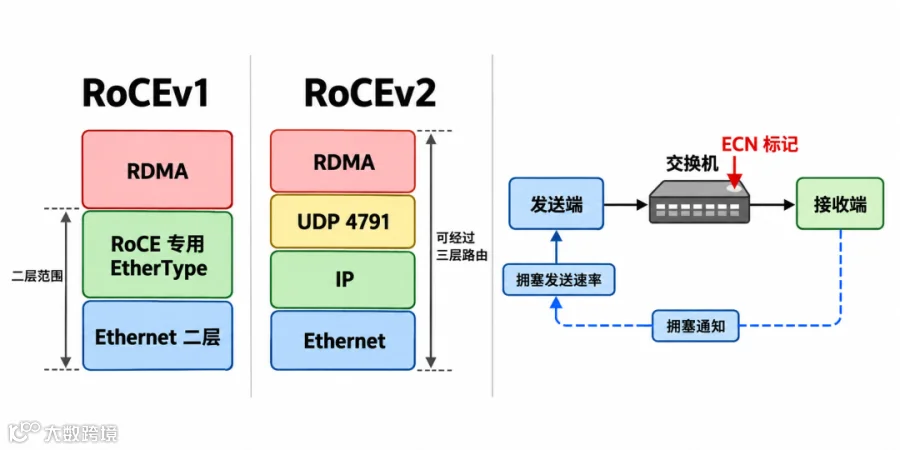
图6:RoCEv1 主要运行在二层范围内,RoCEv2 增加 IP/UDP 封装,并通过 ECN 标记和端点反馈完成拥塞控制。
RoCE 的优势在于可以融入成熟的 Ethernet 生态,前提是端点、交换机、QoS 和拥塞策略保持一致。链路显示 Up、端口没有明显丢包,只能说明基础连接正常,ECMP 是否均衡、All-to-All 有没有队列热点,还要看更细的网络计数和集合通信表现。
InfiniBand:围绕 RDMA 构建的一套完整 Fabric
通俗理解:InfiniBand 是独立的交换式互联架构,从 HCA、链路、交换机到 Fabric 管理,都围绕低时延、高吞吐和 RDMA 通信设计。
InfiniBand 与 RoCE 都能提供 RDMA,两者的协议体系、网络管理和运维方式并不相同。
InfiniBand 使用 HCA(Host Channel Adapter)连接主机,通过 InfiniBand Switch 组成点对点交换 Fabric。它从链路、传输、队列、可靠消息到管理面形成相对完整的体系。InfiniBand Trade Association 的介绍[12]将其描述为交换式 Fabric,并涵盖远程 DMA、消息传递和多种服务类型。
HCA 是主机进入 Fabric 的接口,承担网络数据搬运和队列处理。应用或通信库通常通过 Verbs 一类接口创建 Queue Pair、注册内存,并发起 Send、Receive、RDMA Read 或 RDMA Write。NVIDIA RDMA 编程手册[13]也展示了 InfiniBand 与 RoCE 在上层共享的 RDMA 编程抽象。
Subnet Manager 负责发现 Fabric、分配标识并计算或下发路径等管理工作。它采用的管理方式与 Ethernet/IP 环境不同,团队也需要掌握相应的 InfiniBand 运维和诊断工具。
如图 7 所示,HCA、InfiniBand 交换机和 Subnet Manager 共同组成了主机接入、数据转发和 Fabric 管理路径。

图7:InfiniBand Fabric 将 Verbs/RDMA 数据路径、Leaf-Spine 物理链路和 Subnet Manager 管理面组织在同一网络体系中。
具体产品还可能提供 Adaptive Routing、Telemetry 或网络内计算。评估方案时要分清:哪些属于 InfiniBand 标准,哪些是特定厂商或代际的能力,哪些功能已经在当前集群启用。产品手册列出的功能,只有在实际部署并启用后,才算当前集群具备的能力。
InfiniBand 的优势来自面向 HPC/AI 的软硬件设计、成熟的 RDMA 生态和相对完整的 Fabric 管理。这些能力可以提高通信效率和可管理性,却无法消除拥塞。
拓扑超卖、路由热点、链路降速、线缆误码、HCA 与 GPU 亲和性不合理,都会拖慢集合通信。端口标称 400 或 800 Gb/s,也不代表单个 GPU、任意 GPU 对或整项 AllReduce 都能持续获得等价的应用带宽。
即便采用 InfiniBand,团队仍要关注 Fabric 状态、端口计数、路由、拥塞、慢节点和 GPU-NIC 拓扑,只是管理模型和诊断工具与 RoCE 不同。
RoCE 与 InfiniBand:从协议到运维的差异
端口速率只能说明单条链路的理论能力。RoCE 与 InfiniBand 的差异还包括协议体系、路由与管理、拥塞处理、网络融合方式,以及团队需要承担的运维成本。
|
|
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
RoCE 可以复用 Ethernet 设备生态和 IP 网络经验,也更容易与现有网络体系结合。现有团队仍需要补上拥塞控制、队列和端到端调优能力,这些工作不会因为底层使用 Ethernet 而自动完成。
InfiniBand 围绕 RDMA 建立了较完整的 Fabric、HPC/AI 软件生态和统一管理方式。采用这套体系,也要承担独立网络、专用技能、备件和供应链成本。
计算总拥有成本时,还要把 GPU 空转算进去。一套采购价较低、却经常因拥塞和配置漂移让训练降速的网络,未必便宜;一套性能很强、但团队无法独立定位故障的专用网络,同样会拉长恢复时间。
实际选型离不开五个问题:
1. 主要工作负载是 dense 训练还是 MoE,主导通信是 AllReduce 还是 All-to-All?
2. 哪些 Rank 必须放在同一 NVLink Domain,哪些流量会进入 Scale-out?
3. 训练、存储和普通业务是否共网,隔离和故障半径怎样控制?
4. 团队更熟悉 Ethernet/RoCE 调优,还是 InfiniBand Fabric 运维?
5. 在同一组 GPU、消息规模、Rank 映射和软件版本下,P2P、RDMA、Collective 与真实 step time 分别怎样?
大型系统通常会组合使用这几种互联:一个 NVLink Domain 内由 NVLink/NVSwitch 承担 Scale-up,跨域通信再通过 RoCE 或 InfiniBand 完成 Scale-out。NVL72 网络架构[14]同时包含这两类 Fabric。
GPUDirect RDMA 与 NCCL,怎样把路径串起来
硬件链路准备好后,训练框架还需要 NCCL 把这些路径组织成具体的集合通信。
没有合适的直接数据路径时,跨节点通信可能先把 GPU 数据复制到 CPU Host Memory,再交给 NIC;远端再做一次反方向的搬运:
在硬件、拓扑、驱动和内存注册条件满足时,GPUDirect RDMA 允许 NIC/HCA 直接访问 GPU 显存:
这减少了 Host Memory bounce buffer,通常也能降低 CPU 负担、额外拷贝和时延。但数据仍要经过 GPU 到 NIC 的设备互联、跨节点网络和远端对称路径。nvidia-peermem 或其他 peer-memory 机制、IOMMU/ACS 设置和设备 BAR 映射,都可能影响结果。
训练框架调用 AllReduce 后,具体的数据分块和传输路径会交给 NCCL。NCCL 识别 GPU、NVLink/NVSwitch、PCIe、共享内存和网络 Transport,再结合拓扑与消息规模组织通信算法。
以 Ring AllReduce 为例,数据被切成多个块,沿环形路径执行 ReduceScatter,再继续 AllGather。它能让各 Rank 持续收发,较充分地使用链路带宽,但需要多个通信步骤。Tree 可以减少步骤,在小消息或较大规模下可能更有优势。实际选择还会受到 NCCL 版本、通道数、网络插件和物理拓扑影响。
如图 8 所示,GPUDirect RDMA 解决的是内存中转路径,NCCL 则在这些硬件路径上组织集合通信。
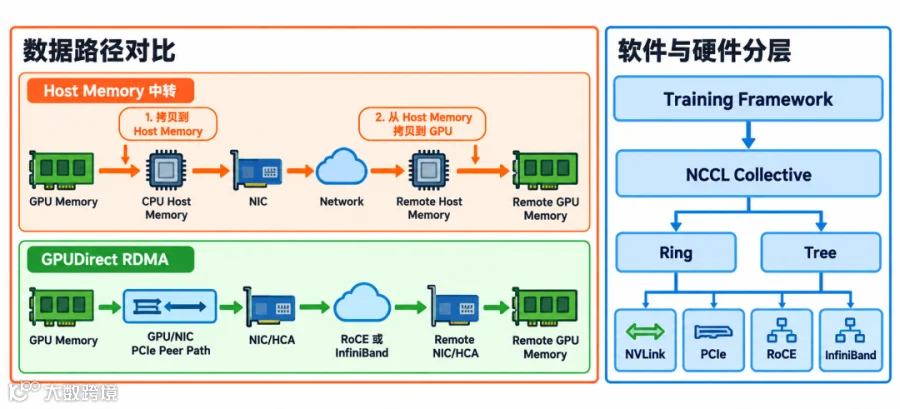
图8:GPUDirect RDMA 减少 Host Memory 中转,NCCL 则在底层互联路径上组织 Ring、Tree 等集合通信算法。
实际测试中,经常会看到两种落差:
· 底层 RDMA 点对点测试很快,但 NCCL 映射到的 GPU-NIC、Rail 或 Collective 路径不理想;
· nccl-tests 很快,但真实模型没有把通信与计算重叠,或者并行策略制造了更多通信。
网络联通、P2P/RDMA 带宽、Collective 带宽和训练 step time 分别回答不同的问题,不能互相替代。
带宽数字要结合工作负载看
GPU 集群资料中的带宽数字,常常采用不同的单位、方向和统计范围。放在一起比较前,需要先确认以下五项信息:
1. 单位:Gb/s 与 GB/s 相差 8 倍,协议开销还要继续扣减;
2. 方向:单向带宽和收发相加的双向带宽不是同一个数字;
3. 范围:每 Lane、每 Link、每 Port、每 GPU 与整机 Aggregate 不可互换;
4. 端点:系统总带宽不代表任意两个端点都能获得相同比例;
5. 测量层级:线速、P2P、RDMA、Collective 和真实训练分别包含不同开销。
一张 400 Gb/s 网卡,理论线速可以粗略换算成 50 GB/s,但这不是单 GPU 的保证带宽。多张 GPU 可能共享网卡,协议要占用带宽,PCIe 上行可能超卖,交换网络还可能拥塞。NCCL 的 Algorithm Bandwidth 和 Bus Bandwidth 也有各自定义,不能直接等同于端口线速。
All-to-All 还要关注 Bisection Bandwidth(二分带宽)。单端口很快,如果跨越拓扑中部时的可用总带宽不足,大量端点同时互发仍会形成瓶颈。
比较网络时,先统一单位、方向和聚合范围,再检查拓扑与超卖,随后依次测试 P2P/RDMA、Collective 和真实训练。链路状态正常只是起点。
网络需求还会随并行方式变化:
· Data Parallel 更关注大消息持续带宽、Ring/Tree 映射和慢 Rank;
· Tensor Parallel 通信频率高,通常应尽量放在同一 NVLink/NVSwitch Domain;
· Expert Parallel 的 All-to-All 对二分带宽、Hash、流量突发和专家负载不均更敏感;
· Pipeline Parallel 关注相邻 Stage 的路径,但阶段计算不均和 micro-batch 也会制造 Bubble。
如图 9 所示,不同并行方式会把通信压力放在不同位置:TP 更依赖 Scale-up 域,DP 和 EP 则更容易把流量带到节点间网络。

图9:TP 更依赖 NVLink Domain 内的高速通信,DP 需要跨节点同步,PP 传递阶段间激活与梯度,EP 则容易产生密集的 All-to-All 流量。
分布式推理还会带来新的流量形态,例如 Prefill/Decode 分离中的 KV Cache 传输。它更关注时延、流控和请求生命周期,不能直接套用训练 AllReduce 的结论。
网络慢,从哪一层开始查
AllReduce 变慢时,直接修改 NCCL 参数,很容易把多个问题混在一起。更稳妥的顺序是:设备健康、拓扑、RDMA、Collective、真实训练。
第一层:检查物理链路和设备。
· PCIe Link Width、Speed 是否降级;
· NVLink/NVSwitch 是否出现 CRC、Replay、Recovery 或其他错误;
· NIC/HCA、交换端口、线缆和光模块是否有误码、丢包或降速;
· 问题是否集中在固定节点、端口或时间段。
链路显示 Up,只说明设备已经连通。偶发误码和自动降速,可能要到高压流量下才会暴露。
第二层:核对 GPU、NIC 与 NUMA 拓扑。
· 用 nvidia-smi topo -m 和 DCGM 查看 GPU、NIC、CPU 关系;
· 用 lspci -t 核对 PCIe Tree;
· 检查 Rank 到 GPU、NIC/Rail 的映射;
· 确认通信紧密的 Rank 是否处于同一 NVLink 域;
· 检查双 Rail、多 Rail 是否真正均衡使用。
如果性能下降总是跟着某一组 GPU-NIC 组合移动,问题多半出在拓扑或亲和性,不必一开始就怀疑整个 Fabric。
第三层:建立 P2P 与 RDMA 基线。
先测 GPU P2P,再测主机或 GPU 内存上的 RDMA Read、Write、Send。RoCE 环境要同时观察 ECN、CNP、PFC、丢包、重传、Buffer 和队列;InfiniBand 环境则要看端口计数、路由、拥塞和慢链路。
GPUDirect RDMA 是否真正启用,也要从日志和实测结果确认。配置文件中写了 RDMA、驱动已经加载,实际数据仍有可能退回 Host Memory 中转。
第四层:验证 Collective 的实际路径。
使用 nccl-tests 分别测试 AllReduce、AllGather、ReduceScatter 和 All-to-All,并扫描不同消息规模。结合 NCCL 日志确认它选择了哪个网络接口、Transport 和拓扑路径。
小消息慢而大消息正常,问题可能更偏向时延、软件启动和路径建立;大消息带宽上不去,要继续检查共享上行、拥塞和算法映射。AllReduce 正常、All-to-All 异常,则更应关注二分带宽、Hash 和突发流量。
第五层:回到真实训练。
观察哪个 Collective 占用时间最多、慢 Rank 是否固定、通信与计算是否重叠,也要排除 DataLoader、检查点和 CPU 抖动伪装成网络等待。扩展到更多节点后,新增通信量本来就可能抵消一部分计算收益。
排查时,需要区分这几个结果:
如图 10 所示,这套排查顺序从物理链路开始,逐层进入拓扑、RDMA、NCCL Collective 和真实训练。
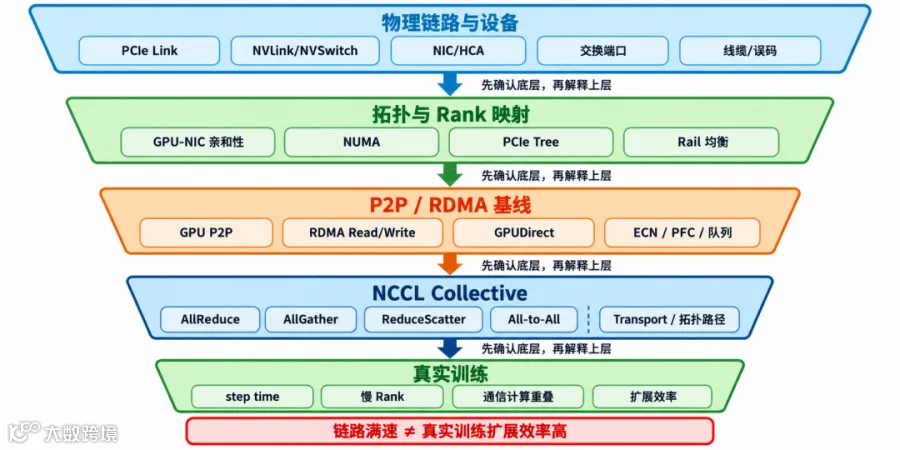
图10:通信排障应从物理链路逐层检查到拓扑、RDMA、NCCL Collective,最后回到真实训练 step time。
最后:网络是一条完整路径
回到开头那项从 8 张 GPU 扩展到 16 张 GPU 的训练任务。
只看服务器数量,很容易把问题归结为“新加的 8 张卡没有发挥作用”;盯着网卡,又会把问题缩小成“400 Gb/s 没跑满”。沿着完整数据路径检查,限制可能出现在多个位置:GPU 到 NIC 跨了 NUMA,Tensor Parallel Rank 被拆出 NVLink 域,RoCE 队列在突发流量下形成热点,或者 NCCL 选择的 Rail 与物理拓扑不匹配。
四种技术各自对应一段路径:
真实通信会把这些链路串在一起:
评估 GPU 集群网络,要看高频通信是否留在合适的 Scale-up 域,跨节点数据是否经过较短的 GPU-NIC 路径,Fabric 在突发和满载时是否稳定,以及 NCCL 能否把硬件能力转化成实际 Collective 性能。
这些条件同时满足,新增 GPU 才能稳定缩短训练时间。否则,扩容带来的可能只是更多 GPU 一起等待。
► 从零走向 AGI 系列
► 技术专栏: 多模态大模型最新技术解读专栏 | AI 视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏 |
参考链接
1. https://ai-mzq.github.io/From-Zero-to-AGI/:https://ai-mzq.github.io/From-Zero-to-AGI/
2. NCCL:https://docs.nvidia.com/deeplearning/nccl/
3. PCI-SIG 的 PCIe 6.0 说明:https://pcisig.com/pci-express-6.0-specification
4. NVIDIA DCGM 的拓扑说明:https://docs.nvidia.com/datacenter/dcgm/latest/learn/core-services/topology-and-links.html
5. CUDA GPUDirect RDMA 文档:https://docs.nvidia.com/cuda/gpudirect-rdma/
6. NVIDIA 对 NVSwitch 的说明:https://docs.nvidia.com/ai-enterprise/release-8/latest/infra-software/vgpu/features/nvswitch.html
7. Hopper 架构:https://www.nvidia.com/en-us/data-center/technologies/hopper-architecture/
8. NVL72 组件说明:https://docs.nvidia.com/enterprise-reference-architectures/nvl72-ai-factory/latest/components.html
9. NVLink Network 与 IMEX:https://docs.nvidia.com/deploy/imex-service/overview.html
10. MLNX_OFED 的 RoCE 模式说明:https://docs.nvidia.com/networking/display/mlnxofedv23102131201lts/ethernet-network.pdf
11. NVIDIA Cumulus 的 RoCE 文档:https://docs.nvidia.com/networking-ethernet-software/cumulus-linux/Layer-1-and-Switch-Ports/Quality-of-Service/RDMA-over-Converged-Ethernet-RoCE/
12. InfiniBand Trade Association 的介绍:https://infinibandta.org/about-infiniband/
13. NVIDIA RDMA 编程手册:https://docs.nvidia.com/rdma-aware-networks-programming-user-manual-1-7.pdf
14. NVL72 网络架构:https://docs.nvidia.com/enterprise-reference-architectures/nvl72-ai-factory/latest/network-logical-architecture.html