

导读
随着风控策略收紧,账号环境的不确定性让不少人对重度投入心存顾虑,转而选择成本相对可控的 Pro 订阅来运行 Claude Code。然而很多人刚切换过来就遇到了现实阻碍:明明没写几行代码,5 小时的使用配额很快见顶,甚至一条长任务还没跑完就遭遇限流中断。
在终端自主编码场景下,工具的运行逻辑与传统的网页单轮提问完全不同。每一次文件检索、每一条终端命令输出以及历史对话的累积,都在持续推高后续交互的输入规模。
如果任由上下文不受控地增长,Token 消耗速度往往会超出预期数倍。理清底层的缓存机制、合理设定上下文压缩阻尼区间、重构子代理的协同节奏,能让有限的配额支撑起完整的开发闭环。
缓存的经济学账本:为什么集中冲刺远比断续提问划算
决定 Claude Code 消耗速度的核心,是 Anthropic 的 Prompt Caching(提示词缓存)机制。
无论是 API 按量计费,还是 Pro 账号的 5 小时动态额度折算,底层的算力消耗逻辑都是一致的:首次将一段上下文写入缓存时,需要按基准输入的 1.25 倍计算开销;而一旦在后续请求中成功命中该缓存前缀,读取成本直接降至基准价格的 0.1 倍,相当于获得了高达 90% 的折扣。
这意味着,只要前缀保持连续稳定,多轮交互中只有新产生的一小部分增量是在按全额计算,其余成千上万 Token 都在以极低的成本反复复用。
然而,缓存是有保鲜期的。
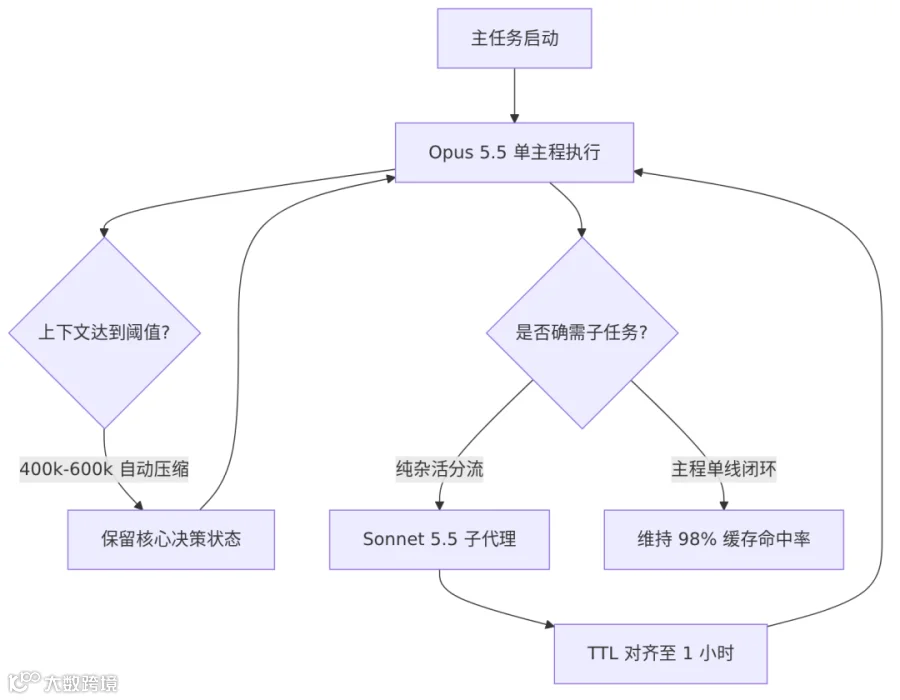
在 Claude Code 的工作流中,主 Agent 的缓存有效时间通常为 1 小时。如果在当前任务进行中,你能够集中注意力连续推进,让每一次对话都在缓存过期前触发,那么整个会话的缓存命中率可以轻松维持在 95% 至 98% 以上。
相反,如果手头放着一个复杂的任务,改了两行代码就去处理其他事情,隔了几个小时再回终端输入一句继续,此时原本建立的庞大缓存已经全部失效。
断断续续的交互习惯会引发昂贵的冷启动重算,把每一次提问都变成了大几万 Token 的全量写入。
因此在任务编排上,把零碎的试探性提问转变为集中冲刺的工作流,在短时间内一气呵成完成一个完整模块,是守住高缓存命中率的基本前提。
阻尼区间:别让主力模型盲目跑满 1M 上下文
许多开发者在使用 Opus 5.5 作为主力模型时,容易产生一种容量安全感,认为既然模型支持高达 1M 的超长上下文,就可以毫无顾忌地一直聊下去。
实践表明,把上下文推到极限往往伴随着多重负面代价。
首先是严重的性能与反应延迟衰减。当单次上下文堆积到 700k 甚至更高时,模型推理的排队与生成延迟会成倍拉长,终端交互的流畅度断崖式下跌。
其次是注意力的分散与幻觉增加。海量的长文本中夹杂着过期的调试报错、冗余的日志打印与旧版代码片段,模型极容易在茫茫信息流中迷失焦点,出现前后指令冲突或改动失准。
更直接的是额度风险。一旦发生前缀缓存未命中的情况,数百 K 的庞大上下文将直接触发全额计算,瞬间消耗掉大半配额。
一个行之有效的折中方案,是在 400k 到 600k 之间主动设立自动压缩机制。
|
|
|
|
|
|---|---|---|---|
| 缓存命中成本 |
|
|
|
| 推理速度与延迟 |
|
|
|
| 逻辑连贯性 |
|
|
|
上下文过短会损害代码分析的全局视野,而过长则会拖垮速度与成本。把压缩阈值锚定在 400k 到 600k 区间,既能为模型保留充沛的架构决策链条,又能有效阻断无节制的体积膨胀。
遇到长会话时,主动运行 /compact 提炼技术决策概要并剔除冗余的工具调用碎片,比起直接用 /clear 清空会话,能更平滑地过渡到下一个研发阶段。
子代理治理:警惕隐秘的上下文裂变
多 Agent 协同在概念上十分诱人,但在 Token 账本里,子代理也是消耗失控的高发地带。
直觉上,很多人认为把具体任务拆派给多个子代理并发执行能够提升效率。但往往忽略了一点:每一个独立启动的子代理,都需要重新加载一份属于它自己的系统设定、项目规范与局部上下文。
这意味着,主 Agent 辛苦积累的高命中率缓存链条并不能凭空照搬给子代理,子代理的创建本身就是一次新的 Token 支出。
治理子代理的消耗,可以从三个维度收紧:
1. 严格控制派发阈值,优先保持单主程闭环
如果一个任务主 Agent 可以在适度压缩的前提下独立完成,就尽量避免轻易召唤子代理。
实测数据显示,单主程在持续对话中的缓存命中率通常在 95% 以上,整体 Token 走势非常平稳。一旦频繁引入外部代理打配合,即使执行非常简单的任务,多份上下文的初始化与跨进程沟通也会迅速推高消耗。
2. 角色分工降级:杂活交给 Sonnet 5.5
当确实需要子代理去分担检索、扫描或者临时编写测试用例等具体工作时,主力模型应该退居二线。
在这一层级,使用 Opus 5.5 并不会带来质的产出提升,反而徒增数倍开销;而过度降级到更小规格的轻量模型,又往往因为推理能力不足而陷入死循环与纠错重试,最终省下的单价全被翻倍的重试轮次抵消。让 Sonnet 5.5 承担子代理的脏活杂活,是兼顾任务确定性与资源消耗的理性选择。
3. 主动将子代理缓存时长延长至 1 小时
在默认机制中,部分执行框架对子代理的缓存保持周期设定得相对短暂,甚至短至 5 分钟。
这导致一旦前序分析稍微拉长,或者子代理之间的轮换出现间隔,子代理的缓存就会快速过期。再次被唤起时,庞大的基准上下文被迫重新全量写入,从而形成大批原本可以避免的高额输入。通过环境配置将子代理的缓存保持窗口主动扩展至 1 小时,能够有效规避这一隐形陷阱。
保持前缀纯净:避开那些无意识的缓存破坏操作
在日常开发中,还有不少看似微小的操作习惯,会在不知不觉中打断前缀缓存。

Anthropic 的缓存匹配依赖于绝对一致的前缀序列。只要从文本最开头的系统提示词、配置文件到前面的对话历史中有任何一个字符发生变动,整个断点之后的所有缓存就会瞬间作废。
常见的三类隐性损耗需要重点留意:
第一,会话中途频繁改换全局指令或修改根目录的项目说明文件。如果在聊了十几轮之后突然修改了项目的顶层说明,或者在终端会话里切换模型参数,这相当于亲手截断了前缀缓存链条,迫使系统从头重新构建冷缓存。
第二,无节制的终端长日志与全量仓库扫描。让 Agent 动辄执行不受控的全局检索或者打印上千行报错堆栈,会迅速污染上下文。借助轻量过滤工具先对输出进行清洗截断,避免无效文本涌入上下文窗口,能节省下大量宝贵的上下文额度。
第三,忽视局部小环境的隔离。在处理大型仓库时,将不同模块的专属规则拆分到各自的子目录下按需加载,而不是把成百上千行的规则全部堆叠在根配置中常驻,能够让初始前缀更加清爽精简。
关键结论
-
• 冲刺胜过漫步:集中时间段高密度推进单个任务,利用主 Agent 的 1 小时缓存窗口将命中率维系在 95% 以上,避免散漫交互带来的重复冷启动写入。 -
• 划定压缩阻尼线:坚决不在 1M 上下文极限边缘游走,在 400k 至 600k 区间主动触发自动压缩,平衡思考深度、推理时延与 Token 开销。 -
• 收敛子代理规模:能单主程闭环的任务绝不随意分裂子代理;必须派发杂活时首选 Sonnet 5.5,并将缓存超时时长主动延长至 1 小时以防失效。 -
• 守护前缀一致性:不在会话中途随意变动顶层配置文件或切换核心模型,严控长日志灌入,保护缓存链条的完整性。
在智能编码工具从代码补全走向自主执行的阶段,Token 优化的核心从来不是抠搜单个词句,而是建立适应缓存特性的工程节奏与边界意识。