

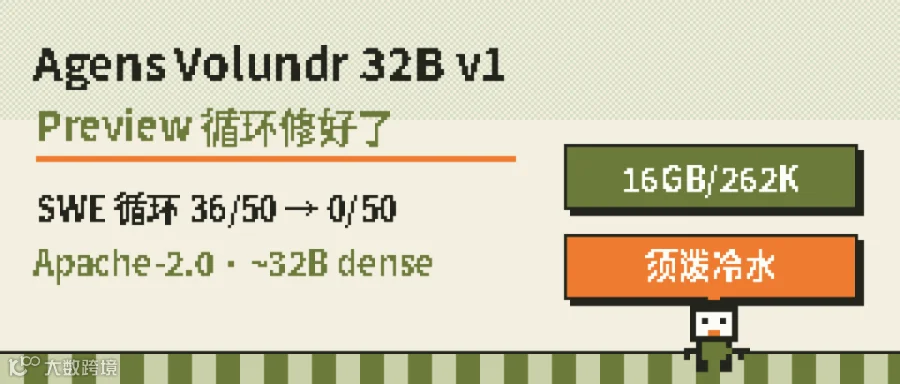
10 月 18 日(UTC 约 08:56),Blockway 在 X 发帖:Agens Volundr 32B v1 开源权重,Apache-2.0。同日 Hugging Face 模型卡上线。主帖互动很少,读到时点展示量大约二十来次——别当热度叙事,以模型卡一手为准。
更值得盯的是两件反差。第一,Preview(约 10 月 5 日)在长 Agent 会话里会重复循环:模型卡自报 SWE-bench 任务里 36/50 撞上 repetition loops;v1 同口径变成 0/50。第二,宣传口径里有一句很刺眼的「一张 16GB 卡、262K 上下文」——下面会拆:那是 Agens Engine 的 Engine-16GB 构建,在 48GB 卡上把显存 cap 到 16GiB 测出来的,不是「随便买张消费级卡插上就稳」。
本篇避开近几日「大总参小激活 MoE」的写法,按老规矩拆:它能干嘛,对做应用/本地部署意味着什么,冷水泼在哪。跑分一律标「模型卡自报」。
01
PART
它能干嘛
WHAT IT DOES
定位很清楚:开源权重,面向 coding / reasoning / agent,是 Agens 产品背后的模型。v1 是 Preview 宣布过的完整释放——同一套架构,续预训练跑完,后训练按长 Agent 会话来做。语言:英语、简繁中文、粤语;多模态可吃图;工具调用与 Blockway 控制 token / chat template 齐套。
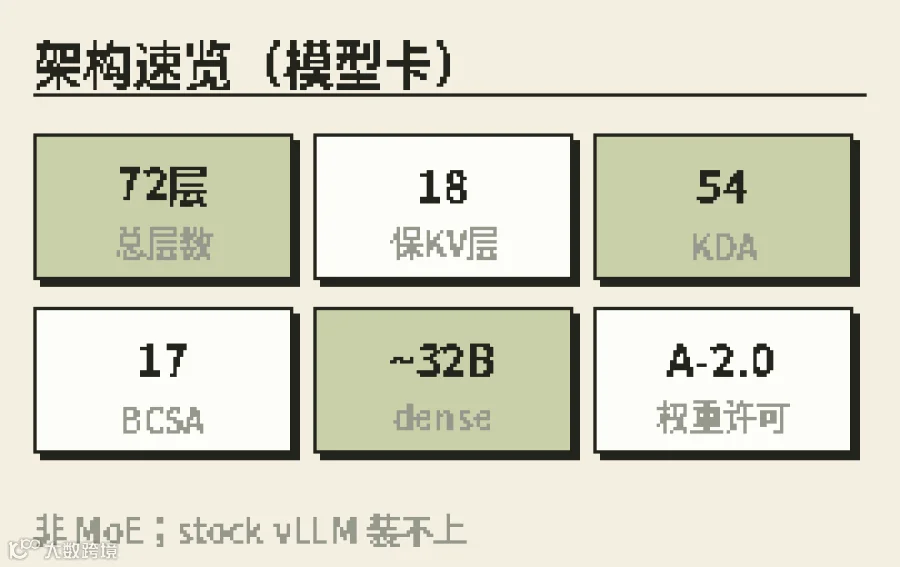
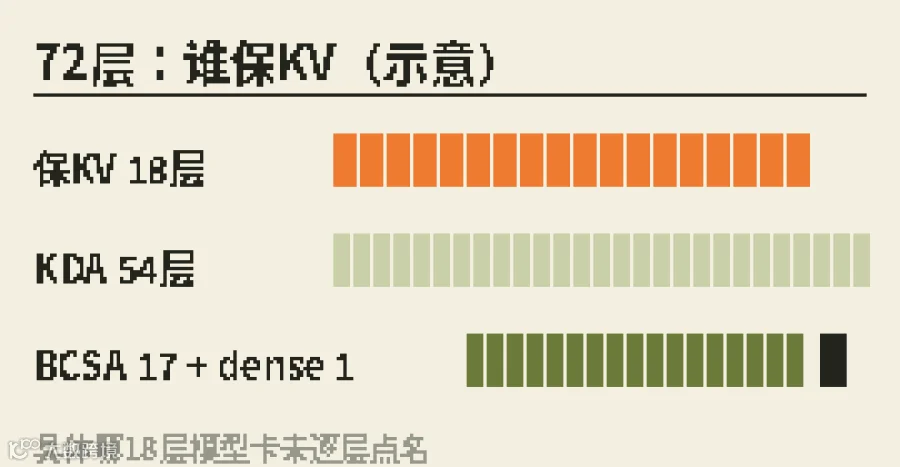
架构不是 MoE:约 32B dense。72 层里只有 18 层保留 KV cache;其余按模型卡写的是 54 层 KDA(线性注意力、固定大小状态)+ 17 层 BCSA(压缩稀疏注意力)+ 1 层 dense 全注意力,外加 Engram 查表与 mHC 残差混合。对本地部署的人,这意味着:长上下文时 KV 压力理论上比「72 层全保 KV」轻一截,但也意味着 stock vLLM 装不上——要走 Blockway 的 sglang 构建、llama.cpp 的 volundr 分支,或他们的 Agens Engine。
训练侧模型卡写得很直白:v1 是 Preview 主干续到最终 checkpoint(约 step 20,000);续预训练堆了仓库级代码、代码与数学语料、英/中/粤网页,以及 GitHub issues,并用 logit 蒸馏做 chat 格式回放。后训练对准 agent:身份、工具使用(含并行调用、以及「不该调工具时拒绝」)、多轮轨迹;再挖三轮偏好(抗重复、「答完就停」、长度对)。教师输出声明只来自宽松许可开源权重(并写明拿到 Moonshot 书面许可用 Kimi K3),没有 Anthropic / OpenAI / Google 模型输出——对要做合规审计的私有化项目是加分项,但别理解成「训练数据可审计到每一条」。
36→0
SWE循环/50
27/50
SWE mini
2.9×
后续轮次
Preview→v1,模型卡给了一张修复表(均标「模型卡自报」):长会话重复循环 36/50→0/50;SWE Verified mini 22→27/50(表 54.0% vs 44.0);τ²-bench 89→92/120(表 76.7 vs 74.2);中位 SWE 任务 124→82 分钟;后续轮次约 2.9× 更快。thinking 失控撞 32K 截断的问题,官方口径改成中位约 120 token/步、最长约 12K、无步 ≥16K。

对照表另一列是他们同 harness 跑的 Qwen3.8-27B:LiveCodeBench v6,v1 67.9(Preview 63.4;Qwen 59.5);AIME 2025,v1 80.0(Preview 76.7;Qwen 73.3)。HumanEval 要单独看:v1 bf16 是 78.7,Preview 反而是 81.7——模型卡自己写了相对 Preview 在 HumanEval / IFBench / GPQA 上让了几分。GPQA Diamond:bf16 80.3;Engine-16GB(约 2.82 bpw)73.7;HumanEval Engine 73.2。
速度侧(仍是官方自报):DFlash2 drafter 在结构化输出上,双 48GB bf16 约 3.0×(约 75.9 tok/s),单 48GB INT4 约 3.0×(约 124.7 tok/s)。decode 从 1K 到 128K 自称平坦。drafter 是为 一到两路并发 设计的;多用户会话服务看 README 无 drafter 配置。session continuation 的 2.9×,来自 20 段多轮誊本、484 轮次、INT4 单 48GB 的 greedy 回放。输出是 greedy-equivalent,不是字节级完全一致——做回归别拿「逐 token 一致」当过关标准。
02
PART
对做应用的人意味着什么
WHY IT MATTERS
第一,这是本地 Agent 栈,不是「换个 OpenAI 兼容 endpoint 就完事」。聊天格式用 Blockway 控制 token;thinking 默认开,可用 enable_thinking: false 关;reasoning_effort 接受 low / medium / xhigh(high 是别名)。服务 README 指向 docker 镜像 ghcr.io/blockwayz/agens-sglang:v1-sm89(Ada 48GB)与 :v1-sm90(H100/H200)。想开 session continuation,要设 VOLUNDR_RADIX_SESSION=1 并按 README 改 flag——别假设「开了 prefix cache 就自动 2.9×」。
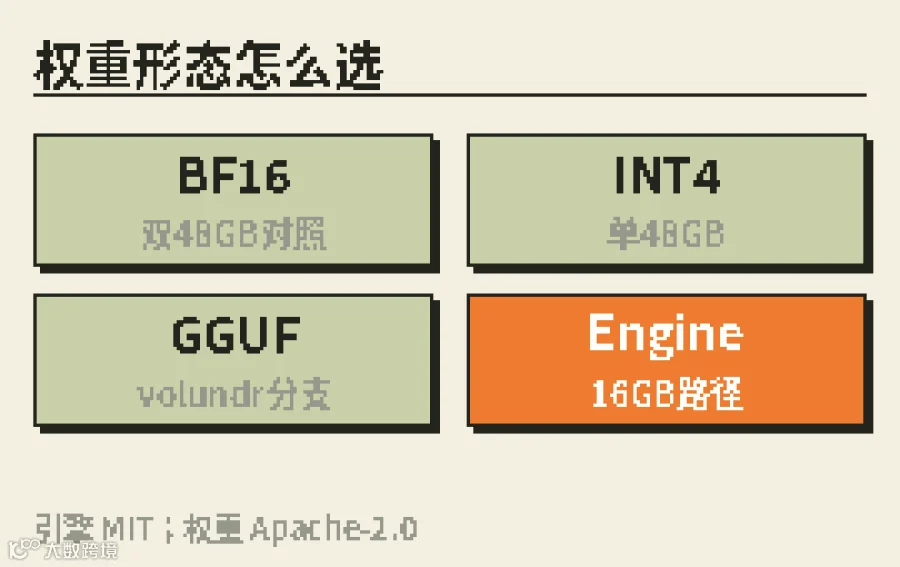
第二,权重形态先分清,再谈显存。BF16 主仓适合双 48GB 对照跑分;INT4 单 48GB,模型卡写单条 131K 输入约 24.6 GB;GGUF 要 llama.cpp 的 volundr 分支;Engine-16GB 只跑在 Agens Engine 上。权重 Apache-2.0,引擎 MIT——商用路径相对干净,仍要自己读 MODIFICATIONS.md 与客户合同。
第三,16GB 那句宣传,读成「有一条消费级路径」,别读成承诺。Engine-16GB 下载约 25GB;测速表是 Engine 1.1.0、单流、在 48GB 卡上 cap 到 16GiB。短上下文 greedy 聊天约 98 tok/s、agent(8K)约 150;塞进约 219K 文档后再 decode 会掉到约 57–83。模型卡明确写:这是本地跑通构建,不是冲榜构建;长文档开 thinking 可能循环或答错(110K 测例:10 次里 6 对、3 循环,对照同引擎 INT4 10/10)。显卡还要带显示输出时,可用显存可能低于 15.5 GiB。
第四,和「大总参小激活」那拨开源的差别,要跟客户说清楚。Volundr 是约 32B dense,卖点不在「参数更大」,而在长会话不循环、后续轮次可续跑、以及一条官方维护的本地引擎。SWE Verified mini 自报 27/50,同表里 Agens Pilot 64.0、Qwen 58.0——v1 坐在 Preview 与 Pilot 之间,别写成「开源 SWE 第一」。
第五,落地报价别只写「我跑通了 32B」。买家听得懂的是:私有化 Agent 是否装在他的机器/专有云、上下文上限写多少、是否允许多轮工具调用、过关标准是哪 20 个真实工单、改几轮。举个可写进方案书的例子:给内部研发搭「读仓库 + 改单测 + 开 PR 草稿」的 Agent——验收不看 LiveCodeBench,而看 20 个真实 issue 里有多少能在限定轮次内给出可合并的 diff、中位耗时、显存是否挤掉同机其他服务。

上手路径骨架(完整 flag 以官方 README 为准)
# A · Engine-16GB 镜像 ghcr.io/blockwayz/agens-engine:1.1.0
# 权重 Blockway/Agens-Volundr-32B-v1-Engine-16GB
# B · sglang 双卡示例
docker run --rm --gpus '"device=0,1"' --ipc=host \
-v ~/.cache/huggingface:/root/.cache/huggingface \
ghcr.io/blockwayz/agens-sglang:v1-sm89 \
python3 -m sglang.launch_server \
--model-path Blockway/Agens-Volundr-32B-v1 \
--tp-size 2 --reasoning-parser agens --tool-call-parser agens
# C · GGUF + llama.cpp volundr 分支
03
PART
冷水该泼哪
COLD WATER
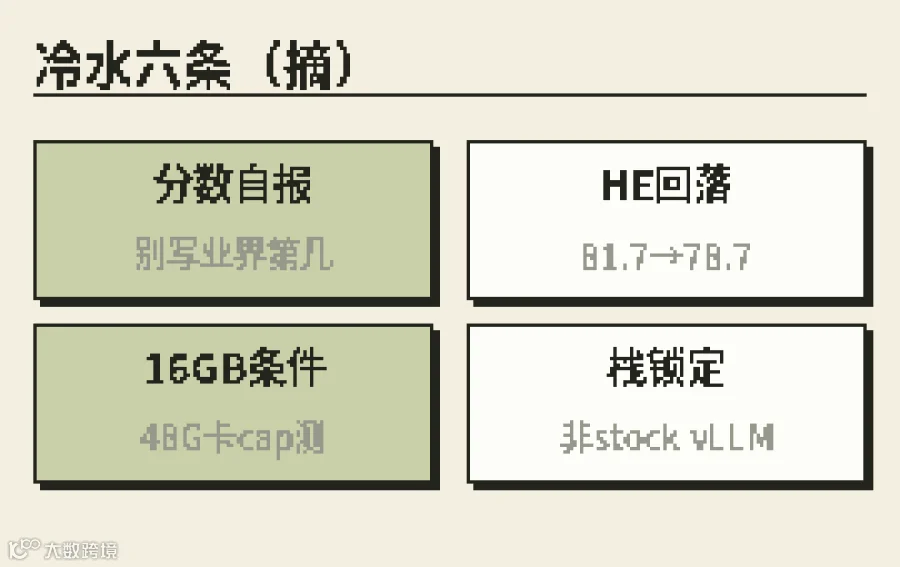
第一盆:这些分数是厂商自报。没有第三方同日复测之前,别把 67.9 / 80.0 / 54.0% 写成「业界第几」。对照列里的 Qwen3.8-27B、Agens Pilot,是他们同 harness 自跑,不是各家官网数字。
第二盆:HumanEval 相对 Preview 掉了。81.7→78.7(bf16),Engine 再掉到 73.2。模型卡承认 agent 训练瞄准的是 SWE / τ² / 长会话,代码补全这类会让分。对外宣传若只截「全面提升」海报,属于选择性阅读。
第三盆:「16GB / 262K」不是无条件承诺。测试在 48GB 卡 cap 到 16GiB;262K 全文检索本 checkpoint 未再验证(模型卡写检索验证到约 107K);长文档 thinking 已知会退化。INT4 单卡 131K≈24.6GB 与 Engine-16GB 的 262K 是两条曲线,别混成一张显存表。
第四盆:服务栈锁定。stock vLLM 不能装;必须 Blockway sglang、volundr 分支 llama.cpp,或 Agens Engine。团队如果只有标准 vLLM 运维手册,迁移成本要算进项目报价。
第五盆:长文档开 thinking 仍可能循环。模型卡 scope notes:110K 小说 + 事实问答测例里,thinking 开启时仍有复读文档直到撞长度上限的情况;reasoning_budget 能关掉 thinking 块,但不总能救回答。生产侧默认:长文档先 thinking off,或上 INT4/bf16 再谈 16GB。
第六盆:X 主帖几乎没量。新鲜由头是「10-18 正式开源 v1 + Preview 修复表可核」,不是「全网刷屏」。
我的态度比较直:Volundr v1 值得看,是因为它把 Preview 最丢人的循环点按官方口径修掉了,还给出了一条真·本地 Agent 路径(引擎 MIT、权重 Apache)。但它不是「32B 万能、16GB 随便跑满 262K」。把回归集、显存实测和客户过关标准先钉死,比转发一张 36→0 的对比图有用。
CHECKLIST
认准 HF 仓 → 选权重形态 → 选服务栈 → 关/开 thinking → 20 个真实工单回归 → 再写私有化报价一页纸。
照着做:① 只认 Blockway/Agens-Volundr-32B-v1 与官方 engine/sglang 仓,别下错 Preview 权重或 Preview drafter(v1 要配 v1 的 DFlash2);② 按机器选 BF16 / INT4 / GGUF / Engine-16GB,一张表贴进运维文档;③ stock vLLM 直接排除,预留 sglang 或 Engine 的排障时间;④ 长文档默认 thinking off,短工具调用再开;⑤ 用自己的 20 个多轮工单测循环率、中位耗时、显存峰值;⑥ 对外报价写清交付物、上下文上限、改几轮、不保证接单量;⑦ 许可对外说 Apache-2.0 + Engine MIT,合同仍要法务过一眼。
很多人卡在第 ⑥ 步:docker 起来了,OpenAI 兼容口也能打,就是不知道怎么变成一单私有化/Agent 生意。买家、交付文件、过关标准、改稿轮次,和模型卡上的 67.9 没有自动换算关系。
你会不会在本地试 Engine-16GB,还是直接上双卡 bf16?评论区聊聊。
出处:Blockway 官方 X @blockwaylink(10月18日)、Hugging Face 模型卡 Blockway/Agens-Volundr-32B-v1、github.com/BlockWayz/agens-engine 与 agens-sglang。
往期 · 接着看
DeepSeek发Flash-1017:API名字没变,自报终端题42.3(旧31.2)
Reflection开源Beam:501B只激活23B,Apache 2.0可商用,第三方测出幻觉率47%
Meta开源Muse Spark Open:816B只激活42B,两台Mac能跑?NVFP4仍要约700GB显存
「AI商业实战」新人邀请礼遇 ¥25,进圈可领两张短卡:「交付定义卡」把买家、交付文件、过关标准、改稿轮次一次写清;「一周试跑清单」按天跑通一个最小交付闭环。不保证接单,帮你少走弯路。
少走弯路,先跑通第一条 AI 生产线。新人邀请已备好。

新人邀请礼遇:开启 AI 实战交流
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING