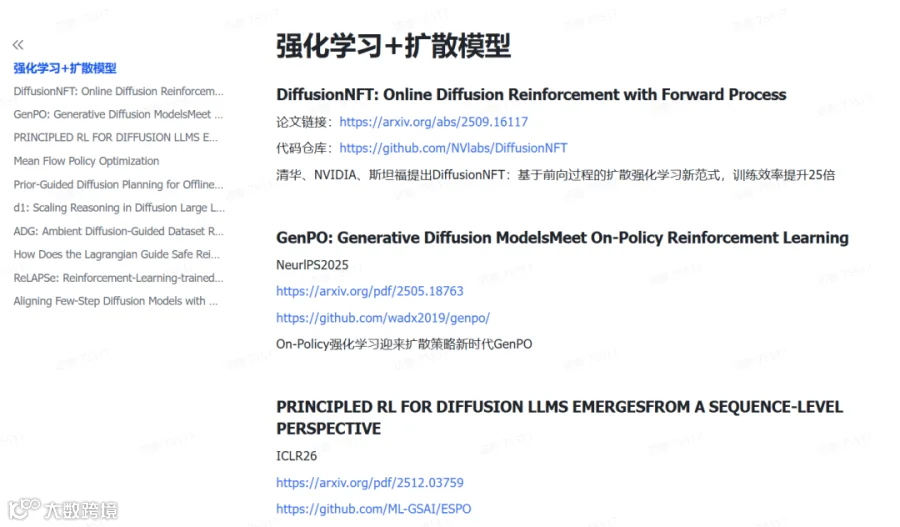
近期我们针对强化学习+扩散模型的前沿成果进行了深度整合,从中筛选出23篇很有参考价值的论文,收录了TPAMI、NeurIPS、ICLR等顶会顶刊上的相关工作,并配套整理了开源代码实现。
这些论文基本覆盖了当前主流方法与技术瓶颈,特别适合正在准备论文的朋友,无论你是想找创新突破口、设计课题方案,还是想复现经典模型,都能提供实质性帮助。
扫描下方二维码,回复「强扩散 」
免费获取全部论文合集及项目代码

DiffusionNFT: Online Diffusion Reinforcement with Forward Process
内容:
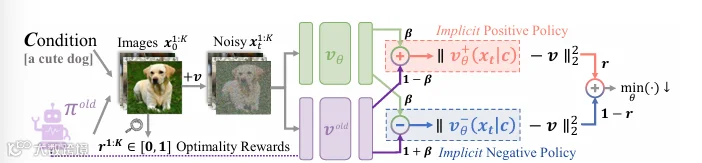
本文提出DiffusionNFT这一全新的在线强化学习范式,借助流匹配直接在扩散模型前向过程做优化,通过对比正负样本生成结果得到隐式的策略更新方向,将强化信号融入监督学习目标,无需似然估计,仅使用干净图像即可完成策略优化,支持任意黑盒求解器,摆脱分类器自由引导CFG依赖,相比FlowGRPO大幅提升训练效率,结合多种奖励模型进一步增强扩散模型的各项基准表现。
GenPO: Generative Diffusion Models Meet On-Policy Reinforcement Learning
内容:

本文提出GenPO生成式策略优化框架,借助精确扩散反演构建可逆动作映射,设计双倍虚拟动作机制通过交替更新实现可逆性以解决扩散策略状态‑动作对数似然难以计算的难题,依托变量替换定理得到精确似然,进一步完成扩散策略熵与KL散度的无偏估计,实现KL自适应学习率与熵正则化,在重构的马尔可夫决策过程下适配PPO,引入压缩损失抑制无效探索,最终在IsaacLab多项机器人任务上完成验证,实现扩散策略与在线同策略强化学习的结合。
扫描下方二维码,回复「强扩散 」
免费获取全部论文合集及项目代码
Mean Flow Policy Optimization
内容:
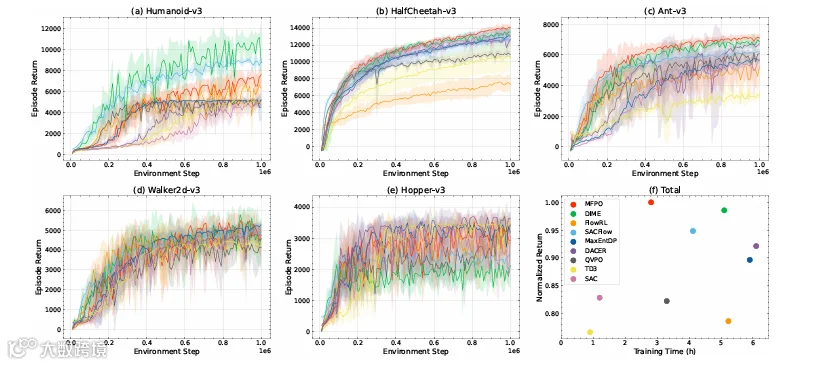
本文提出MFPO算法,将少量步长的MeanFlow模型用作策略表示,在最大熵强化学习框架下借助软策略迭代完成优化,引入平均散度网络近似难以求解的积分以实现动作似然高效计算,采用基于有效样本数加权的自适应自归一化重要采样方法估计瞬时速度来构建策略改进损失,同时搭配分布型评判网络、自动温度调优与候选动作选择等技术,在MuJoCo和DeepMind Control Suite测试环境下,以更少采样步数获得和现有扩散类基线相当甚至更优的效果,显著降低训练与推理开销。
d1: Scaling Reasoning in Diffusion Large Language Models via Reinforcement Learning
内容:
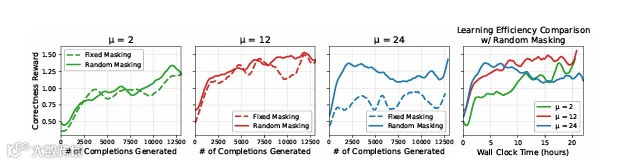
本文提出d1两阶段后训练框架来提升掩码扩散大语言模型dLLM的推理能力,先采用掩码监督微调SFT从推理数据集蒸馏知识、赋予模型自我纠错行为,再提出无评论家、基于策略梯度的diffu‑GRPO算法,借助均值场近似与随机提示掩码实现高效的一步对数概率估计,把GRPO适配到掩码扩散大语言模型,随机掩码还充当正则提升每批次梯度更新次数、降低在线生成开销,在数学、规划与代码多类推理任务上验证,SFT结合diffu‑GRPO的组合方案相比单独使用其中一种方式可以取得最优推理效果。
扫描下方二维码,回复「强扩散 」
免费获取全部论文合集及项目代码