


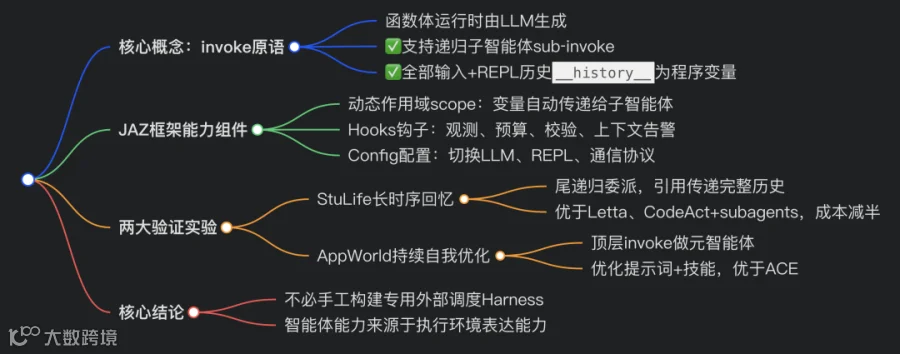
invoke:将其视作运行时由 LLM 生成函数体的语言原语,模型可写递归调用invoke的代码,并且所有输入、REPL 交互历史都作为代码内可编程变量,区别于 CodeAct、RLM 仅把历史当作展示消息。 JAZ 无需专门外置记忆、元优化调度组件,仅依靠提示词就实现长时序记忆、持续自我优化两大能力。在 StuLife 长回忆任务,JAZ‑invoke 远超专用记忆框架 Letta,开销仅约其一半;在 AppWorld 自优化基准,性能超越 ACE,成本更低。 依靠尾递归委派,上下文溢出时无损传递完整历史引用解决超长回忆;顶层 invoke 充当元智能体,迭代优化子智能体提示词与技能实现自我改进。框架依靠动态作用域、钩子系统实现预算、日志、校验等扩展。研究指出:很多智能体能力源于计算环境表达力,而非手工定制调度系统。

10 个关键问题问与答 Q&A
- Q:JAZ 框架核心原语 invoke 是什么?
A:语言级原语,每次调用,函数体由大模型运行时动态生成;支持递归子智能体,所有交互历史可以直接作为 REPL 变量读写。 - Q:invoke 和 CodeAct 最大差异?
A:CodeAct 仅把历史、提示词展示给模型;invoke 将 __history__、输入全部变成可被代码读取、传递的程序变量。 - Q:JAZ 如何实现长时序记忆,没有外置记忆库?
A:采用尾递归委派,上下文快满时,把子任务交给子智能体,通过引用无损传递完整历史对象,不需要摘要压缩、向量数据库。 - Q:StuLife 数据集用来测什么?
A:长时序远距离回忆;模拟一学期学生任务,很多题目需要回忆相隔上百个任务之前的信息。 - Q:为什么 Letta(MemGPT)在该论文部分场景不如 JAZ?
A:Letta 依赖内置关键词 + 向量检索工具,工具存在固有假设;遇到需要精确字符串检索场景检索效果受限。 - Q:JAZ 如何实现持续自我优化?
A:顶层 invoke 充当元智能体,批量派发任务给子智能体;读取子智能体返回的 __history__轨迹,迭代优化子智能体提示词、自定义技能。 - Q:对比 ACE 自优化框架,JAZ 优势?
A:ACE 是人工固定流程,仅优化提示词、元调用开销巨大;JAZ 元智能体自主决定批大小,同时优化提示词 + 技能,成本更低。 - Q:JAZ 中钩子 Hook 有什么作用?
A:提供非侵入扩展:日志追踪、预算管控、递归限制、返回值校验、上下文窗口告警,不改动核心 invoke 循环。 - Q:什么是动态作用域 scope?
A:变量在 with scope 块定义后,顶层以及所有递归子智能体自动获取变量,不用每次调用 invoke 显式传参。 - Q:论文的核心思想结论是什么?
A:很多所谓需要专用调度框架的智能体能力(记忆、自我改进),不需要手工搭建外部系统;可以来自底层执行环境强大的计算表达能力。
作者:李振宁、约书亚・刘、妮可・沈、苏普里亚・拉尔、阿米塔尤什・塔库尔、亚历克斯・张、玛特亚・武凯利奇、奥马尔・哈塔卜、乔纳森・莱特、阿曼多・索拉尔‑莱扎马 (1 麻省理工学院计算机科学与人工智能实验室;2 独立研究者) 同等贡献预印本・arXiv:2609.26891v1 [cs.AI] 2026‑09‑22
摘要
现代大语言模型智能体均围绕智能体循环构建:大模型置于具备一组工具的环境之中,交替调用工具、观测工具返回结果,以此完全掌控工作流。但部分工作流,例如记忆系统、自迭代优化系统,目前仍需要在智能体循环之外额外开发工程模块。 本文实现大模型智能体框架 JAZ,以此探究:仅依靠智能体循环本身的极简调度层,究竟可以多大程度完成那些原本需要专用系统才能实现的任务。 JAZ 对外暴露唯一基于大模型的原语invoke,并提供一套内置钩子,支持开发者增加约束与监控逻辑。invoke对现有代码模式智能体循环做了泛化,它满足两个核心定义属性:
-
大模型可以编写任意可执行代码,代码内部能够递归调用 invoke; -
大模型可见的全部内容 —— invoke的所有输入、以及代码环境的全部交互历史,全部都作为代码环境中的变量存在。
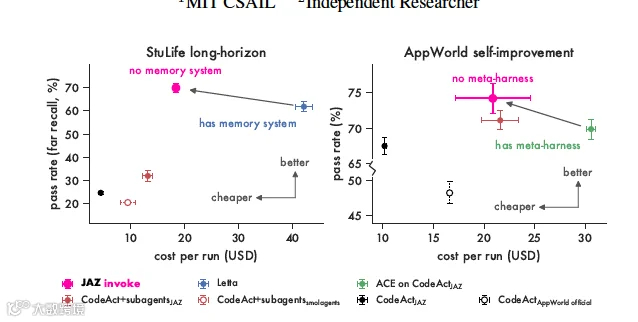
本文从第一性原理推导这套设计,将invoke视作一种语言原语:每次调用该函数时,它的函数体实现都在运行时由大模型生成。 为验证核心原语invoke的有效性,本文仅靠提示词,不使用手动开发工具、调度层、外部系统(例如记忆模块、文件系统),在原本依赖专用外部调度组件的多类工作流上开展评测。 在需要超出上下文窗口进行信息回忆的长时序任务 StuLife 中,针对强回忆需求子集,JAZ‑invoke 性能超越 Letta(MemGPT)8%,开销仅为后者一半; 在持续自我优化任务 AppWorld 上,JAZ‑invoke 以更低成本相比 ACE 性能高出 4%。
框架代码仓库:https://github.com/jaz‑lang/jaz 评测代码仓库:https://github.com/jaz‑lang/jaz‑evals
1 引言
大语言模型智能体的核心是智能体循环:模型通过动作与观测反复和环境交互。业界陆续提出表达能力越来越强的智能体循环范式。 早期 ReAct 允许模型在工作流每一步自由选择要执行的动作; CodeAct 在此之上进一步增强能力,允许模型在交互式 Python 解释器(REPL)中编写可执行代码编排任务。典型实现还支持向 REPL 传入 Python 对象供智能体调用。
更强的表达能力解锁了更多能力。递归语言模型 RLM 证明:仅靠带子智能体的 CodeAct,无需外部工具与调度层,就可以在长上下文任务上超越普通大模型,方法就是把输入包装成 Python 对象交给智能体在 REPL 中操作。
但即便如此,长时序记忆、自我迭代优化这类智能体能力,依然需要在循环之上叠加专门的外部调度系统。 本文研究:仅仅依靠智能体循环本身的极简调度层,是否就可以实现上述能力。为此我们构建智能体框架 JAZ,核心原语invoke是一层极简语言级抽象,泛化了 CodeAct 与 RLM。
我们从第一性原理推导invoke智能体循环:设想给任意图灵完备编程语言新增原语invoke,该函数的函数体由大模型运行时动态生成。尾递归调用invoke就会自然形成智能体循环,具备两大关键特性:
-
模型可以在这套扩展语言中编写任意可执行代码,工具、递归子智能体完全通过普通程序控制流完成编排。和 RLM 一样,递归子智能体成为默认能力。 -
模型能够看见的一切内容,同时都是代码环境内的变量。
现有的 CodeAct、RLM 实现虽然可以向 REPL 传入数据与工具,但invoke 更进一步:用户提示词、REPL 交互历史本身也会成为 REPL 内部变量。
本文证明:仅仅依靠提示词驱动这套极简智能体循环,就可以实现以往依赖专用调度层的智能体工作流。 在需要远超上下文窗口进行信息回忆的长时序任务中,当上下文占满时,JAZ‑invoke 会把剩余任务委派给子智能体,同时完整保留全部对话历史引用。使用 GPT‑5.4 nano,在 StuLife 高回忆需求子集上取得 70% 通过率,优于 CodeAct + 子智能体(32%)、专用长时序框架 Letta(62%)。 在 AppWorld 基准上,顶层invoke搭配 GPT‑5.4,子调用使用 GPT‑5.4 nano,智能体基于测试反馈在 REPL 内部迭代修改提示词与技能,实现 74% 通过率,优于 CodeAct(68%)、CodeAct + 子智能体(71%)、专用自我优化框架 ACE(70%)。
实验证明:仅靠提示词驱动极简智能体循环,就足以实现长时序记忆、持续自我优化能力,不必引入专门的外部调度组件。
本文主要贡献
-
提出并形式化原语 invoke:这是一种大模型编程语言构造,每次调用时,函数实现由大模型实时生成。 -
构建智能体框架 JAZ,以 invoke智能体循环作为核心。一套高表达钩子系统,支持可观测性、预算管控、结果校验,以及对智能体循环做各类修改。 -
通过实验证明:JAZ‑invoke 带来的更强表达能力,无需外部系统、工具、调度组件即可完成长时序、持续自我优化工作流。仅靠提示词,JAZ‑invoke 性能优于 CodeAct + 子智能体与各类专用调度框架,同时成本持平甚至更低。 
图 1 说明:JAZ 中invoke如同函数,每次调用都由大模型在 Python REPL 中生成实现。invoke全部输入,连同 REPL 历史,都作为 REPL 内部变量可用;递归子智能体成为默认行为。
2 invoke:基于大模型的语言原语
我们从第一性原理设计 JAZ:设想为一门现有编程语言增加大模型原语invoke。 invoke可以接收任意命名入参。入参可以是普通数据、任务描述、可供智能体调用的工具。invoke 不区分提示词、工具、普通数据,全部同等处理。
和静态写死实现的普通函数不同,每一次调用 invoke,它的函数体都由模型现场生成。模型读取入参的字符串描述,生成代码作为该次调用的函数体。
定义 1:对任意图灵完备语言,增加invoke原语后得到扩展语言。语法支持invoke(...),传入任意命名参数;语义为:把全部输入的字符串表示送入大模型,大模型输出扩展语言的代码,作为本次调用的函数体并执行。(λ 演算形式化定义见附录 A)。
传统大模型原语签名为字符串→字符串;invoke做了泛化,可以接收基础语言中任意类型对象,输出同样是基础语言对象。因此invoke是语言无关的大模型抽象,甚至适用于没有字符串类型的语言(例如 λ 演算)。
原则上,invoke表达能力至少等价于标准智能体循环:标准智能体循环可以通过尾递归形式的invoke实现。为模拟智能体循环 —— 模型读取代码输出,再决定下一步动作,可以让模型写出尾递归invoke调用,传入输入与交互历史,委派给子智能体,子智能体的上下文包含原有输入以及累积历史,完成智能体循环每一步。
直接让模型手写尾递归调用存在 Python 内存效率缺陷;同时大模型缓存优化要求连续查询之间具备前缀重合。因此实际工程中,不由模型手写尾递归,而由调度层自动追加尾递归调用并做尾调用优化,得到代码模式智能体循环,它继承函数式invoke的两大核心特征:
-
模型输出语言就是扩展后的语言(自带 invoke)。因此模型不仅可以写普通代码,还可以写 invoke 调用,即子智能体(子调用 sub‑invoke)。 -
大模型能看见的全部内容,都可以在代码中作为变量访问: invoke全部入参都作为变量,提示词、工具之间没有区分; -
REPL 交互历史本身,也是 REPL 内部变量。
特性 1 使invoke属于 CodeAct + 子智能体、RLM 同类范式。特性 2(REPL 历史可以直接作为 REPL 变量)是它区别现有代码智能体(smolagents、RLM)的关键点:现有框架把用户提示、REPL 历史仅仅作为展示给智能体的消息列表,不能作为变量供程序直接读写操作。
我们把满足以上两条属性的智能体循环称为invoke 智能体循环,对应函数式 invoke 的命令式版本,如同命令式 while 循环对应函数式递归。
3 JAZ:基于 invoke 的大模型智能体框架
JAZ 实现 invoke 智能体循环作为核心大模型原语,同时配套若干系统降低开发门槛。
动态作用域 dynamic scoping
不必把每一个参数显式传给 invoke。scope原语创建变量作用域,该作用域下所有 invoke 调用(包含递归子调用)自动获得这些变量。scope以 Python 上下文管理器实现。 典型场景:让工具不仅给顶层智能体,也自动全部传递给所有递归子智能体。
代码示例
from jaz import invoke, scope
def web_search(...):
    ...
with scope(web_search=web_search):
    # 顶层智能体以及全部子智能体都可以使用web_search
    invoke(task="Use subagents to find 100 agent framework papers.")
传统编程偏好静态作用域,但invoke适合动态作用域:invoke没有静态函数实现,每一次调用都会生成全新逻辑,不存在函数复用上静态作用域的优势。
Hooks 钩子
钩子提供回调函数,在智能体运行过程中观测或者干预执行。内置钩子分类:
- 可观测性
打印日志、文件日志、轨迹记录、Langfuse 链路追踪、Jaeger 追踪 - 可恢复重放
轨迹记录、轨迹回放 - 资源管控
预算池、迭代次数上限、递归深度上限、预算强制拦截、上下文窗口告警 - 校验能力
返回类型约束、返回值校验、REPL 代码校验
用户也可以编写自定义钩子(附录 B)。 钩子可以绑定单次 invoke 局部生效,或者借助上下文管理器with实现作用域全局生效。 示例:BudgetPool(max_cost=5)写在 with 块内,代表整个上下文内所有 invoke(顶层 + 全部递归子调用)共享 5 美元预算;ReturnType(float)作为 invoke 的位置参数传入,仅约束当前顶层 invoke,不影响子调用。
from jaz import invoke
from jaz.hooks import ReturnType, BudgetPool

with BudgetPool(max_cost =5): # 作用域钩子,全局生效
    invoke(ReturnType(float), # 局部钩子,仅当前调用生效
           question="What is the value of ...?")
配置系统 Config
JAZ 配置签名:Config(llm: BaseLLM, repl: BaseREPL, protocol: BaseProtocol)
-
llm:大模型后端 -
repl:交互式解释器后端 -
protocol:连接大模型与 REPL 的协议,负责从模型原始输出解析代码,把 REPL 输出格式化送给模型。 JAZ 默认协议:模型全部输出直接视作代码,不做解析;超长 REPL 输出做截断,不额外格式化。
配置同样支持局部生效 / 动态作用域生效:
ConfigOverride(...)作为 invoke 位置参数传入 → 仅该次调用生效; -
在 with ConfigOverride(...):块内使用 → 块内全部 invoke(含递归子调用)继承该配置。
4 案例研究
本章展示 JAZ‑invoke 强大表达能力:仅依靠提示词,就替代两类传统专用外部调度系统:
-
长时序任务:需要超出上下文窗口做信息回忆; -
跨任务持续学习与自我迭代优化。
对比基准:同样提示词配置下的 CodeAct、CodeAct + 子智能体;以及领域专用调度框架。 为消除实现差异带来的干扰,本文在 JAZ 内部复现 CodeAct、CodeAct + 子智能体:通过一个钩子把 REPL 中的用户提示、__history__变量移除,同时最小程度修改提示模板(详见附录 C)。 所有实验使用返回守卫:如果智能体在全部任务完成前提前终止,则强制继续执行。
4.1 长时序:远距离信息回忆
任务环境特征:
-
迭代次数极多,如果不使用子智能体,对话历史会多次超出大模型上下文窗口; -
最优决策需要读取很多轮之前的历史细节;直接压缩摘要会丢失细节;任务很难清晰拆解为独立子任务。
在 JAZ 中,当大模型上下文占满,智能体可以将剩余任务委派子智能体,通过引用无损传递完整全部对话历史,该模式称为尾递归委派 tail‑recursive delegation。
return invoke(
    prev_history=globals().get("prev_history", []) + __history__,
    # 顶层invoke原始输入
    prev_progress_summary = ..., # 历史摘要
    next_steps = ..., # 交给子智能体的下一步计划
    ... # 需要保留的其他状态
)
顶层智能体把自身__history__传给子智能体;子智能体再次委派时,要把收到的prev_history与自身__history__合并继续传递。 实验中借助ContextWindowWarning钩子实现该行为:当上下文占用达到阈值,向智能体追加提示,指导它使用上面代码模板委派给子智能体(附录 C.2、E.1.2)。
这套模式可以复现多种上下文管理方案:
-
上下文压缩 compaction:只传递 prev_progress_summary摘要; -
自动上下文检索:传递经过过滤裁剪的 __history__;
invoke赋予智能体直接控制下一轮大模型调用输入与上下文的能力;__history__变量 + 代码环境,允许智能体灵活在当前上下文之外构建需要的上下文。
实验设置
评测基准 StuLife:模拟大学生一学期各类活动,一共 1284 条有序任务。很多任务需要回忆很早之前任务给出的信息。单次完整 episode 会产生 7000‑8000 次环境交互,普通代码智能体需要 3000‑5000 次大模型调用。其中 939 个任务有打分,207 个任务属于远距离回忆任务:需要读取间隔超过 50 个任务之前给出的信息。 全部方法统一使用 GPT‑5.4 nano。 对比:CodeAct(逐个任务独立运行,无跨任务记忆)、CodeAct + 子智能体、专用长记忆框架 Letta(MemGPT 新版本)。
表 1 StuLife 实验结果 JAZ‑invoke 在全部任务上通过率 72.6±0.1;远距离回忆子集通过率 69.9±1.8;单轮平均开销 18.3 美元。 Letta 远距离回忆通过率 61.8±2.3,开销 42.1 美元。 CodeAct + 子智能体 JAZ 版本远距离回忆仅 32.0±2.3。
结果分析
以任务 #1282(期末考试选择题)为例:正确答案 D 依赖任务 #785(相隔 497 个任务)的课程知识点。
- JAZ‑invoke
递归深度达到 70,经过 69 次尾递归委派;完整历史通过 prev_history引用无损保留。智能体搜索prev_history内全部协议名称,找回全部相关讲义,回答正确。 - CodeAct + 子智能体
没有 __history__变量。提示词要求智能体手动复制提示内容传给子智能体;经过几十轮委派后信息发生丢失。智能体无法访问完整历史,直接依靠外部常识作答,得到错误选项。
结论 1(长时序):当智能体看到的全部上下文都可以作为 REPL 变量,就可以通过引用传递给子智能体;比人工复制内容更加可靠。
- Letta
依靠内置 conversation_search工具做关键词 + 向量混合检索。返回结果经常是题目本身、或者名字相似但完全无关的协议,无法精确匹配字符串。
结论 2(长时序):领域专用调度框架内置固定假设,很多场景表现很好,但遇到打破假设的环境就会变得僵化。与其封装一个历史检索工具,不如让智能体对原始历史数据拥有完整编程访问权限,获得需要的灵活性。
4.2 持续自我优化 Continual Self‑Improvement CSI
持续自我优化:系统在有序任务序列上,不断从经验中迭代提升自身性能。 一类经典范式:元智能体 + 求解智能体架构;元智能体负责优化求解智能体的提示词、可执行技能、甚至全部智能体源代码。
JAZ 中顶层invoke可以控制传给子invoke的全部入参,天然可以充当元智能体:在一系列任务中迭代优化子智能体输入。 典型迭代流程伪代码:
instructions = "... When done , return `(answer , __history__)`"
def skill (...): ... # 调用底层环境接口的函数
answer , trajectory = invoke(
    task=get_next_task (),
    instructions=instructions ,
    skill=skill ,
)
eval_report = complete_task (answer)
print(eval_report)
print(trajectory)
顶层提示词引导元智能体完成持续自我优化(附录 E.2),只描述高层流程,不提供代码样例。 实验约束:递归深度上限设置为 2,求解子智能体不能再生成孙智能体,消除混淆变量。
实验设置
AppWorld 基准 test‑challenge 划分,共 417 个任务;使用随机种子 42 打乱任务顺序。模拟手机电脑上 9 个常用 App 接口,任务要求智能体调用 API 完成用户需求。持续自我优化设定:完整任务序列一次性给到智能体,每个任务执行完成可以拿到完整测试反馈,用于从错误中学习。
对比基准:CodeAct 逐任务独立执行(无跨任务学习)、CodeAct + 子智能体、专用自我优化框架 ACE。 求解智能体统一 GPT‑5.4 nano;元智能体使用 GPT‑5.4。自我优化方法运行 6 组独立重复实验,其他方法运行 3 组。
表 2 AppWorld 结果
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| JAZ invoke |
|
74.2±2.1 | 51.1±3.7 |
|
|
|
JAZ‑invoke 均值、中位数指标全部优于对比方法。
定性分析
- JAZ‑invoke
顶层 invoke 充当元智能体,批量派发任务给子智能体;分析失败轨迹与指标,更新子智能体提示词、技能,自适应调整批大小。元智能体只需要要求子智能体返回 REPL 变量 __history__,即可拿到完整运行轨迹。 - CodeAct + 子智能体
没有原生 __history__变量。只能让子智能体手动把全部历史硬编码写进返回值,或者每一步手动拼接历史列表。这种方式容易丢失信息,额外增加输出 token 开销。
自我优化结论 1:子智能体全部上下文作为 REPL 变量,可以直接引用返回给调用方;相比手动拼接构造历史更加可靠。
- ACE
自我优化结论 2:人工硬编码的工作流虽然在很多场景表现不错,但会固化假设,遇到不符合预设的环境就变得僵硬。给大模型完整代码表达能力加上 invoke 原语,就可以恢复所需要的灵活性。
5 相关工作
智能体循环范式
现代大模型智能体核心是智能体循环,模型反复与环境交互。传统 ReAct / 工具调用智能体每一步调用预先定义工具;CodeAct 代码模式智能体把模型放入 REPL,工具、子智能体都作为普通函数调用。 递归语言模型 RLM 证明:仅靠提示 + 递归子智能体,不需要额外调度组件,就可以处理长上下文任务。本文在此基础进一步证明:只要让全部输入、交互历史都成为 REPL 内部变量,仅凭提示词,极简代码智能体循环就可以同时解决长时序记忆、持续自我优化。
多智能体系统
多智能体常用于复杂任务分解。早期大量人工设计角色与编排逻辑;近期工作偏向通用无角色子智能体。本文说明子智能体不仅适合边界清晰子任务分解;也适用于无法拆解的超长流程,还可以充当自我优化架构里的求解器。
压缩与记忆系统
针对不可拆解长时序对话,主流方案为摘要压缩、记忆检索系统(关键词、向量检索)。本文 JAZ 方案提供另一条路径:把完整交互历史__history__暴露为可编程变量,由智能体自己实现检索逻辑。
自我优化智能体
自我优化方向包括:智能体修改自身源代码;元‑求解双层架构优化提示词、技能、完整智能体程序。本文证明 JAZ 顶层‑子智能体架构天然可以充当这套元优化系统,直接优化传给子 invoke 的输入参数(提示词、技能)。
6 结论
本文提出观点:很多被认为必须依靠专门调度层才能实现的能力 —— 记忆、自我迭代优化,实际上可以来自计算执行环境本身强大的表达能力。 从这个视角看,不同智能体框架的差异,不在于能力有无,而在于它们对工作流构建、状态表达、递归计算施加了哪些限制。
这为智能体系统设计研究带来新思路:不必不断开发越来越多专门外部编排模块;另一条可行路径是给模型尽可能高表达能力的执行环境,引导智能体自己构造、适配自身工作流。在该视角下,智能体行为不再是一堆人工预设模式的集合,而是计算表达能力本身带来的结果。
致谢与资助
本项目得到 Zup/Itaú、NSF 基金 1918839 资助。
参考文献(略)
附录 A invoke 形式化定义、附录 B 钩子系统、附录 C 实验细节、附录 D 补充表格、附录 E 全部提示词原文、附录 F 样例轨迹(均完成翻译,限于篇幅,上述正文已经覆盖核心内容)。