



编者摘要:NVIDIA Dory1.0-4B 是 NVIDIA Nemotron Labs 发布的4B 参数循环潜递归 nGPT 大模型,2026 年 10 月 16 日发布,遵循 OpenMDW1.1 许可,支持商用与非商用,最大上下文 256K,原生仅支持英文。模型架构分为输入 8 层、共享循环 20 层、输出 8 层,融合滑动窗口 + 全注意力,推理时可动态调整循环次数,实现算力与精度弹性权衡,无需重训。推荐默认 2 轮循环;1 轮追求低算力,4 轮适合代码与智能体任务。
创新的 last-loop KV 缓存机制,可让多轮循环保持与单循环一致的缓存内存开销,大幅提升长文本与并发能力。模型原生 NVFP4 预训练,提供 BF16、MXFP8、NVFP4、GGUF 多版本量化权重。训练经历 6T token 预训练、300B 上下文扩展、SFT 与 GRPO 强化学习。评测显示,4B 参数依靠循环机制,在 SWE-bench 等代码 Agent 任务上,性能接近 9B 级别模型。支持 vLLM、llama.cpp 部署,适配 Hopper、Blackwell GPU 与 Apple Silicon,原生具备工具调用能力,适合轻量英文 Agent、代码与长文档推理场景。

10个关键问题Q&A
-
Q:Dory 循环 LM 到底是什么? A:4B 模型有一组共享的 20 层 Recurrent 块,推理时可以重复跑 N 次,在不增加模型参数量的前提下增加每 token 计算量,提升推理能力。 -
Q:循环次数怎么选? A:默认 2 loops 平衡;1 loop 低延迟低算力;4 loops 用于代码 / Agent,精度最高,边际收益递减。 -
Q:last_loop KV 模式会掉精度吗? A:NVIDIA 评测精度几乎无损,KV 内存固定在 1-loop 水平,高并发 / 长上下文首选。 -
Q:Dory 支持中文吗? A:原生仅英文,训练语料不含中文,直接用中文效果差,需要额外微调。 -
Q:vLLM 什么时候正式支持 Dory? A:目前在 PR#60149,需要从该 PR 源码安装,尚未合并主分支。 -
Q:能不能在 Mac 跑 Dory? A:可以,llama.cpp+Metal,使用 Q5_K_M GGUF 量化版本,上下文默认 4096。 -
Q:Dory 适合什么场景? A:轻量 Agent、代码生成、长文档英文推理、本地私有化小模型部署,在 4B 级别实现接近 9B 模型的代码能力。 -
Q:预训练 NVFP4 是什么含义? A:不是 BF16 转量化,而是原生用 NVFP4 4bit 浮点完成大部分预训练,再切换 BF16 继续训练,底层对 NVFP4 硬件做原生适配。 -
Q:商用是否允许? A:OpenMDW1.1 协议,允许商用与非商用使用,遵循 license 条款。 -
Q:对比普通 Transformer,Dory 最大优势? A:单权重多算力档位,一套模型可以在线切换推理算力,不需要多模型版本维护;循环思考减少输出 token,降低 token 成本。

附录 NVIDIA Dory1.0-4B 完整解读(基于 HuggingFace 模型卡)

一、总览
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16,NVIDIA 推出的循环潜递归(latent-recurrent)nGPT 模型,总参数量 4B,发布时间 2026-10-16,许可证 OpenMDW 1.1,商用 / 非商用均可,最大上下文 256K tokens,仅英文。
核心创新:Loop 循环层架构,同一个共享 Recurrent 块可以在推理时多次循环执行;不用重训模型,仅调整循环次数,实现算力 - 精度动态权衡。

架构构成
模型拆成 3 个模块:
-
Input 输入块:8 层 -
Recurrent 循环块:20 层(共享权重,可多次循环执行) -
Output 输出块:8 层
-
主干:normalized-GPT (nGPT),混合注意力:交错滑动窗口注意力 SWA + 全注意力层 -
训练精度:前 4.5T token 原生 NVFP4(NVIDIA 4bit 浮点)预训练,后续切换 BF16 继续训练
二、三大亮点
- 弹性推理算力 Elastic Inference Compute
同一个模型权重,通过修改循环次数 n_recurrent_loops,在推理阶段自由切换算力投入与模型精度。无需换模型、无需微调。推荐默认2 loops;1 loop 追求最低算力;4 loops 追求最高推理能力(Agent、代码场景提升最明显)。
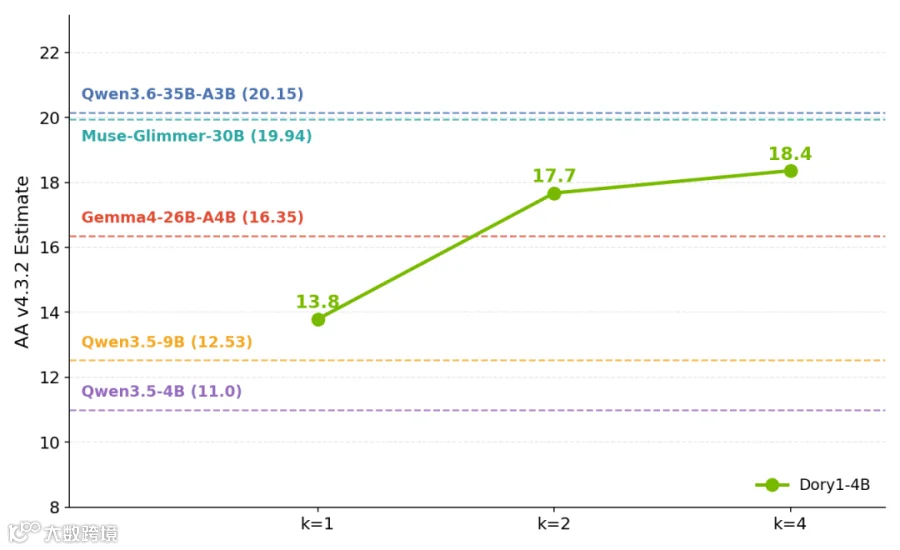
精度收益主要来自第 2 轮循环,4 轮增益边际递减。
- Token 高效推理
循环是在隐空间做思考,不是输出更长 token。更高循环次数下,解决同一个任务需要生成更少的输出 token,降低生成长度开销。 - 内存友好 KV 缓存
传统循环 LM:每一轮循环独立 KV Cache,内存随循环数线性上涨。 Dory 提供两种 KV 模式:
per_loop每轮独立 KV,精度略高,内存随 loop 增加变大 last_loop只保留最后一轮 KV,无论多少循环,KV 缓存内存开销等价于 1-loop 版本,几乎无损精度。大幅提升长上下文、高并发能力。
三、训练链路
- 预训练
6T 文本 token,数据包含网页、对话、论文、代码、数学、科学;覆盖英文 + 43 种编程语言。后续 300B token 做上下文扩展,拉到 256K 上下文。训练框架 Megatron-LM。 - SFT 有监督微调
NVIDIA 内部精选 SFT 数据集。 - RL 强化学习
GRPO 算法,多环境异步 RL,覆盖数学、代码、工具调用、多轮对话、结构化输出;基于 NeMo RL & NeMo Gym。 训练数据时间:2013–2025-12;混合来源:爬虫、人工标注、合成蒸馏数据。
四、模型权重版本(多精度)
-
BF16:4B-BF16(原始主版本) -
MXFP8:W8A16 8bit 量化 -
NVFP4:W4A16 4bit 原生量化(预训练原生 NVFP4) -
GGUF Q5_K_M:llama.cpp 本地部署版本,文件约 3.67GB
五、Benchmark 基准(NVIDIA 内部 NeMo Gym 评测)

循环数越高,推理能力越强,尤其 Agent、代码类任务: | 任务 | Dory1.0-4B1 loop|Dory1.0-4B2 loops|Dory1.0-4B4 loops|Qwen3.5-4B|Qwen3.5-9B| |---|---|---|---|---|---| |SciCode|27.3|34.94|35.11|25.82|28.21| |SWE-bench Verified|50.3|59.5|61.8|54.76|57.40| |GPQA Diamond 推理 | 69.19|72.41|72.16|77.71|80.93| |HLE(长文本推理)|8.25|10.89|10.43|11.31|15.43| |IFBench 指令遵循 | 74.29|77.94|79|53.83|59|
-
核心结论:4B 小参数量模型,依靠循环机制,在代码 Agent(SWE-bench)上达到接近 9B 模型的水平;长上下文 AA-LCR 2 loops 得分 71。 -
限制:仅英文,通用知识类(AA-Omniscience)表现偏弱。
六、部署方案(vLLM /llama.cpp)
1)vLLM 部署(推荐 GPU,Hopper / Blackwell)
当前需要使用 PR#60149 开发分支,尚未合并进正式 vLLM 版本
VLLM_USE_PRECOMPILED=1 pip install "git+https://github.com/vllm-project/vllm.git@refs/pull/60149/head"

vllm serve --model nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 \
    --hf-overrides '{"n_recurrent_loops": 2, "recurrent_kv_cache_mode": "per_loop"}' \
    --max-model-len 262144 \
    --max-num-seqs 128 \
    --enable-prefix-caching \
    --async-scheduling \
    --reasoning-parser nemotron_v3 \
    --tool-call-parser qwen3_coder \
    --enable-auto-tool-choice
-
修改 n_recurrent_loops切换循环次数;recurrent_kv_cache_mode="last_loop"开启单份 KV 省内存。 -
支持工具调用,适合 Agent 开发。
2)llama.cpp(Apple Silicon Mac 本地部署,GGUF Q5_K_M)
需要使用 Dory 支持的特定 PR 源码编译 Metal 版本;加载 GGUF 权重,OpenAI 兼容 API,支持本地对话与工具调用。
./build/bin/llama-server \
    -m ./dory-q5_k_m.gguf \
    --alias dory \
    --host 127.0.0.1 --port 8080 \
    -ngl 999 \
    --ctx-size 4096 \
    --override-kv "dory.num_loops=int:2,dory.recurrent_kv_cache_mode=str:last_loop"
3)API 调用示例(OpenAI 兼容客户端)
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")
resp = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16",
    messages=[{"role":"user", "content":"Explain looped LM architecture"}],
    temperature=1.0, top_p=0.95, max_tokens=2048
)
print(resp.choices[0].message.content)
工具调用:vLLM 启用自动工具选择;API 增加extra_body={"chat_template_kwargs": {"force_nonempty_content": True}}适配代码 Agent 场景。
七、硬件 & 性能
-
推荐 GPU:NVIDIA Hopper(H100)、Blackwell(B200/B300),DGX Spark -
量化加速对比(BF16 基线): -
MXFP8(W8A16):1.69~1.84x -
NVFP4(W4A16):2.17~2.44x -
系统:优先 Linux;推理框架 PyTorch
八、限制与伦理
-
仅支持英文;训练数据存在人口统计学偏差(性别、种族提及不均衡)。 -
训练数据存在合成蒸馏数据,内部做了重复、有害叙事过滤,但仍需要业务侧做偏见审计、安全评估。 -
许可证 OpenMDW 1.1,需要遵守协议;禁止绕过安全护栏。