




10 组关键问题问答 Q&A
- Q:Physical Atari 平台的研发目的是什么?
A:搭建一套便宜又耐用的实体机器人平台,用来研究直接在机器人本体上做实时强化学习,弥补缺少该类可复现实验平台的缺口。 - Q:Physical Atari 由哪几个核心部件组成?
A:Robotroller(驱动摇杆的机器人);Atari Devbox(运行雅达利游戏);普通 USB 摄像头;上位计算机;原版 Atari CX40 + 游戏手柄。 - Q:什么是实时强化学习,和普通回合制 RL 区别?
A:实时强化学习中环境会持续自行演化,不会等待智能体输出动作;传统仿真基准大多是回合制,环境等待智能体动作才更新状态。 - Q:Robotroller 做了哪些设计保障长时间运行不损坏?
A:全部运动位使用轴承;金属齿轮舵机 + 金属舵机摇臂;螺纹锁固胶;PID 参数平滑运动;自研过流反射保护机制。 - Q:Atari Devbox 为什么使用 AprilTag 标签?
A:4 个角标签帮助摄像头定位游戏画面;动态标签用视觉方式编码奖励,因为真实物理系统无法直接传输数字信号给智能体。 - Q:整套 Physical Atari 系统端到端响应延迟多少?
A:约 165 毫秒,和普通人反应时间接近,该时间不含神经网络推理耗时。 - Q:机器人强化学习存在哪三种主流实现路线?本文重点研究哪一种?
A:①仿真训练再部署;②人类采集轨迹离线学习;③直接在实体机器人学习;论文重点研究第三种。 - Q:论文最重要的实验发现是什么?
A:即使是同型号机器人,硬件之间微小物理差异带来分布偏移,也会让已经训练好的策略性能显著下降;在新硬件上继续学习可以恢复性能。 - Q:什么是 “过流反射保护”,起到什么作用?
A:高频监测舵机电流;一旦过流立刻短暂关闭扭矩。防止舵机堵转损坏硬件,避免舵机卡死需要人工重启。 - Q:这篇工作对机器人强化学习领域带来什么启示?
A:实物部署中微小分布偏移影响巨大,设备在线自适应非常关键;给机器人增加反射保护,更适合长时间强化学习交互实验。
作者:库拉姆・贾维德 ¹,约瑟夫・莫达伊尔 ¹・³,格洛丽亚・肯尼克尔 ¹,理查德・S・萨顿 ¹・²,约翰・卡马克 ¹ 邮箱:{kjaved,joseph,gloria,rssutton,johnc}@keenagi.com ¹ 基恩科技公司 ² 加拿大阿尔伯塔大学 ³ 开放心智研究院
摘要
我们搭建了一台名为 Robotroller(机器人操纵器)的机器人,它可以驱动雅达利 CX40 + 手柄;同时开发了一款名为 Atari Devbox(雅达利开发盒)的设备,能够在屏幕上渲染游戏画面,同时输出街机学习环境(Arcade Learning Environment,ALE)的奖励信号。Robotroller、Atari Devbox,搭配市售摄像头与台式计算机构成一套系统,可用于在真实物理世界开展强化学习算法研究,我们将整套系统命名为 Physical Atari。
本文详细阐述了使 Physical Atari 兼具稳健性与易用性的关键设计决策。为保障系统稳健,Robotroller 的全部运动机构均采用轴承结构,以此降低磨损;同时我们编写软件以高频监测舵机状态,并介入保护,限制应力。为实现平台易用,整套系统采用价格亲民的现成零部件,同时零件可使用消费级 3D 打印机加工。搭建一套 Physical Atari 的总成本低于 1000 美元,并且可以连续数周不间断运行强化学习实验,不会发生机械故障。我们利用该平台验证:强化学习算法可以直接在实体机器人上完成学习;同时发现,即便算法训练环境与部署环境之间仅存在微小的分布偏移,也会造成策略性能大幅下降。实验结果表明,想要让机器人获得优异性能,设备端自适应能力至关重要。
1 实时强化学习
强化学习智能体通过传感器感知环境信息,结合感知数据与自身内部状态做出决策,再通过执行器作用于环境,目标是最大化奖励获取速率。现有的强化学习基准测试大多将智能体与环境交互设计为回合制游戏(例如 Brockman 等人 2016;Bellemare、Naddaf、Bowling 2013;Beattie 等人 2016;Mahmood 等人 2018),这类环境会等待智能体输出动作之后才发生状态改变。 但物理现实世界与之不同:即便智能体正在做决策,环境状态也会持续演化。我们将这种环境持续演化的设定称为实时强化学习。实时强化学习并不是全新研究方向,Travnik 等人 (2018)、Ramstedt & Pal (2019) 均已对该场景开展研究。

实时强化学习场景带来独有的挑战。该场景下的智能体需要快速做出决策,缩小自身感知到的环境状态和真实环境状态之间的偏差;同时,智能体还需要针对不同决策分配不同的计算资源:当延迟代价很低时,可以审慎思考;当延迟会带来灾难性后果时,则必须快速响应。
实时强化学习的典型应用领域就是机器人。近些年,强化学习已经成为解决机器人领域难题的核心范式,主要分为三类实现思路: 第一种:构建机器人与环境的仿真环境,在仿真环境中用强化学习训练策略,再将训练好的策略部署到实体机器人(Abbeel 等人,2006;OpenAI 等人,2019)。 第二种:由人类操控机器人采集运动轨迹,利用离线强化学习算法基于轨迹学习策略,再部署至实体机器人(Mandlekar 等人,2018;Zhao 等人,2023)。 第三种:直接在实体机器人本体上进行学习(Benbrahim 等人,1992;Haarnoja 等人,2019;Smith 等人,2023;Wu 等人,2023)。
第三种方案有两大优势:既不需要仿真器,也不需要人类采集数据;同时训练环境和部署环境之间不存在分布偏移。本文的研究重点就是第三种方案。
目前,还没有同时兼顾可靠性与易用性的实验平台,支持直接在实体机器人上开展强化学习研究。为此我们开发了 Physical Atari,该平台易用、可靠、上手简单,通用性强。
-
易用:零部件价格低廉、容易采购; -
可靠:能够长时间开展实验,不出现机械损坏; -
上手简单:长时间运行过程中几乎不需要人工干预; -
通用性强:可以支持多种多样的任务。
Physical Atari 的两大核心硬件为 Robotroller 和 Atari Devbox。Robotroller 是一台机器人,可以驱动未做任何改装的商用雅达利 CX40 + 游戏手柄;Atari Devbox 搭载一块 5 英寸显示屏,用于渲染街机学习环境 ALE 的游戏画面与奖励信号。
我们选用 ALE 的游戏作为平台任务,因为学界已经充分理解强化学习算法在仿真环境下运行这些游戏的表现,ALE 也已经被大量经典强化学习工作所使用,例如 DQN (Mnih 等人,2015)、Rainbow DQN (Hessel 等人,2018)、MuZero (Schrittwieser 等人,2020)、数据高效版 Rainbow (Van Hasselt 等人,2019)、BBF (Schwarzer 等人,2023)。Physical Atari 将 ALE 基准测试的丰富任务迁移到物理世界,可用于研究仿真中常常被忽略的现实问题,例如时间延迟、环境非平稳性。
2 Physical Atari 平台
图 1 为 Physical Atari 整体架构。整套平台包含对准 Atari Devbox 屏幕的摄像头、与摄像头相连的计算机、连接计算机的 Robotroller,以及接入 Atari Devbox 的 CX40 + 手柄。

计算机以摄像头作为传感器,向 Robotroller 发送 ALE 定义的 18 种离散动作之一;Robotroller 驱动舵机运动到预设位置,完成动作执行。
摄像头选用雷蛇奇影 Pro(Razer Kiyo Pro)市售摄像头,输出无压缩视频流,以此降低延迟,通过 USB3.1 接口连接计算机。本文实验使用 Framework 台式主机,搭载 AMD Ryzen AI Max+ 395 芯片;其他支持 USB3.1 的计算机同样可以工作。

2.1 Robotroller(机器人操纵器)
Robotroller 包含两类零件:第一类是使用欧特克 Fusion CAD 软件设计的定制零件,可使用消费级 3D 打印机(如拓竹 P1S)搭配普通 PLA 耗材打印成型;第二类是直接外购的标准件,包括螺丝、轴承、舵机、螺纹嵌件以及电子元器件。
Robotroller 设计的核心目标:长时间连续运行,磨损尽可能小。为此,全部运动位置都采用市面容易买到的 608ZZ 滚珠轴承。滚珠轴承降低摩擦,缓解 3D 打印 PLA 塑料件容易磨损的问题。为了把舵机扭矩通过轴承传递到游戏操纵杆,我们把控制摇杆的两个舵机布置为旋转轴线交汇于摇杆支点。
测试过程中我们发现长时间运行螺丝会松动,装配时使用乐泰 243 螺纹锁固胶解决该问题。
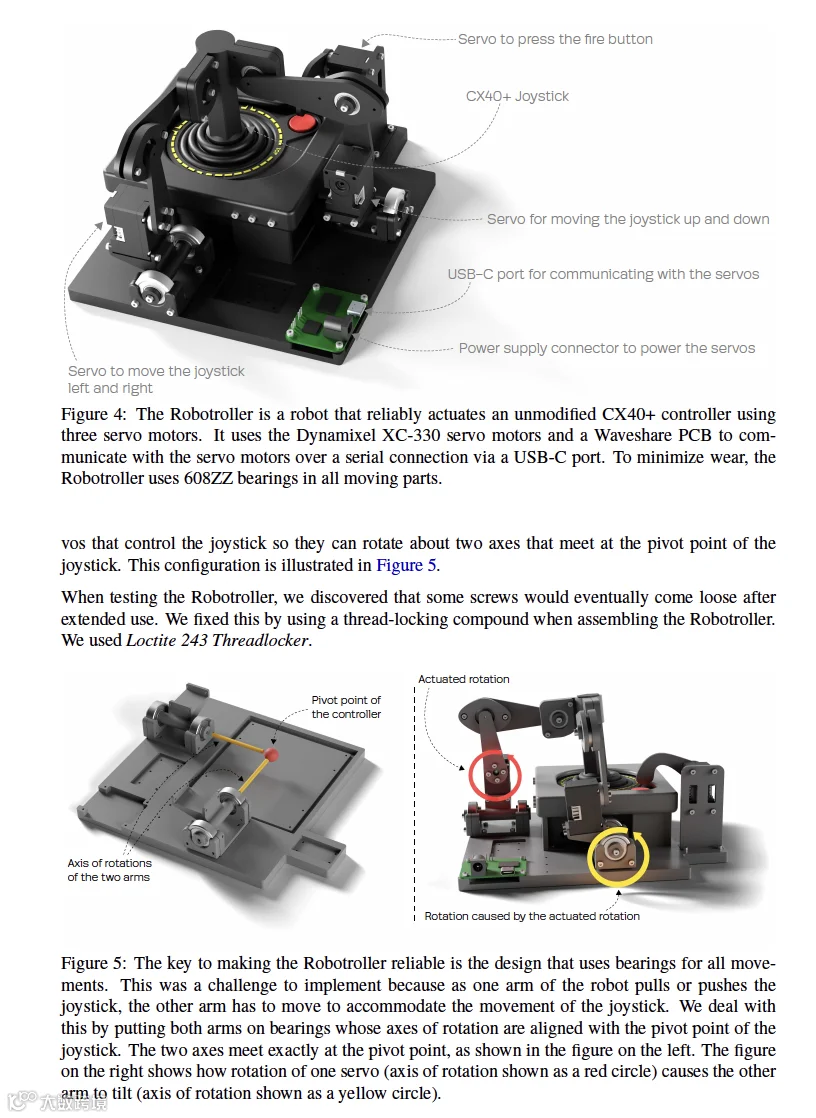
早期原型选用价格更低的 Dynamixel XL‑330 舵机,齿轮为工程塑料材质,长时间连续运行齿轮会磨损。后续替换为金属齿轮的 Dynamixel XC‑330 舵机。经过数周不间断测试,金属齿轮没有出现磨损迹象。 XC‑330 舵机的输出摇臂为工程塑料材质,实验中出现断裂。我们全部替换为 Dynamixel 的金属替换件 HNX330‑N101,解决断裂故障。
硬件机械结构可靠性完成之后,我们发现 CX40 + 手柄长时间工作会发生损耗。人类使用手柄并不会出现该问题,排查发现 Robotroller 原始运动曲线过于剧烈,对手柄施加了不必要的应力。
舵机采用 PID 位置闭环控制,预先设定位置目标点,接收到指令后舵机运动到对应位置,以此触发 ALE 的 18 种动作。Dynamixel 舵机出厂默认参数 P 增益很大,I、D 增益为 0。高 P 增益带来抖动运动,给手柄带来巨大应力。
我们重新调参:使用较小 P 增益、较小 D 增益,较大 I 增益,使舵机运动更加平滑,精确参数见附录 E。 但是调高 I 增益带来新问题:如果舵机无法快速到达目标位置,积分项会造成电流急剧飙升,舵机会锁死,需要手动重启。 对此我们设计过流反射保护机制(high‑current reflex):高频循环读取舵机电流;一旦电流超过阈值,就把舵机目标位置设置为当前实际位置,同时关闭扭矩 1 毫秒。这套预编程保护逻辑,避免舵机损坏、避免进入必须手动重启的故障状态,其设计灵感来自人体的肌腱反射保护机制。
完成 PID 调参与过流反射保护之后,Robotroller 搭配同一个 CX40 + 手柄连续运行数周,没有明显磨损,功能完好。Robotroller 更多细节见附录 B,完整搭建教程可以参阅项目链接。
2.2 Atari Devbox(雅达利开发盒)
Atari Devbox 是一台紧凑型设备,计算单元为树莓派 5,搭配 5 寸 Waveshare 显示屏;外壳使用欧特克 Fusion 设计,3D 打印成型。树莓派 5 原生没有 DB9 接口,我们把 DB9 公头直接焊接到树莓派 GPIO 引脚,对外暴露在机箱外侧。
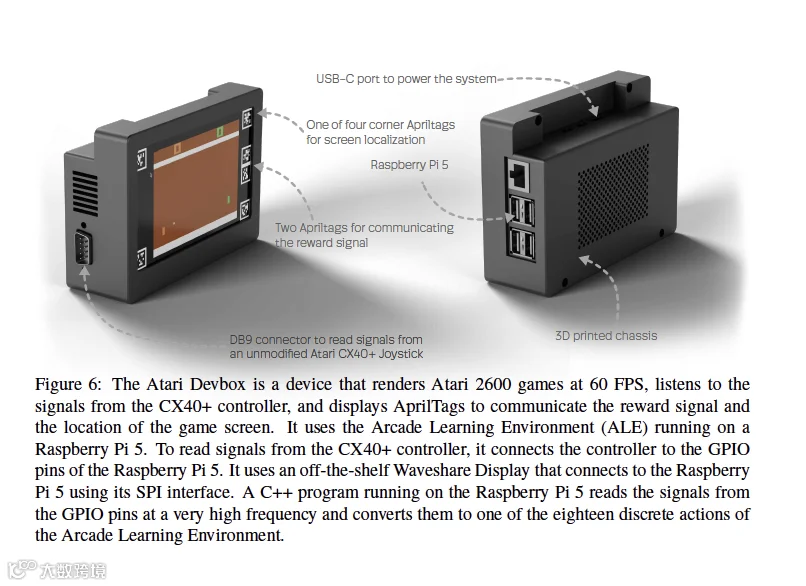
我们编写程序,亚毫秒级延迟读取 GPIO 引脚电平,将 CX40 + 手柄 5 路信号线(上、下、左、右、开火)的状态映射为 ALE 环境定义的 18 个离散动作。程序将动作送入 ALE 仿真,以 60 帧每秒把游戏画面输出到屏幕。
除游戏画面之外,屏幕还会渲染 AprilTag 视觉标记:屏幕四角 4 个标记,帮助智能体从摄像头图像定位游戏画面;屏幕侧边一组动态标记,用来对奖励信号做视觉编码。 Atari Devbox 完整搭建教程见项目链接,更多技术细节见附录 A。
3 Physical Atari 系统响应时间特性表征
物理系统从接收刺激到做出响应存在固有延迟:画面渲染、摄像头采集图像、图像处理、机械执行动作,每一步都会消耗时间。
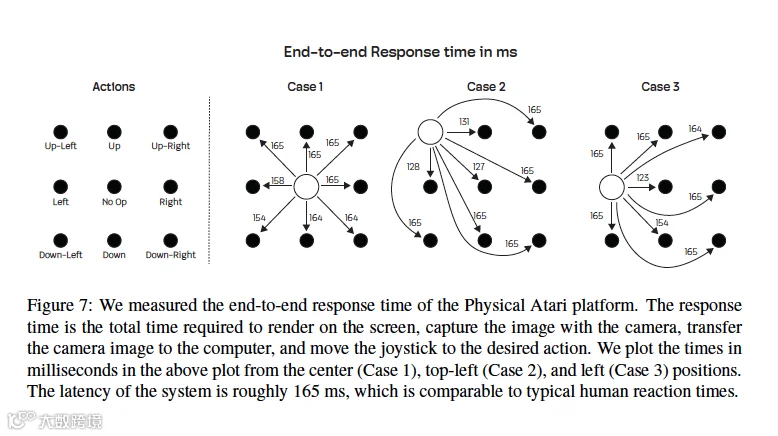
我们开发一套标定工具,用来测量整套系统的端到端响应时间。工具在屏幕输出 ID 从 0‑17 的 AprilTag 标记,每输出一个标记就启动高精度计时器,代表向系统下达指定动作。机器人通过摄像头识别标记,驱动摇杆执行对应动作;工具监测手柄接线的电信号,一旦检测到动作被物理执行,立刻停止计时器。
这套测量覆盖画面渲染、摄像头采集、图像传输处理、机械驱动全部环节。多次实验(每组 30 次取平均)得到系统整体响应时间大约165 毫秒,和人类典型反应时间处于同一量级;该数值尚未包含深度神经网络选择动作的计算耗时。
4 实验设置:网络架构与学习算法
Physical Atari 平台上,我们采用 Travnik 等人(2018)提出的反应式强化学习框架实现深度强化学习算法。在该框架中:智能体完成动作选择之后立刻向环境发送动作;学习更新发生在动作发送完成之后,下一轮观测获取之前。
智能体使用全卷积网络,逐步对视觉输入降采样。摄像头获取的每一帧图像缩放至 128×128×3,做指数移动平均平滑处理之后送入网络;对平滑后的观测做归一化,减去像素均值,再除以像素标准差。
经过一系列 3×3 卷积层;除最后一层卷积外,每一层卷积之后执行步长为 2 的 3×3 最大池化,再送入 ReLU 激活。不断降采样直到特征图空间尺寸达到 2×2;最后使用线性层映射输出标量价值。第一层卷积使用 24 个卷积核,每经过一层卷积,卷积核数量翻倍。

本网络架构的一个关键特点:动作历史信息晚融合。智能体把近期动作编码成向量,使用指数移动平均对历史控制行为做汇总,得到近期动作的紧凑表征。
针对雅达利游戏,动作采用分解式二进制编码:将动作拆分为垂直运动、水平运动、开火按键三部分。前 3 比特编码垂直,接下来 3 比特编码水平,最后 2 比特标记开火按钮是否按下。 示例:向上 UP 编码为[1,0,0, 0,1,0, 1,0]:向上、无水平移动、不开火;右上 UPRIGHT 编码[1,0,0, 0,0,1, 1,0]:保持向上,水平切换为向右,不开火。
动作历史向量在第一级卷积结束、第二级卷积开始之前,和视觉特征做融合。动作向量的每一个元素复制到特征图全部空间位置,为每一个动作分量生成一张常数特征图;沿着通道维度,把这些特征图和视觉特征图拼接。
该设计让每一个卷积滤波器,都可以在所有空间位置参考近期动作的汇总信息。和 DQN 系列网络不同:DQN 网络输出每个动作的价值;而本网络把历史动作作为网络输入。价值估计同时基于经过时序平滑的视觉观测,以及近期动作序列。
训练目标使用 n 步回报(Sutton,1988;Sutton & Barto,2018)。行为策略采用固定 ε 的 ε‑贪心策略。智能体维护独立目标网络:选动作时用目标网络做评估,计算 n 步回报的自举目标;每隔固定步数,直接把在线网络参数复制覆盖目标网络。
智能体从回放缓冲区存储的历史样本学习。采样时,一个 batch 里面保留一部分样本取自最近的在线交互数据,剩余样本从回放池随机采样,该改进的有效性在 Zhang & Sutton (2017) 的工作中得到验证。
网络参数更新最小化网络预测值和多步回报目标之间的均方误差。卷积层参数使用 AdamW 优化器;最后线性层使用带动量的 SGD 优化器。实验超参数完整见附录 D,代码可以查阅项目链接。
性能评价指标采用全部历史交互的平均奖励。记第 i 时间步奖励为\(r_i\),截至 t 时刻平均奖励:
\(\frac{1}{t}\sum_{i=1}^t r_i\) 我们不使用回合回报作为评价指标,对于持续型强化学习任务,平均奖励是更合适的指标(Naik & Sutton,2019)。

5 实验结果
我们开展两组实验,测试 Physical Atari 平台性能。第一组验证现有强化学习算法能否在平台稳定学习,无机械故障、无需人工干预。第二组测试:在一台 Robotroller 上训练出来的策略,迁移到另一台物理硬件上的表现。
5.1 Physical Atari 可以连续数周不间断学习,无机械故障
我们让智能体学习 6 款雅达利游戏:Pong、Seaquest、MsPacman、Assault、Asterix、Kangaroo。每局游戏训练 5.5 小时;每款游戏重复至少 4 次实验。
智能体在全部 6 个游戏上均实现有效学习,多次重复实验性能结果稳定。全部实验累计运行约 145 小时,全程不需要人工干预。系统运行视频参见项目链接。
5.2 Physical Atari 中微小分布偏移即可造成性能严重下降
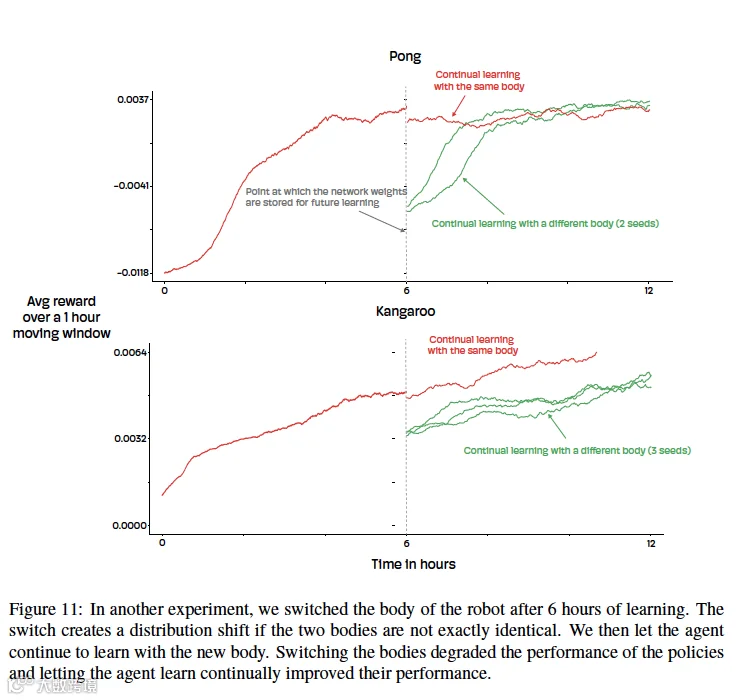
Physical Atari 平台适合研究机器人领域经典问题:不同机器人本体之间微小物理差异如何影响策略性能。 我们先让智能体在 6 款游戏训练 6 小时,保存训练完成的策略。之后做两组评估:一组使用训练时所用的 Robotroller 与手柄;另一组换一套完全相同型号但是不同实体的 Robotroller 与手柄。
结果显示:全部游戏场景中,部署到另一台机器人本体之后,策略性能均出现明显下滑。对于对时序精度要求高的游戏,性能衰减尤为突出。例如 Pong 游戏中,策略可以控制挡板朝着球的方向运动,但是总是差一点点接不到球。Pong 游戏里,极其微小的时序偏差就足以摧毁性能。
这说明:即便训练环境和部署环境之间只存在非常微小、不可避免的硬件物理差异带来的分布偏移,也会显著损害智能体能力。
我们额外选取两款游戏做补充实验:把训练好的策略迁移到另一台硬件本体之后,继续在新硬件上执行学习自适应。实验证明,在新本体上持续学习,能够恢复、提升策略性能。

6 结论与未来工作
据我们所知,Physical Atari 是首个同时兼顾低成本、高耐用度的机器人实验平台,可以连续数周运行实验而无需人工介入。
该平台一个极具价值的用途:系统对比机器人强化学习三大范式:仿真训练、人类演示数据学习、机器人本体直接学习。我们实验证实,仅仅机器人本体之间细微不一致带来的分布偏移,就会带来显著性能损失;仿真到真实世界的迁移往往会带来更大分布偏差。后续可以研究:仿真环境训练上亿帧得到的策略,迁移到 Physical Atari 物理系统性能如何;同样可以对比少量人类演示数据学到的策略和纯交互经验学习策略的表现。
过流反射保护机制是本工作另一个有价值的成果,可以为更多面向实时强化学习的机器人平台提供设计思路。给现有机器人平台增加反射保护机制,避免强化学习智能体在交互过程中损坏硬件,将可以极大提升机器人平台面向实时强化学习任务的适配能力。
致谢
感谢 Sorina Lupu、Lucas Nestler 提供反馈与讨论;感谢 RLC 会议审稿人和元审稿人的宝贵意见。
参考文献(略)
附录
附录 A‑E 为补充技术文档
附录 A Atari Devbox 技术细节
Atari Devbox 作为物理世界和雅达利仿真环境之间的接口,硬件全部选用市售组件,追求低延迟、高可靠性、可复现。注意:学习智能体代码并不运行在 Atari Devbox 上。
A.1 软件架构
核心程序是运行在树莓派 5 Debian12 系统下的 C++ 应用程序。整合多个库保障高性能:ALE 库完成雅达利 2600 仿真;SDL2 实现高性能 2D 画面渲染,输出游戏画面与 AprilTag 标记;libgpiod高速 C++ 接口读取 GPIO 引脚,实现最小输入延迟;Dear ImGui 用于调试图层。主循环以 60Hz 运行,和游戏仿真同步。每一轮循环读取 GPIO 引脚,步进 ALE 环境,渲染新画面与辅助标记。GPIO 引脚读取操作放在向 ALE 模拟器发送动作之前,保证获取最新手柄动作。
A.2 GPIO 接口与动作映射
CX40 + 手柄 5 根信号线接入 DB9 母座,我们将信号线连接树莓派 GPIO 引脚,启用内部上拉电阻;按键按下对应引脚被拉到地(逻辑 0)。原始 GPIO 电平状态映射为 ALE 定义的 18 个离散动作。例如同时检测到 Up(引脚 17)和 Right(引脚 24)被触发,则向模拟器发送PLAYER_A_UPRIGHT动作,物理手柄可以完整访问雅达利 2600 全部动作空间。
表 1 CX40 + 手柄 GPIO 引脚映射(BCM 编号)
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
A.3 视觉界面与奖励通信
智能体完全依靠摄像头视觉感知环境与奖励信号。Atari Devbox 输出复合画面,包含游戏画面和 AprilTag 标记。屏幕四角 4 个静态 AprilTag(ID0‑3),智能体可以计算单应矩阵,裁剪提取游戏画面,不需要严格固定摄像头位置角度。
奖励信号完全依靠视觉编码。屏幕右侧放置两枚动态 AprilTag:上方数值标记 ID10 代表奖励 0,ID11 代表 + 1,ID12 代表‑1;下方变化指示标记,每当出现非零奖励就循环切换 ID15、16、17;奖励为 0 时保持不变。这套状态切换机制,保证即使奖励信号高频连续出现,智能体也可以准确统计奖励事件。
附录 B C++ 输入输出库
为实现 Robotroller 高性能控制,我们开发一套 C++ 库并提供 Python 绑定接口。统一封装摄像头采集、机器人控制、环境交互。
B.1 核心模块
库包含三大协同模块:
-
视频采集模块:独立线程读取摄像头,保证随时可以拿到最新帧,最小化延迟;支持对焦、曝光等参数配置。 -
Dynamixel 舵机接口模块:将 18 种雅达利离散动作映射到舵机位置;使用舵机内置 PID 控制器,集成电流监测安全机制。 -
AprilTag 识别模块:解析摄像头画面标记,完成图像校正裁剪游戏画面,同时解析视觉编码的奖励信号。
B.2 环境接口
库把组件封装成统一环境对象,对外提供send_action()发送动作、perceive()感知观测两个 API。send_action()向 Robotroller 下发指令驱动舵机;perceive()读取最新摄像头帧,识别标记,校正图像、解析奖励。硬件底层细节全部被封装,强化学习智能体只需要调用简单 API 即可和 Physical Atari 交互。
B.3 过流反射保护逻辑
为保障长时间运行可靠性,舵机控制循环内实现实时安全反射,处理过流(代表舵机堵转或者撞击限位),避免舵机锁死必须手动重启。伪代码逻辑:
for (auto servo : list_of_servos) {
    int16_t cur = servo->getPresentCurrent();
    if (std::abs(cur) > 1200) {
        // 将目标位置设置为舵机当前实际位置,停止运动
        servo->setPosition(servo->getPresentPosition());
        // 短暂关闭扭矩释放机械应力
        servo->disableTorque();
        std::this_thread::sleep_for(std::chrono::milliseconds(1));
        servo->enableTorque();
    }
}
当电流绝对值超过 1200 毫安,就执行保护逻辑。
附录 C 实验框架
为实现可复现实验,我们在 Framework 主机上开发统一 Python 实验框架。协调智能体和物理环境交互、日志记录、实验配置;通过 Python 绑定调用附录 B 的 C++ 底层库。
C.1 训练循环
训练循环设计目标:降低延迟、时序稳定。每一轮迭代流程:
-
调用 env.perceive(),从摄像头与标记识别更新智能体状态,获取最新观测、奖励; -
传入观测调用智能体 get_action()选择下一步动作; -
立刻调用 env.send_action(action)执行动作; -
调用智能体 learn(),基于该条交互样本更新策略。
C.2 日志与可复现性
框架自动将完整实验数据存入 MongoDB 数据库。超参数、随机种子、环境配置全部随结果存储。实时记录平均奖励、回合得分等训练指标。模型权重、优化器状态通过 GridFS 序列化保存,支持实验断点续跑、事后数据分析。框架代码见项目链接。
附录 D 实验超参数
表 2 实验所用超参数,所有游戏共用同一套超参
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
参数说明:输入图像缩放至 128×128;观测做指数移动平均平滑降噪,平滑系数\(2^{-3}\);动作历史也做 EMA 平滑,系数 0.875;动作采用分解二进制编码,不用独热编码。 使用 n=12 步回报,每帧折扣 γ=0.99;每 4 帧做一次参数更新,batch 大小 16。每个 batch 强制拿出 4 个样本取自最近交互,其余样本从回放池随机采样。 卷积层 AdamW 学习率\(2^{-14}\);最后线性层带动量 SGD,学习率\(2^{-17}\)。每 32 帧硬拷贝更新目标网络。ε‑贪心策略,固定\(\varepsilon=2^{-6}\),每 2 帧选择一次新动作。
附录 E Robotroller 与摄像头硬件参数
E.1 摄像头配置
摄像头全部手动设置对焦曝光,关闭自动模式,避免画面动态偏移。采集分辨率 1280×720。
表 3 摄像头参数
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
E.2 Robotroller 舵机配置
串口波特率 1 000 000;舵机 PID 控制参数如下表。舵机编码器数值范围 0‑4095;2048 为摇杆中位。
表 4 Robotroller 舵机配置参数
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|