


10 个关键问题 Q&A
Q1:PEAR 是哪个团队提出的,应用在什么业务? A1:字节 Global E-Commerce Agentic Search 团队,落地于 TikTok 电商搜索。
Q2:PEAR 属于哪一类技术框架? A2:面向工业搜推在线系统,渐进式证据驱动 AutoResearch,属于 RSI 递归自我改进框架。
Q3:传统 AutoResearch 最大缺陷是什么? A3:简单以指标高低筛选策略,忽略流量非平稳性,易误判波动收益;实验仅保存分数,无法沉淀研究认知。
Q4:PEAR 的核心贡献是不是新的大模型 Agent? A4:不是。核心是构建 MLE-RSI 的 rollout 与评估工程框架,对齐离线环境和真实线上系统。
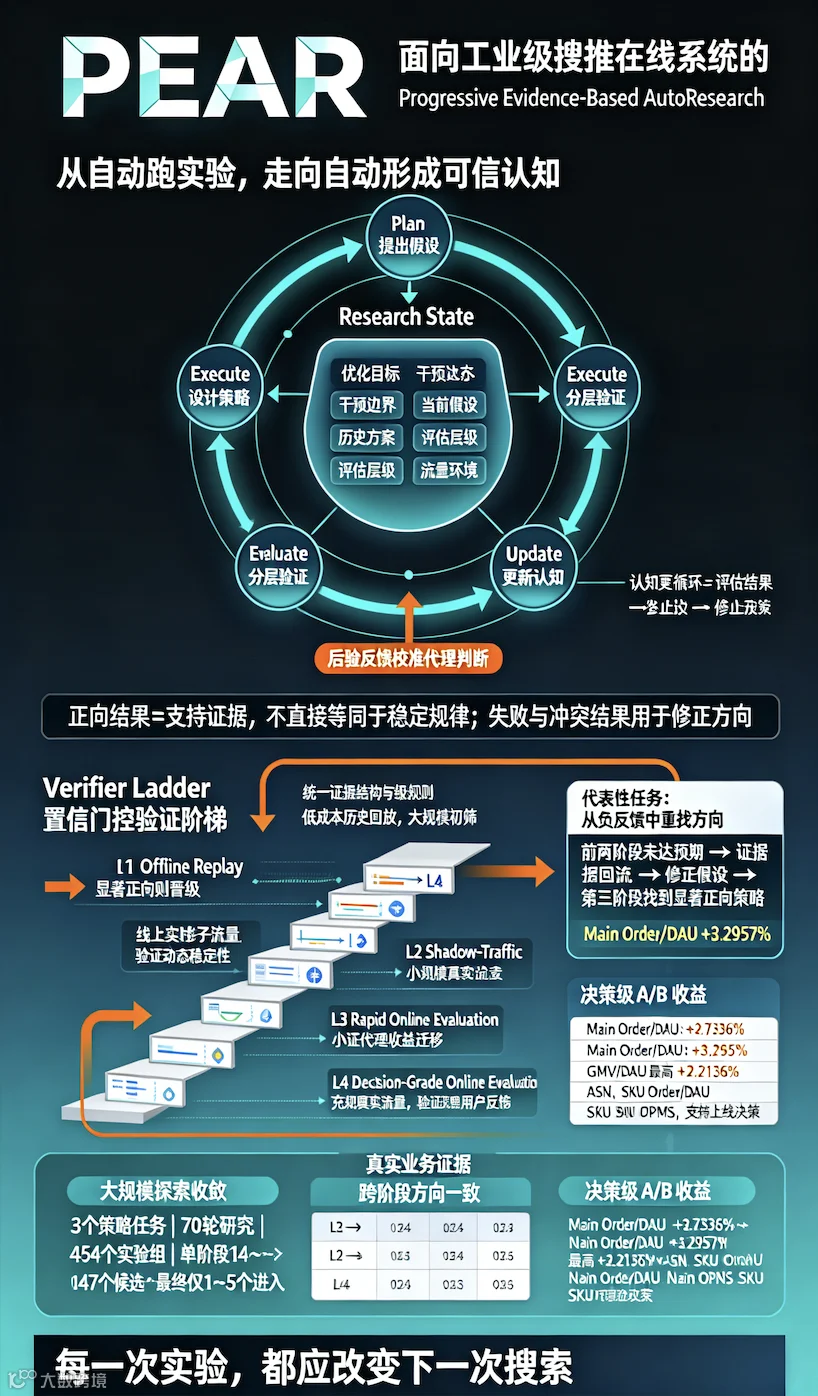
Q5:PEAR 的四级验证阶梯 L1-L4 分别是什么? A5:L1 离线回放;L2 影子流量评估;L3 小规模快速线上评估;L4 决策级正式 A/B 实验。
Q6:四级验证是把所有指标合并成一个总分吗? A6:不是。每层独立基线、独立评估信号,统一的是证据结构与置信晋级门控。
Q7:PEAR 如何处理实验失败的结果? A7:失败结果作为证据回流,回溯定位代理偏差与假设适用边界,淘汰无效分支,开辟新探索空间。
Q8:PEAR 的两个闭环是什么? A8:策略验证循环(候选逐级晋级)、认知更新循环(证据回流持续修正假设)。
Q9:论文核心业务指标收益是多少? A9:Main Order/DAU 最高提升 3.2957%,GMV/DAU 最高提升 2.2136%。
Q10:PEAR 后续的演进目标是什么? A10:提升高维空间探索效率,拓展到模型训练、架构优化,构建通用工业级 RSI 框架。
附录 PEAR :字节 TikTok 电商搜索,RSI/Agentic AutoResearch)
论文全称:PEAR: Progressive Evidence-Based AutoResearch for Industrial Search Systems团队:ByteDance Global E-Commerce Agentic Search Team arxiv:https://arxiv.org/abs/2609.35031 核心定位:面向工业搜推在线系统的渐进式证据驱动 AutoResearch(属于 RSI 递归自我改进框架)
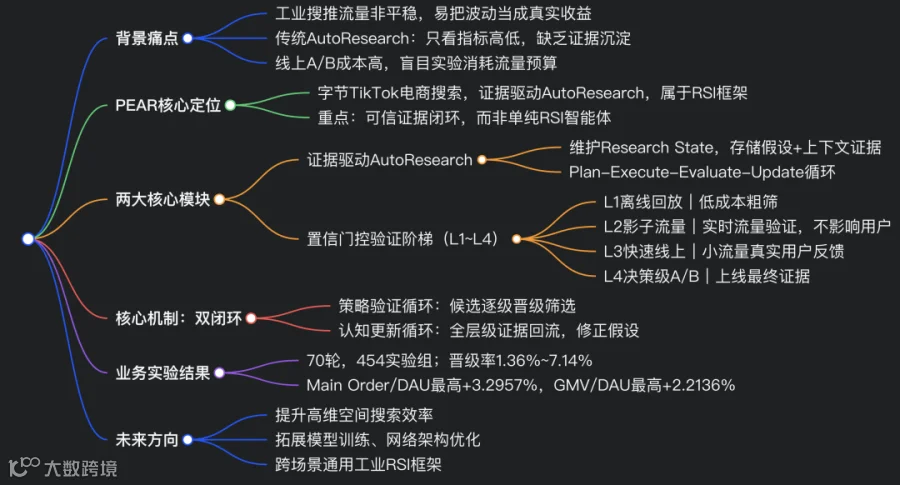
一、背景痛点:传统搜推迭代与旧 AutoResearch 的问题
工业搜索迭代链路:假设→策略开发→离线评估→小流量→A/B 上线。 业务痛点:流量非平稳、变量高度耦合,指标涨 ≠ 真实稳定收益,很容易把流量波动当成有效优化。
现有 AutoResearch 框架通病:
-
简单 “指标高就保留”,默认不同实验分数可直接对比,忽略流量分布随时间变化; -
离线回放、影子流量、真实线上 A/B,三者成本、目标、统计可信度不一样,不能等价; -
只记录指标分数,不记录假设、上下文、失败归因,实验记录没法沉淀成知识,Agent 反复试重复方向; -
线上流量昂贵,盲目大量跑 A/B 会消耗预算、带来业务风险。
一句话概括:旧 AutoResearch 只做到自动跑更多实验,PEAR 目标是自动形成可信认知。
二、PEAR 贡献
不是单纯提出一个 RSI 智能体,而是构建一套MLE-RSI 完整 rollout+evaluation 工程框架:
-
对齐离线环境与真实在线系统; -
分层递进评估,证据强度逐级升高; -
实验结果回流,持续修正假设,而不是只挑最高分策略; 平衡探索广度、线上风险、决策可信度,解决工业搜推场景下 RSI 落地难题。
三、整体架构:两大模块 + 双层闭环
PEAR 由 Evidence-driven AutoResearch(证据驱动自动研究)+ Confidence-Gated Verifier Ladder(置信门控验证阶梯)组成,形成两大循环:策略验证循环 + 认知更新循环
模块 1:Evidence-driven AutoResearch 证据驱动自动研究
核心:维护Research State 研究状态,把实验从 “存分数” 升级为存储带上下文的假设证据
-
Research State:每个优化任务独立保存优化目标、干预边界、研究假设、历史方案、每轮实验对应的评估层级 / 流量环境。 -
正向结果:仅作为支持该假设的证据,不直接认定是稳定收益; -
负向 / 冲突结果:同样保留,用于定位适用边界、淘汰无效分支。 -
Strategy Evolution(策略进化):Plan→Execute→Evaluate→Update 循环 Agent 基于已有证据生成候选策略,运行评估,判断结果是支持 / 反驳 / 不确定假设;据此决定:继续复验、调整探索方向、终止无效分支。 优势:防止单次偶然高分把整个搜索带偏。
模块 2:Verifier Ladder 置信门控四级验证阶梯(核心创新)
策略从低成本大规模筛选,逐级晋级到高成本真实流量验证,每一层都有置信度门控:显著正向晋级,证据不足继续观察,显著负向直接停止。
-
L1 离线回放 Offline Replay:历史请求回放,代理模型打分,低成本大规模粗筛候选; -
L2 影子流量 Shadow-Traffic Evaluation:复制线上实时请求,策略并行运行但不对用户生效,检验动态流量下稳定性; -
L3 快速线上评估 Rapid Online Evaluation:小规模真实随机流量,短期观测,验证代理收益能否迁移真实用户; -
L4 决策级线上评估 Decision-Grade Online Evaluation:完整正式 A/B,充足流量 + 长周期,作为上线最终证据。
关键:不是合并成一个总分,每一层独立基线、独立信号;统一的是证据结构与晋级规则。
证据回流(认知更新循环)
每一层的评估结论全部回流写入 Research State。 如果策略在 L1/L2 表现很好,但 L4 线上失败:PEAR 不只标记 “失败”,还会回溯:代理评估是否存在偏差?原假设适用条件是什么? 基于这个反馈校准后续 Agent 的策略生成空间,砍掉无效分支,开辟新探索方向。
四、TikTok 电商搜索业务实验结果
-
规模:3 个搜索策略优化任务,70 轮研究,454 个实验组;单阶段候选 14~147 个,仅 1~5 个进入线上验证,晋级率 1.36%~7.14%,大幅节约珍贵线上流量。 -
典型案例:前两阶段线上无正向收益,证据回流修正假设后,第三阶段找到有效策略,Main Order/DAU +3.2957% -
决策级 L4 A/B 收益: -
Main Order/DAU:+2.7336% -
Main Order/DAU:+3.2957% -
GMV/DAU 最高提升 2.2136% ASN、SKU Order/DAU、Main OPMS、SKU OPMS 同步显著改善 -
跨阶段一致性:晋级候选在 L2→L3→L4 持续正向,证明低成本代理信号具备迁移价值。
五、未来方向
-
提升高维复杂搜索空间内策略探索效率; -
从策略调参扩展到模型训练、网络架构优化; -
跨业务场景通用化,形成通用工业级 RSI 框架。
六、一句话对比理解
普通 AutoResearch:批量生成策略 → 跑实验 → 取指标最高的方案上线。 PEAR:提出假设 → 分层逐级验证证据 → 无论成功失败,把信息回流更新研究认知 → 引导下一轮策略探索;实验的价值不止选出一个好策略,而是持续学到业务规律