

本地跑大模型一直是发烧友的玩具,但硬件组合的玩法正在改变这件事:不同芯片各管一段、按任务选模型,成本和能力可以同时逼近云端。
这期节目里,主持人用一台约八百美元的 M4 Mac mini 加一张一千二百美元的 RTX 3090,再配一个外置显卡盒,总花费约两千五百美元,跑出了综合排名大约第二十、与 Opus 4.8 low reasoning 打平的开源模型,解码每秒三十个 token,每小时成本只要四美分;他觉得这事太疯狂了。在另一套 DGX Spark 配置上,单会话则能跑到每秒三百个输出 token。
本期来自 0xSero,主持人在节目中实测了多套本地 AI 硬件和开源模型的推理速度,从单卡到双机混合部署,再到数据中心级别的专用芯片。他的主要观点包括:
两千五百美元硬件能跑出开源前二十的模型。 一台约八百美元的 M4 Mac mini(16G 内存)加一张一千二百美元的 RTX 3090,配上外置显卡盒 Chestnut,总共约两千五百美元,能以每秒约三十个输出 token 的速度跑一个综合排名约第二十的开放权重模型。
这台机器上的模型与 Opus 4.8 low reasoning 打平。 该模型在 Artificial Analysis 指数上与 Opus 4.8 low reasoning 得分一样。让它在本地跑起来,意味着个人也能用上接近前沿水平的智能,而不必依赖 API。
并发会话越多,吞吐量越高。 单个会话最高每秒三百个输出 token,八个并发会话约每秒一千个,十六个约一千五百个,而且在 OpenCode 上还是免费的。
DGX Spark 比 RTX Pro 6000 便宜约百分之八十。 两台英伟达 DGX Spark 这种低功耗本地 AI 设备,大概能跑到每秒一百个 token,八个会话约三百,价格却比 RTX Pro 6000 低约八成。
Spark 解码慢,是因为 LPDDR 内存带宽只有 273GB/s。 每台 Spark 有 128G 内存,带宽每秒 273GB,而模型很大、要读的数据非常多,所以解码速度被内存带宽拖住;相比之下 M3 Ultra 带宽是每秒 812GB,快了三倍多。
预填充和解码可以用不同硬件分别优化。 本地层面已经出现 CPU offloading:有人用 DGX Spark 做预填充、用 Mac 做解码,把不同类型硬件串起来,两边的好处都拿到。
数据中心层面也在用不同芯片做分工。 Cerebras 的晶圆级芯片 WSE-3 这类 ASIC 加速器围绕单一任务设计,牺牲通用性换取极致性能;他设想让 Cerebras 晶圆负责解码、GPU 负责预填充,这样两边的好处都拿到了。
NVFP4 量化已经是 Blackwell 上的标准做法。 现在大多数拥有 Blackwell 芯片的数据中心和前沿实验室都在用 NVFP4,也就是 4-bit 浮点量化格式,因为它能带来算力加速,成为实际上的标准。

本地推理速度:单会话300 token/秒
主持人:这个速度会上下波动,取决于我开了多少个活跃会话、它们在干什么。最高能到多少来着?对,单个会话能跑到每秒三百个 token,八个并发会话大概能到每秒一千个输出 token,十六个的话大概一千五。这些在 OpenCode 上还是免费的,挺让人印象深刻的。OpenCode 在这方面做得确实不错。好,这是 DeepSeek,你能看到它跑得多快。当然不是人人都有这套硬件,但如果你有俩 DGX Spark,也就是英伟达那款低功耗本地 AI 设备,大概能跑到每秒一百个 token,八个会话的话可能三百左右,而且比 RTX Pro 6000 便宜大约百分之八十。大家有什么问题的话可以提一下。嗯,我这里没有 V100。X 上有几个人在用 V100,可能会分享一些内容,你搜一下就能找到。对,Bonsai 也挺不错的,就它的体量来说相当能打。GLM Flash 在我感觉上更擅长理解意图。DeepSeek 会犯一些很奇怪的错,但它也更快,智能上限也稍微高一点,所以它能做别家做不到的事。对,失败率更低。只要更新一下 recipe,也就是部署配置文件就行,不用重新启动任何东西,我只需要更新一下。好,这是我这周做的最酷的事之一,或者说这些模型这周做到的最酷的事之一。我们拿了一台 M4 Mac mini,最便宜的那款,大概八百美元,16G 内存,256G 存储。
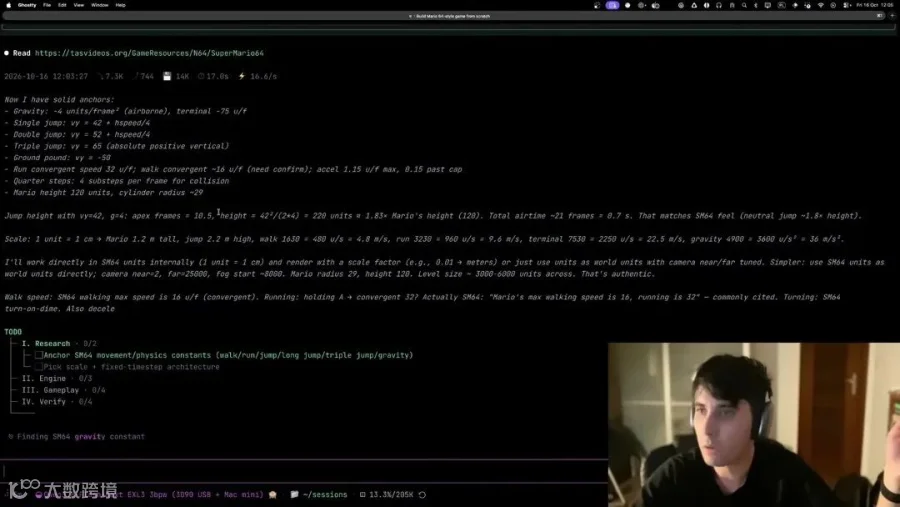
主持人:就这样。然后就是最低配的那个芯片配置什么的。再加一张 RTX 3090,价值一千二百美元。还有那个叫什么来着?叫 Chestnut。对,Chestnut,就是一个外置显卡盒子。对,eGPU。你基本上把显卡装进去,它给你一根 USB-C 线,插到 Mac 上就行。然后我可以干这种事,比如跟它说:你好,能给我做个超级马力欧 64 的游戏吗?风格要一模一样,手感一样、移动方式一样,但必须从零开始写。做完之后打开浏览器看效果。这大概要六个小时才能完成。也不是说它特别慢吧,其实还挺快的,解码大概每秒三十个 token,预填充,也就是处理提示词的阶段,大概每秒六百个。只不过这个模型推理想得很多,我就只能坐在那等它想完。诶我们真做到黑客那部分了吗?我不记得了。你看到了吗?每小时四美分。甚至还能更便宜,我再确认一下。稍等,我查一下 DGX Spark,你看这里所有可租的里最便宜的是一小时三毛美元。
$2,500的Mac mini加RTX 3090方案
主持人:你可以租一台或两台GPU(如果能找到同时出租两台的),每小时大概三毛到六毛,在上面跑模型,再建一个API直接调用就行。当然这不便宜:三毛一小时,一天下来差不多八美元,而且速度会很慢。你也可以去RunPod或者Prime Intellect这类GPU云租赁平台,上面都有类似的东西可以做。一旦你租下来跑了基座模型,就不会遇到任何拒绝回答的情况;就算碰上了,你也可以换种说法问。另外你看这里,这是在Mac mini加RTX 3090上跑的——我觉得这事太疯狂了,两千五百美元的硬件居然真能以这个速度跑起来,简直不可思议。
主持人:这是一个很聪明的开放权重模型,大概也是综合排名第二十左右的模型。它和Opus 4.8 low reasoning打平,在Artificial Analysis指数上得分一样。DGX Spark我记得算力大概是一个PFLOPS左右,具体数字待核实,所以它在上面的预填充非常快。DGX Spark和RTX Pro 6000的预填充差距不算大,至少以我的经验来看挺接近的。但Spark的解码真的很低,因为它用的是LPDDR内存,也就是低功耗双倍数据速率内存。每台Spark有128G内存,带宽是每秒273GB,这就是这张卡读数据的速度。而你要读的数据非常多,别忘了模型都很大,所以一直在大量读数据。但重点是,Mac这边M3 Ultra、M5 Ultra是475 TFLOPS。
主持人:还有FP4支持。Mac M3 Ultra的内存带宽是每秒812GB,比刚才那台快了差不多三倍多——注意是M3 Ultra,不是M5。但M3 Ultra上的预填充很差劲,真的只有DGX Spark的四分之一甚至更低。价格方面,假设DGX Spark是五千美元(我知道现在更贵了,但我们先按五千算),一台带256G的M5 Ultra Mac是一万美元。那我们拿两台DGX Spark加一台Mac,总共两万。

DGX Spark与Mac Ultra的性能对比
主持人:这样你就能跑和买四台 Spark 一样的模型,而且预填充和解码都会更快,只要把它们连起来就行。这种事在本地层面已经发生了,比如 CPU offloading:有人用 DGX Spark 做预填充、用 Mac 做解码,就是用不同类型的硬件去优化性能。所以快四倍,谢谢你的纠正,我真的非常感谢。
但重点是,这种事不光发生在本地层面,在数据中心层面也在发生。在数据中心那边,他们用加速器芯片,比如 Cerebras 的晶圆级芯片 WSE-3。顺便说一句,如果 Cerebras 的人在看,抱歉我要是把信息说错了,我就是随便聊聊。这就是 Cerebras 的芯片。它和普通 GPU 的区别在于,Cerebras 用的是巨大的 die,晶圆更大,他们把 die 放在晶圆之间,这样数据可以很快地被读取,每个单元的数据都紧挨着它自己,不用在板子上搬来搬去。而 GPU 小得多,也更紧凑。
主持人:它内部怎么工作的我就不评论了,我可能说错,什么更小的缓存之类的。总之,Cerebras 这种芯片是一种加速器,属于 ASIC,也就是专用集成电路。你们要是了解过加密行业,比特币、以太坊挖矿那些,应该就有 ASIC 的概念。ASIC 就是一种专门计算机,牺牲通用性,把一件事做到极致。比如比特币矿机用的就是 ASIC。以太坊转 proof of stake 之前,人们是用 GPU 挖的,因为 GPU 更好买,产量也大。
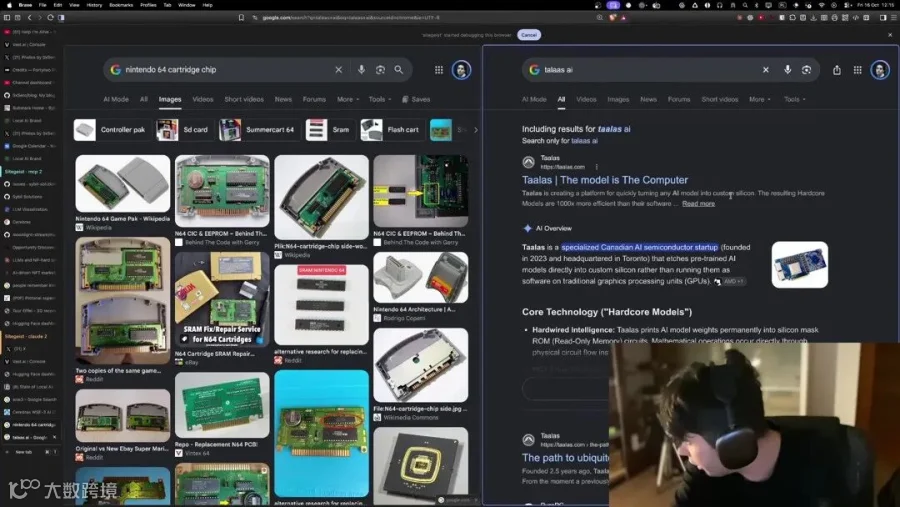
而且在一个行业刚起步的时候,GPU 肯定更多,因为人们用它写代码、打游戏、干各种各样的事。但 ASIC 这种加速器芯片就是围绕某一件特定的事精心设计的。所以作为数据中心,或者像 OpenAI、Anthropic 这样的公司,两种都要有才有好处,然后再想办法把它们连起来,让 Cerebras 晶圆负责解码、GPU 负责预填充,这样两边的好处都拿到了。成本也会降下来,因为 Cerebras 晶圆大概率更贵。哦不,关于 Talos 我没什么信息,抱歉。但我非常喜欢 Talos 在做的事。Talos 走的是模型即芯片的路线,我来打个比方,就像任天堂 64 的卡带芯片那样,用它来解释 Talos 到底做什么。
Talos芯片:把模型蚀刻进硅里
主持人:我们打开这个,然后再打开 Talos AI。我得给我老婆发条消息,我有点超时间了。他们把模型权重直接做在芯片上——你有这方面的信息吗?我想他们现在应该有更好的方案了吧?
主持人:嗯,不,我认为他们不会提供任何剪枝过、或者量化到四位以下的东西。我觉得现在所有人都在用四位精度,至少所有拥有 Blackwell 的都是,因为 NVFP4——也就是 4-bit 浮点量化格式——能带来算力加速。所以现在跑 NVFP4 实际上已经成了标准做法。
任何有 Blackwell 芯片的,不管是哪个数据中心还是哪家前沿实验室,都……我不能说全都,大多数应该都在用 NVFP4,我是这么认为的。
原视频:I ran the 8th best Open Source AI on a Mac Mini and RTX 3090 | Qwen3.8-Next-Flash
https://www.youtube.com/watch?v=g_ZoRnfqRgk
中文播客:在小宇宙App搜《硅谷对谈》,或直接访问下面的链接
https://www.xiaoyuzhoufm.com/episode/6ad424420e4e410a05be74b0
编译:磊哥Thomas