


导读本文整理自顺丰科技钱亮在 DataFun 2026 深圳站 Agentic AI Summit 超级智能体系统机构峰会上的分享。
围绕老代码重构这一真实场景,项目从单 Agent 裸跑起步,逐步引入 hooks、多 Agent、skills、workflow、HITL、状态与记忆、评测和可观测机制。本文重点介绍这套 Harness 为什么产生、如何一步步演化,以及每次踩坑背后的工程取舍。
主要内容包括以下几个部分:
1. 老系统重构场景与 Harness 引入背景
2. Harness 起步:从 rules、hooks 到 workflow 编排
3. 流程控制:门禁机制、HITL 与多 Agent 协作
4. 长任务加固:状态、记忆、评测与可观测
5. Harness 演进路径与工程实践总结
老系统重构场景与 Harness 引入背景
项目面对的是一个技术栈较老、模块众多的祖传系统。整体包含多渠道接入、接入与安全层、清结算、存款、账户等业务域,以及技术与数据支撑。同时面临安全、漏洞等问题。直接整体重构风险太高,因此我们先选一个模块打样,希望用 AI Coding 跑通完整重构路径,再为其他模块改造铺路。
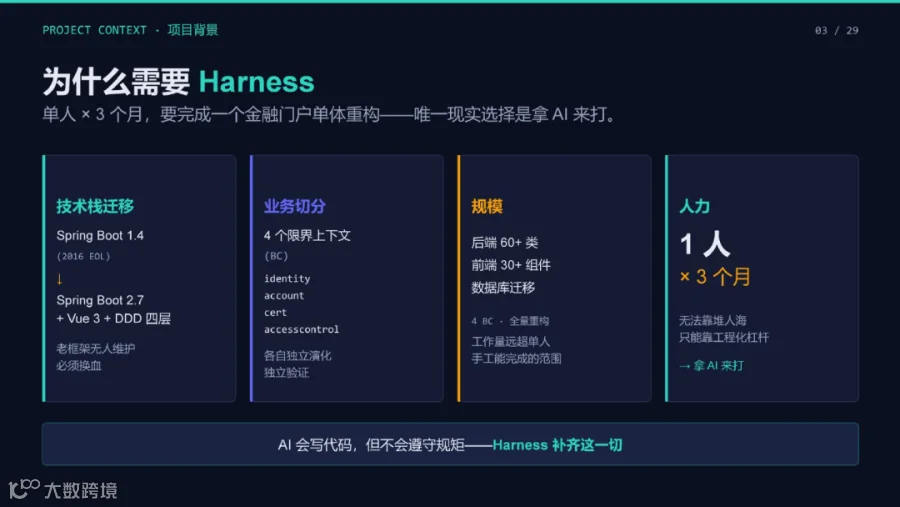
约束非常明确:1 个人、3 个月,完成一个金融门户单体重构。技术上要从 Spring Boot 1.4 迁移到 Spring Boot 2.7,并引入 Vue 3 和 DDD 四层;业务上拆成 identity、权限资源等限界上下文;规模上包含后端 60+ 类、前端 30+ 组件和数据库迁移。靠单人手工完成并不现实,只能借助 AI,但很快发现:AI 会写代码,却不会天然遵守工程规矩,Harness 必须补上这一层。

裸跑前两周出现了三类典型问题。第一是假 PASS:subagent 返回 status: PASS、tests: 431 passed,实际只写了测试,甚至拿旧的 surefire 报告当作完成证据。第二是架构污染:旧项目里 Controller 和下层都夹杂业务逻辑,Agent 照抄旧结构,连 Session 都泄漏进 domain,虽然规则明确写了“domain 零 Spring”,长上下文下仍会遗忘。第三是“顺手改”:本来只要求按一个 API 范围迁移,却顺手重构 100+ 行无关代码,回滚花了约 30 分钟。
因此我们的判断是:AI Agent 更像一个“聪明的键盘手”——懂 DDD、TDD,也写得快,但记不住“不许顺手改”、当前关卡以及上次犯过的错误。

这里把 Agent 理解为Model × Harness × Context,而不是简单相加。模型再强,如果 Harness 或 Context 为零,工程结果依然可能失控。对应到项目里,Context Engineering 负责 rules、memory、CLAUDE.md;Architectural Constraints 用 hooks、schema 提供确定性约束;Entropy Management 通过 evals 和 observability 修复长期漂移。整个系统形成 Feedforward → Orchestration → Action → Feedback → State / Log 的控制回路。
Harness 起步:从 rules、hooks 到 workflow 编排

第一阶段先使用既有研发规范和 .claude/rules/*.md。问题是 rules 只是自然语言软约定:rules/04 已经写明前后端契约要求,但前端仍按任务文字实现,直到后续才发现与 OpenAPI 结构不一致,最终触发大范围返工。
于是加入 hooks,把“提醒”变成“拦截”。例如 openapi-drift.sh 在接口变更后检查下游对齐,PreToolUse hook 配合 exit 2 做硬阻断,gate-guard.sh 拒绝跨关卡写入。软约定可以被忘记,hook 则负责守住底线。

hooks 能拦单点违规,却解决不了同一上下文里的污染。generator 和 reviewer 在同一会话中容易出现 self-eval 偏差,于是进一步拆成 architect、explorer、implementer、planner、reviewer、verifier 等 subagent。
不同角色可以路由不同模型,降低 token 成本;独立上下文隔离生成与评审;再用结构化契约明确“谁写、写什么、何时停”。一句话,hooks 管“不许做”,agents 管“看得清”。
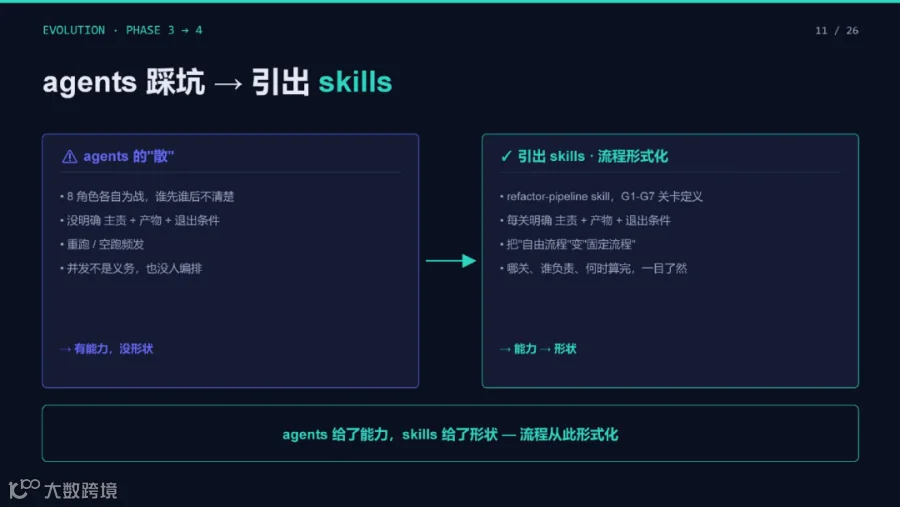
但角色拆开后,又出现“有能力、没形状”的问题:多个 agent 各自为战,谁先谁后不清楚,主责、产物和退出条件也不稳定。我们因此引入 refactor-pipeline skill,用 G1-G7 关卡把自由流程形式化。
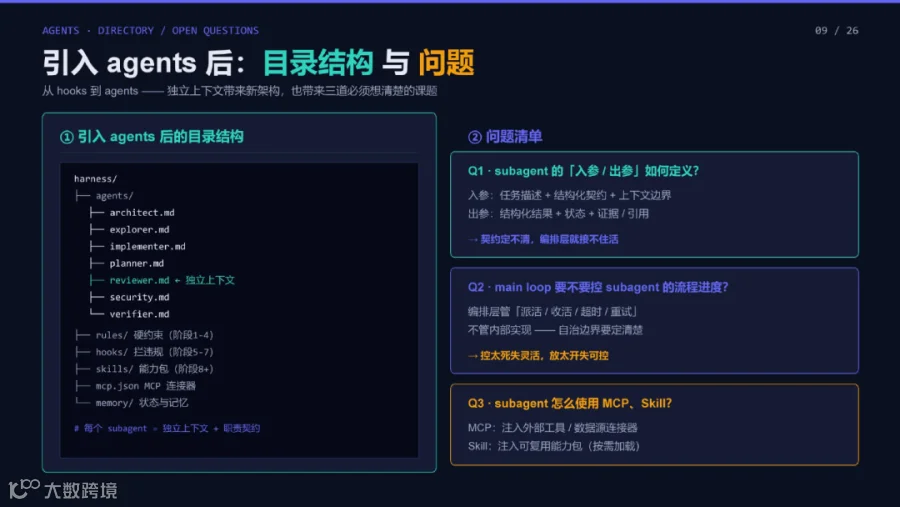
此时 Harness 中已经包含 agents、rules、hooks、skills、MCP 连接和 memory。每个 subagent 都是“独立上下文 + 职责契约”,但仍需回答三个问题:入参、出参如何定义;main loop 管到什么粒度;subagent 如何使用 MCP 和 Skill。编排层应该负责派活、收活、超时和重试,而不是侵入子 Agent 的内部实现。

主子 Agent 之间最终采用 RESULT sentinel 结构块,返回 agent、task_id、status、files_touched、tests、followup、blockers、notes 等字段,方便 main loop 稳定解析。
更关键的是用 Schema 强制约束。例如 Prompt 里写“必须落盘”仍可能出现空手 PASS,真实情况甚至连续发生过三次;把 files_touched 设为 minItems: 1 后,约束才真正生效。同时增加 PARTIAL 状态:例如测试已写但主类没写,或 5 个类只完成 3 个,都不能强行报 PASS。
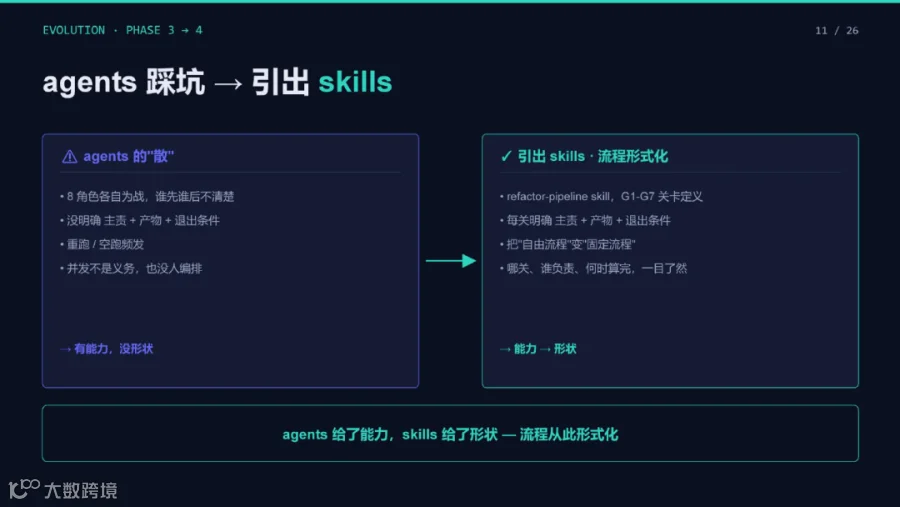
到这里,agents 解决“能力分工”,skills 解决“流程形状”:每一关都明确主责、产物和退出条件,让主流程知道当前在哪一关、何时算完成。

但 skill 仍以自然语言驱动为主,实际会出现主 Agent 越权写代码、G1-G7 跳关,以及中途失败后无法从指定节点续跑等问题。它“单步强、流水线弱”,所以进一步引入 dolphin-flow.js 工作流编排:支持 G4 batch 并发、结构化 RESULT、早退兜底、任务状态和断点续跑,用编排取代手工调度。
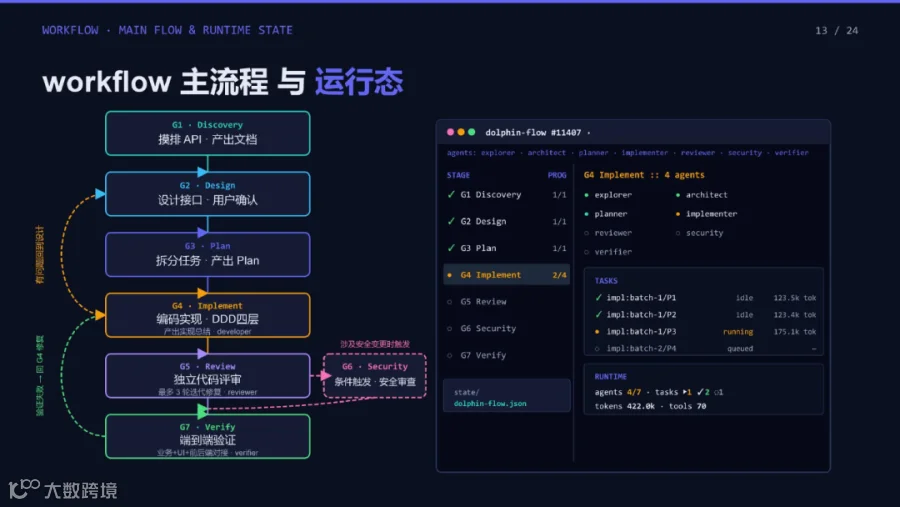
主流程固定为 G1 Discovery、G2 Design、G3 Plan、G4 Implement、G5 Review、G6 Security、G7 Verify:前面三关分别完成 API 摸排、接口设计与用户确认、任务拆分;G4 进入 DDD 四层实现;G5 采用独立评审,最多进行 3 轮迭代修复;G6 按条件触发安全审查;G7 做端到端业务、UI 和前后端验证。
运行看板同时展示关卡进度、并发任务和 token 消耗。长任务状态则落盘到 state/dolphin-flow.json,不再只依赖 Claude Code 本地缓存。这样即使某一关失败、会话退出或任务意外中断,也能从已确认的状态继续,而不是把前面已经完成的关卡重新烧一遍。
流程控制:门禁机制、HITL 与多 Agent 协作
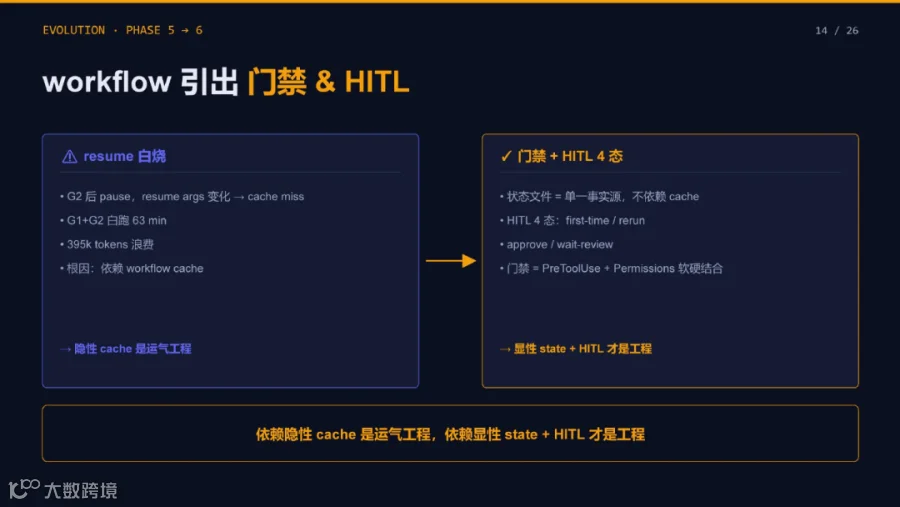
工作流跑起来后,新的问题出现在 pause / resume。G2 设计完成后需要人工确认,但第一版依赖 workflow cache:resume 参数变化会 cache miss,导致 G1、G2 重跑;缓存命中又可能直接略过检查。一次真实代价是白跑 63 分钟、消耗 395k tokens。
于是我们把状态文件作为单一事实源,并把 HITL 做成可插拔门禁:隐式依赖 cache 是“运气工程”,显式 state + HITL 才是工程。
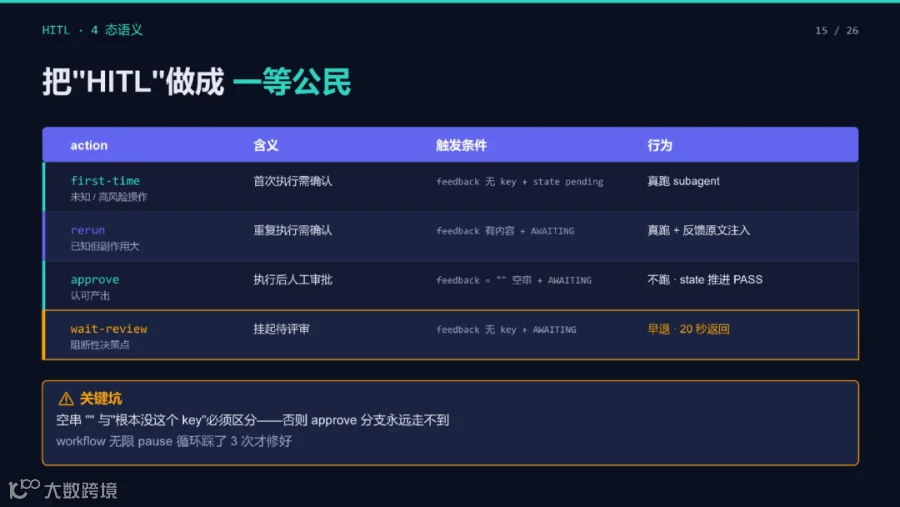
HITL 被统一为四种状态:first-time 首次执行需确认;rerun 带反馈重新执行;approve 人工认可后不重跑、直接推进 state;wait-review 没有反馈时挂起并早退。
这里必须区分 feedback="" 与“根本没有 feedback key”,否则 approve 分支无法命中,workflow 会反复 pause。

门禁设计同时要算成本。实测中,first-time 约 5 个 agent、63 分钟、395k tokens;rerun 约 3 个 agent、2 分 50 秒、123k;approve 约 3 个 agent、1 分钟、30k;wait-review 只启动 bootstrap agent,约 20 秒、16k。
早退与全量重跑相比可节省约 20 倍,因此每种用户行为都应有明确的成本上限。

多 Agent 也不是越多越好。角色从最初的 planner / generator / evaluator 扩展到 architect、planner、implementer、reviewer、security、verifier、explorer 和工具型 doc-finder。
协作既可以在单 workflow 内并发,也可以让独立 BC 多 workflow 并行;存在依赖的任务按顺序串联;G5 可由多个 reviewer 聚合反馈;G2 还可以让多个 architect 分别出方案,再交给 reviewer 选优。但一次 G4 batch 拉起 9 个 subagent 时,前 4 个正常、后 5 个直接 429,说明并发必须匹配 API quota,并承担 rate limit、race condition 和观测成本。
长任务加固:状态、记忆、评测与可观测
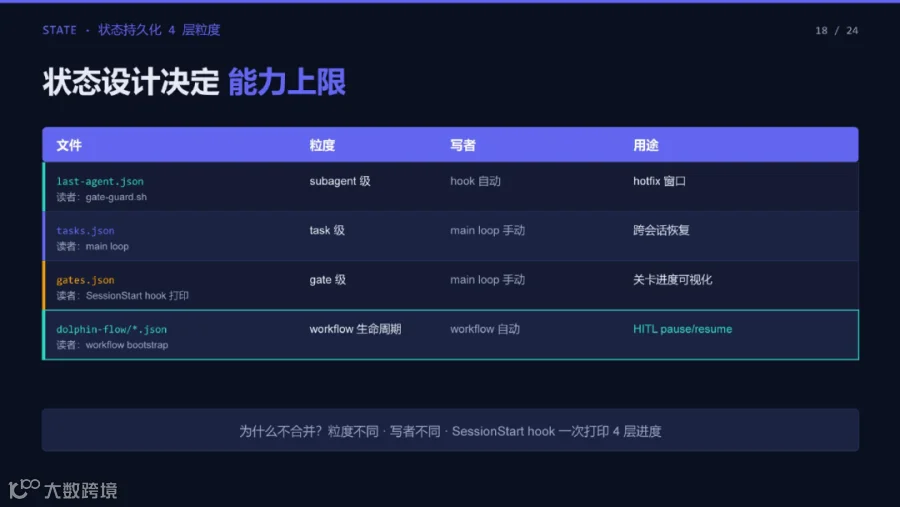
为支持跨会话和长任务,状态按粒度拆成四层:last-agent.json 记录 subagent 级状态,用于 hotfix 窗口;tasks.json 记录 task 级状态,用于跨会话恢复;gates.json 记录 gate 进度;dolphin-flow/*.json 记录 workflow 生命周期和 HITL pause / resume。
它们写者、读者和用途不同,不应强行合并,SessionStart hook 会一次打印四层进度。
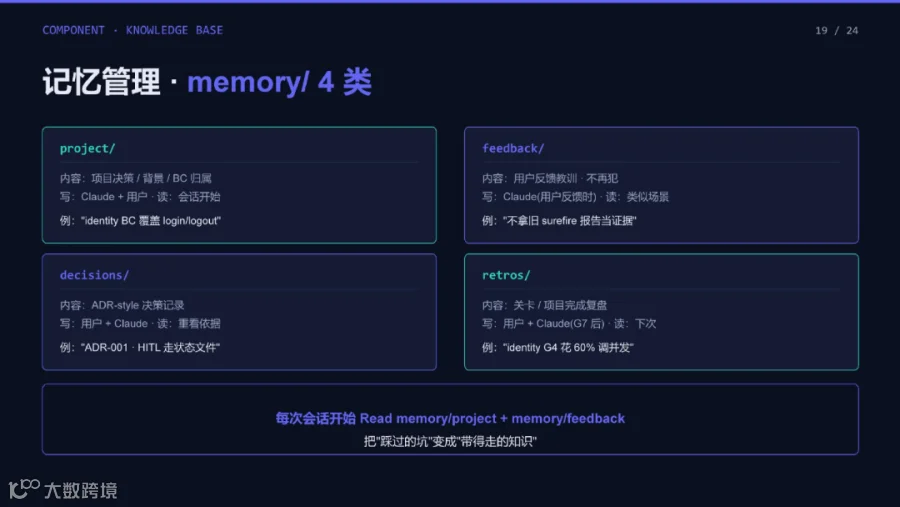
memory 同样分层:project/ 保存项目背景和 BC 归属,feedback/ 保存用户反馈和“不要再犯”的教训,decisions/ 保存 ADR 风格决策,retros/ 保存关卡或项目复盘。
比如“identity BC 覆盖 login/logout”“不拿旧 surefire 报告当证据”“HITL 走状态文件”等,都可以沉淀到对应目录。每次会话启动优先读取 project 和 feedback,让踩过的坑真正带到下一轮。

state 记录“当下发生了什么”,用于恢复;memory 记录“过去为什么这么定”,用于未来决策。长任务不能只依赖模型上下文,因为会话重置或压缩后只剩摘要,关键细节可能丢失。把状态和记忆外化,才能让每次“醒来”都知道当前进度,也能追溯历史依据。

评测落在四个 rubric:outcome 看结果、测试和产物是否正确;process 看 Agent、gate 和流程是否合规;style 看命名、分层和 TDD;efficiency 看 tokens、agents、duration。
已有三类 Capability 评测:dolphin-flow 冷启动 6:14、5 agent、234k tokens;HITL 四态 T1-T4 全跑通;G1-G7 完整 pipeline 约 2 小时、30 agent、1.5M tokens。Regression 则覆盖 postGate-p0-injection、explorer-scope-drift、batches-json-parse 等问题。
以 explorer scope-drift 为例,修掉“假 PASS”后,Explorer 会老实报告边界,Architect 能更准确处理约束,Planner 拆任务更合理,Implementer 也会如实上报环境阻塞。契约变严会沿下游产生正向反馈,而不是单纯增加负担。
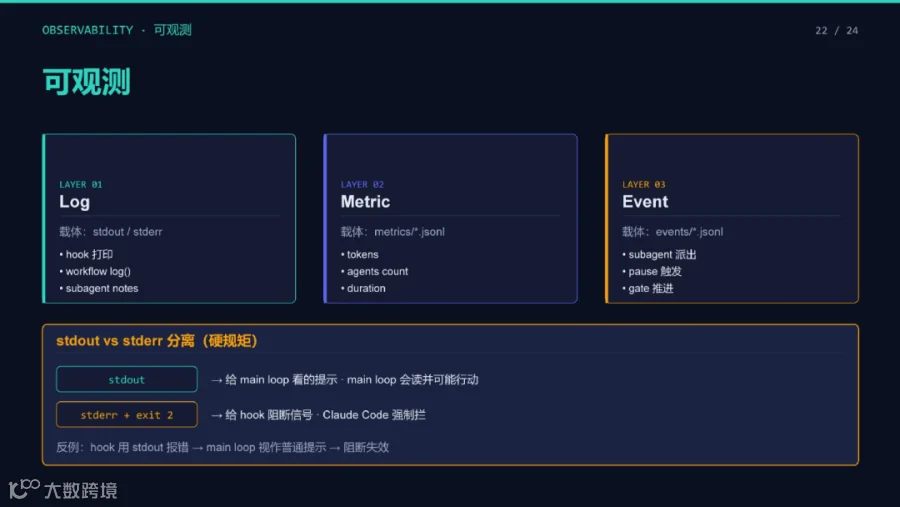
可观测分三层:Log 记录 hook、workflow 和 subagent notes;Metric 用 metrics/*.jsonl 记录 tokens、agent 数和 duration;Event 用 events/*.jsonl 记录 subagent 派发、pause 触发和 gate 推进。
这里还有一条硬规则:stdout 是给 main loop 的普通提示,stderr + exit 2 才是 hook 的阻断信号;如果把错误只打印到 stdout,硬拦截就会失效。
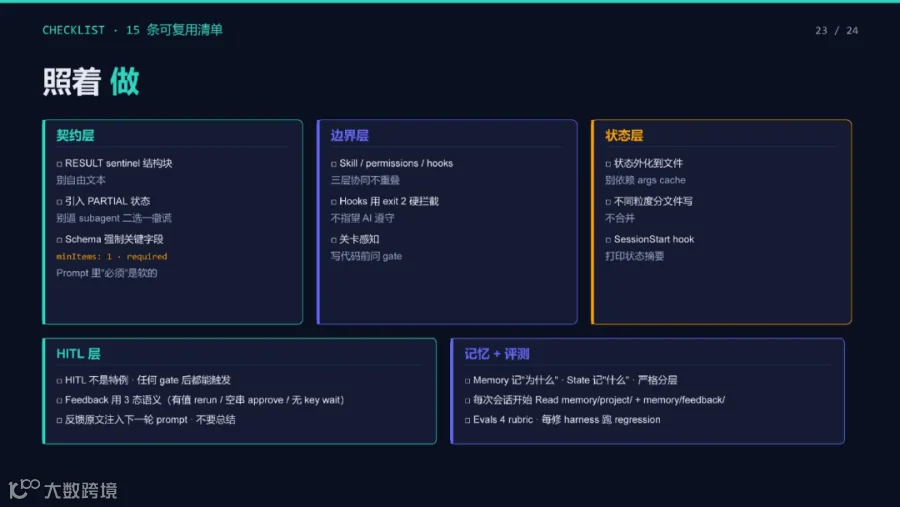
最终形成的可复用原则可以归纳为五层:契约层用 RESULT sentinel、PARTIAL 和 Schema,关键字段必须由结构约束;边界层让 Skill、Permissions、hooks 各司其职,写代码前先判断 gate;状态层把关键状态落盘而非依赖 cache;HITL 层把反馈语义和门禁统一起来,并把用户反馈原文注入下一轮 prompt;记忆与评测层持续沉淀项目知识,每次 Harness 修改后都跑 regression。
Harness 演进路径与工程实践总结
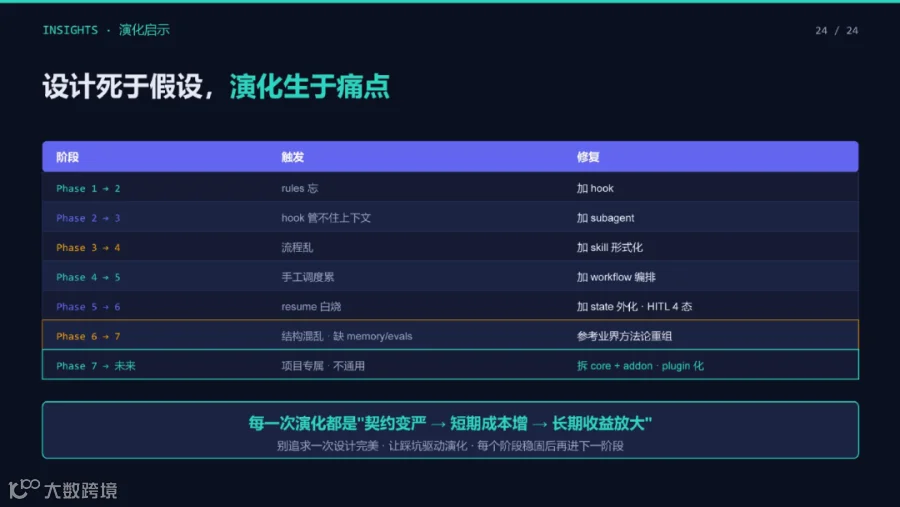
回看整个过程,路径非常清晰:rules 会忘,就加 hooks;hooks 管不住上下文,就拆 subagent;角色散乱,就用 skills 形式化;自然语言调度会跳关,就上 workflow;resume 白烧,就外化 state 并补齐 HITL 四态;再进一步加入 memory、evals 和 observability。下一步,项目还会从专属实现继续拆成 core + addon,向 plugin 化演进。
这套 Harness 不是一次设计出来的,也不是照搬某个现成方案。每一步都来自真实失败,再把失败固化成更强的契约。短期看,约束变严会增加实现成本;长期看,它能降低返工、漂移和不可恢复的风险。
对于长程 AI Coding,真正重要的不是“让 Agent 更自由”,而是让它在可恢复、可验证、可观测的边界内持续工作。
往期推荐
AI Agent进入生产后,如何做到可观测、可评估、可运营?
98.5% 自动审核、0.003% 欺诈率:金融 Agent 的真实水位
从 BI 到 Agentic BI:让数据应用从展示走向受控行动
Agent 评测没有统一标准——美团、高德、科锐国际各走各路,该学谁?
Harness Engineering 的语义底座:本体驱动的 Agent 可控执行
语义+本体+Harness的Data Agent架构探索!
中国第一批把企业知识做成资产的公司,公开了做法
腾讯金融合规 Agent 实战:32B 小模型、Skill 化规则与双轨自进化
相关性 vs 收入,不必二选一——小红书用 3 个 Agent 重构了搜索分发
从RAG到Ontology:Palantir用一套业务语义网,实现了85%增长与零流失锁死

点个在看你最好看
SPRING HAS ARRIVED
