


跨境电商AI选品调研横评:公平边界与证据复核
为验证AI助手在跨境电商业务中的实际效能,本文对Claude Code、Codex及Antigravity进行了同一任务的横向测评。测试于2026年10月7日进行首轮,10月17日针对Antigravity更换新模型补测,共形成四份独立答卷。Manus因运行环境差异,作为场外参考单独列示。本次测评旨在建立一套可复核的评估体系,帮助从业者判断AI产出是否具备决策价值。
任务设计:明确交付标准与约束
测试题目设定为时尚品类蓝海选品调研,角色定位为跨境选品研究员。核心要求是提交有证据、可复核的成果,而非仅仅提供执行计划。
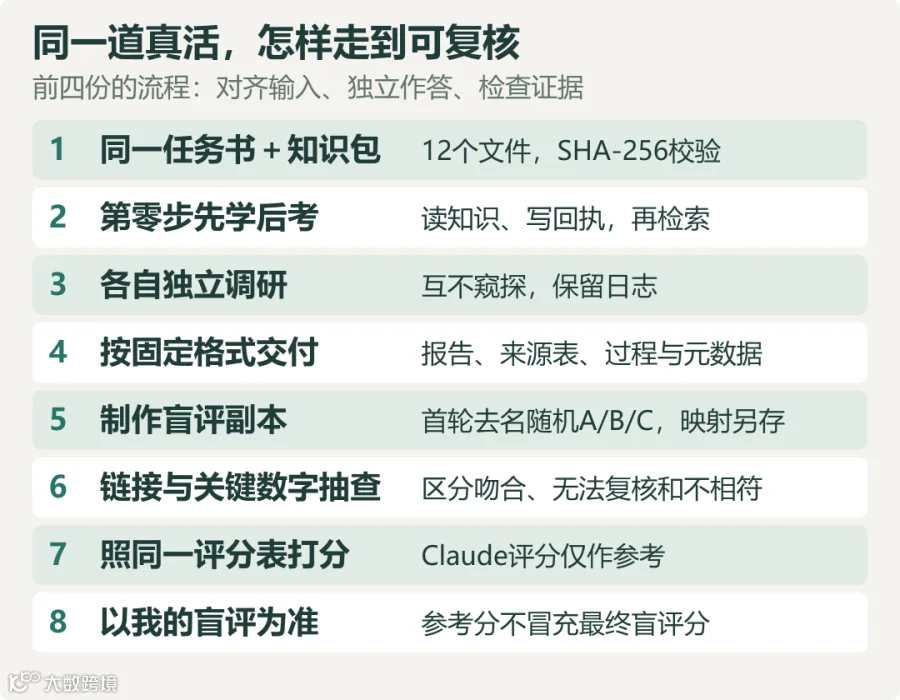
图 1|前四份的测试流程。Claude参考分不等于我自己的盲评结果。
商业逻辑验证:需复制一套成立的生意机制,即海外需求已验证、国内存在认知或开发缺口、制造能力可承接、单位经济模型成立。严禁将无现货直接等同于蓝海,需明确区分门槛、需求缺失或开发不经济等情形。
判断框架:从套利层(信息差、成本、确定性)延伸至流量转化,最终落脚于围绕人群组织供应链的垂直产品线。重点考察逻辑推导能力,而非方法论复述。
调研路径:分为垂直类目、细分人群、本土品牌三路独立检索。以日本为首要验证市场,美、欧、韩为交叉对照市场。每个方向需明确载体、差异化元素、目标人群及可检索词,避免泛化或无效组合。
数据严谨性:单次仅验证一个元素,评论数不等于销量,未搜索到不等于无人做。缺口原因需明确归类。财务测算需涵盖售价、采购、起订量、物流、平台费、广告及退货等全链路成本。初筛标准为客单价至少6,980日元或49美元,单件净利至少100元人民币。数据缺失时需给出区间与假设,严禁编造精确利润。
交付规范:包含知识回执、主报告、来源表、过程日志和运行元数据。主报告需含摘要、方法限制、8—12个候选、3—5张深研卡及淘汰清单。关键判断需标注事实、推断或假设,链接必须真实有效。
公平性控制:统一上下文与环境差异
为确保公平,所有参赛AI使用同一份任务书原文及包含12个文件的知识包。知识包提前生成SHA-256指纹以供比对,确保三方接收内容一致。

图 2|公平性既包括统一条件,也包括把没有控制住的条件公开。
前置步骤:各方需先读取知识包并计算哈希值,确认一致后方可开始检索。日志检查显示,三方均未越界读取其他方产出。
环境差异:测试直接通过CLI启动,避免派单器注入额外业务规则。禁止项包括付费、登录后台、绕过验证码等。但存在以下不可控差异:
- Codex被强制注入全局规则(声明未使用);
- Claude环境含有同名方法论及长期记忆(未调用);
- Antigravity环境规则未知,且首轮仅能查看搜索摘要;
- 各工具检索能力不同,部分可直接读页,部分依赖网页工具。
Manus场外参考说明:Manus基于平台运行,使用知识库v1.1而非统一版本,未提供哈希校验及运行日志,交付物仅限主报告。因此不纳入正式排名,仅作参考。
评分体系:聚焦业务风险与证据可靠性
评分满分100分,权重设置基于业务风险排序,而非通用智力评估。

图 3|五个维度的权重反映这次选品调研的风险排序,不是通用智力分数。
- 证据可靠性(30分):核心指标。核查链接有效性、页面支持度及多源验证。每份报告至少抽查10条来源。
- 因果逻辑与模式匹配(25分):防止将缺货误判为蓝海,需论证需求驱动因素及缺口成因。
- 产品具体与开发可行性(20分):建议需具体至可讨论打样程度,拒绝空泛方向。
- 单位经济(15分):调研阶段允许估算区间,但需明确假设前提,严禁将假设当作报价。
- 反证与透明度(10分):要求列出至少3个淘汰方向,主动披露未知项与阻碍。
维度间存在关联,如证据不足会影响因果判断。评分规则旨在提供可讨论、可复查的标准,而非绝对科学量表。
复核过程:双向抽查与数据纠错
鉴于Claude兼具组织者与参赛者身份,其给出的分数仅作参考,最终以作者盲评为准。首轮报告匿名处理,映射表独立保存。
首轮抽查:仅对Codex的10条链接进行逐项复核,8条吻合,2条因拦截无法复核。Claude和Antigravity因来源形式问题未完成同等深度复核,导致验证不对称。
二轮核对:针对Antigravity补测报告,核对17个关键数字,均能在抓取页面中找到对应,证实引用与当时内容一致。但需注意,数字存在不代表结论成立。
常见错误类型:
- 数据概括失真:如将少量评论概括为“接近0”;
- 引用错配:凭单一款式预售判断结构性缺货;
- 计算口径错误:未扣除消费税、佣金率取值偏差、汇率折算错误等。
Manus复核:尝试打开15条链接,10条关键数字吻合,5条因技术原因无法复核。发现其汇率折算高估净利约15%,且未核实官方分档费率,但结论方向未受根本影响。
评测结果:各模型表现差异分析
Claude参考评分如下:Codex 84分,Claude Code 70分,Antigravity首轮约33分,第二轮约72分。Manus场外参考分约83分。

图 4|Claude参考评分。Manus为场外参考、条件不同,不参加前四份排名;第一轮缺失分项不推算。

图 5|耗时与证据获取过程。搜索、打开次数和具体URL不是同一种统计,未知项保留未知。
- Codex (84分):优势在于证据纪律严明,冲突字段标注清晰,公式可复算。弱点是日本主站未完全打开,竞争密度分析不足,最终仅给出优先验证方向而非确证蓝海。
- Claude Code (70分):优势是直接读取平台页面,市场结构扫描完整。缺点是供给侧调查空白,费用与汇率采用保守假设,需求证据偏弱。
- Antigravity (首轮33分/二轮72分):首轮速度极快但未打开任何页面,严重依赖知识包,缺乏可复核性。更换Gemini 4 Argon模型后,通过一手数据纠正了知识包矛盾,质量显著提升,但仍存在表述过满的问题。
- Manus (场外83分):供给侧取证最强,明确区分认知错位与开发门槛,未夸大蓝海属性。但因汇率、税费口径错误扣分。
后续优化与建议
本次测试中,各方均未得出确证的新蓝海,这本身具有价值,避免了盲目采购。但也暴露出对知识包的过度依赖,尤其是Antigravity首轮几乎全盘照搬。未来测试将增加“仅给方法论、不给产品库”的对照组,以评估独立发现能力。
给从业者的建议:
- 选择真实工作任务进行测试,明确交付格式与扣分标准;
- 要求关键结论附带可核对证据;
- 保持同题、同知识、同禁止项,若环境无法完全一致则需公开差异;
- 评分者应回避利益冲突,或采用盲评机制;
- 保留抽查规则与扣分理由,确保评估过程透明。
需警惕将知识包当作研究、将评论当作销量、将未搜到当作无人做的思维陷阱。AI辅助决策的核心在于建立可回溯、可核对的证据链条,而非仅仅追求报告的流畅度。