

选择大模型算法研究方向时,建议重点考量“技术迁移能力”与“创新窗口期”两个核心维度。基于此标准,当前值得关注的方向可分为三个梯队,涵盖11个具体切入点。
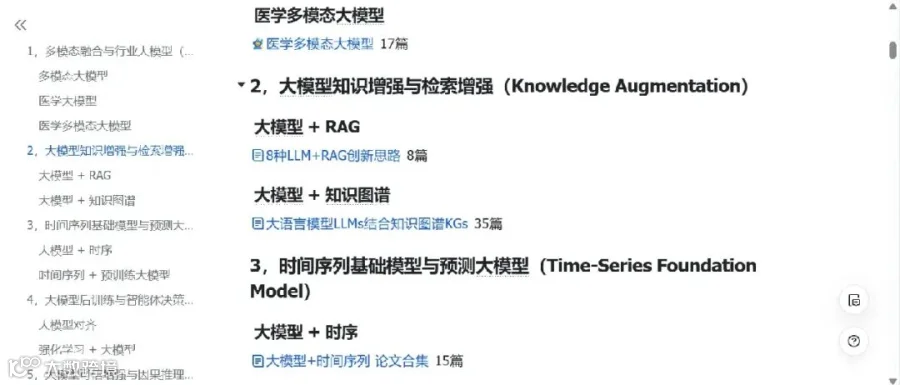
为辅助深入研究,笔者梳理了264篇高价值LLM前沿论文,去除了低质内容并按实战价值分为六大类。下文所述方向在合集中均有对应代表性工作,建议结合方向逻辑与论文参考,以精准定位创新点。
第一梯队:推理训练、Agentic Search与Agent训练
该梯队方向具备较高的优先推荐价值。
推理训练是大模型算法能力的交汇点,涉及强化学习(RL)、奖励模型设计、训练稳定性及数据构造等关键经验,这些能力具有极强的可迁移性。
Agent方向则侧重于模型能力与任务闭环的结合。若能进一步融合搜索机制、工具调用及强化学习技术,将显著提升核心竞争力。
相关研究可参考论文合集中“LLM后训练与智能体决策”和“LLM知识增强与检索增强”两类。
第二梯队:RM/Judge、对齐安全、多模态后训练与数据工程
这一梯队方向具备较高的投入产出比。
其中,数据工程常被低估。随着模型训练技术的成熟,单纯依靠算法改进带来的性能提升日益有限,而数据质量、筛选策略及奖励数据构造对最终效果的影响愈发显著。
相关内容主要归类于合集中的“LLM可信增强与因果推理”和“多模态融合与行业大模型”板块。
第三梯队:Memory、Deep Research、Code Agent与生成式搜推
该梯队方向的共同特征是缺乏标准答案,正处于技术创新的关键窗口期。
Memory(记忆机制)与Deep Research(深度研究)仍在快速演进中;Code Agent虽增长迅速,但对软件工程能力要求较高,仅掌握机器学习知识已不足以应对。
若旨在寻找论文创新点,建议重点关注第三梯队。由于问题新颖且解决方案尚未收敛,研究者更容易找到独特的切入角度。
对应论文主要分布在“时间序列基础模型与预测大模型”和“大模型驱动科学计算与优化”类别中。
行业趋势与建议
当前大模型算法领域的评价标准已发生变化,不再局限于理论知识,更看重从训练、实验到上线落地及持续迭代的全流程能力。
因此,相较于堆积零散知识,建议通过实际项目、Benchmark测试或开源工作来积累成果。尽管具体研究方向可能随技术迭代而变化,但训练、数据处理、评测体系及工程化等底层核心能力始终具备长期价值。