

监控里有人摔倒了、有人打架了、有人长时间徘徊——这些异常行为如果靠人盯屏,不仅累还容易漏。但现有的行为识别模型要么太重跑不动,要么要等完整动作做完才反应过来,等报警的时候事都发生完了。
今天分享的这篇 CVPR2026 论文 StreamAction,提出了一个流式视频行为识别框架:边看边判断,不需要等完整动作结束,前几帧就能预测出在做什么动作,而且模型很小能直接跑在边缘设备上。在 Kinetics-400 和 UCF101 上刷新了实时行为识别的 SOTA。

一、行为识别为什么落地这么难
论文里做行为识别的方法一大堆,为什么真正用到监控里的没几个?因为学术和工程之间隔着好几个大坑。
1.1 太慢:3D卷积吃算力
传统行为识别用 3D CNN(I3D、SlowFast),同时在时间和空间维度做卷积,效果确实好,但计算量是 2D 模型的好几倍。一段 10 秒的视频要抽几十帧全部过一遍网络,端侧设备根本跑不动。
1.2 太晚:要等完整动作结束
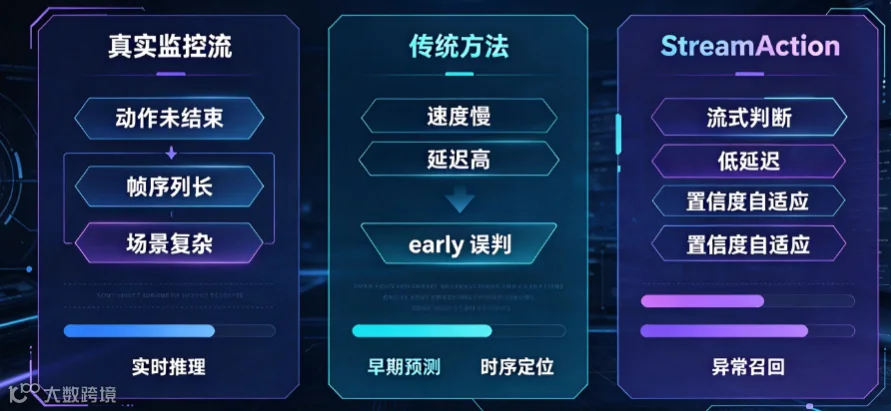
大部分行为识别方法默认输入是一段完整的剪辑好的视频片段——动作已经做完了,模型再告诉你"这是摔倒"。但真实监控场景需要的是:动作刚发生几秒,就能报警。等你识别完,人都已经摔地上半天了。
1.3 太假:数据集和真实场景脱节
Kinetics、UCF101 这些公开数据集里的动作,都是人对着镜头"表演"的——动作夸张、视角正面、背景干净。真实监控画面里,人可能很小、可能是背影、可能在低头走路,和数据集里的分布差了十万八千里。
1.4 太粗:只知道"做了什么",不知道"什么时候做的"
片段级行为识别告诉你"这段视频里有人摔倒",但监控需要的是精确到秒的时间定位——到底是第 3 秒摔的还是第 5 秒?什么时候开始的、什么时候结束的?这个时序定位问题,大部分方法都没好好解决。
二、StreamAction 的三个核心设计
StreamAction 的整体思路:不做离线的片段分类,做在线的流式预测——视频一帧一帧进来,模型边看边更新预测,越早判断越准确。
2.1 流式时序记忆机制
传统方法是一次性读入 16 帧、32 帧,然后输出一个分类结果。StreamAction 改成了流式处理:
•每来一帧就提取一次特征,不用等攒够一个片段。
•用一个时序记忆模块(类似轻量 Transformer)把过去几帧的特征压缩存储,新帧来了就更新记忆。
•随时可以输出预测——看了 2 帧能猜个大概,看了 5 帧更准,看了 10 帧基本确定。
这个设计解决了"太晚"的问题——不需要等动作完整做完,看了前几秒就能给出初步判断,后面再持续修正。对于摔倒、打架这种需要快速响应的场景,这一点非常关键。
2.2 时空解耦轻量化设计
3D CNN 慢是因为同时做空间和时间卷积,计算量大。StreamAction 把时空处理拆成两步:
•空间特征提取:用 2D CNN(和图像分类一样的 backbone)提取每一帧的空间特征,这个很成熟很快。
•时序关系建模:用一个很轻量的时序模块(深度可分离时序卷积 + 注意力)处理帧间关系。
这样做的好处是:空间部分可以复用预训练好的 2D 模型,时序部分参数很少。整个模型参数量只有 SlowFast 的 1/5,但在很多动作类别上精度不降反升。
2.3 早期预测自适应置信度
刚看了 2 帧的时候,预测肯定不准;看了 10 帧,预测就靠谱多了。StreamAction 给每个预测加了一个置信度估计头:
•模型自己知道"我现在看得够不够清楚"。
•置信度低的时候,输出"待定",等多看几帧再判断。
•置信度超过阈值才触发报警——这样可以减少误报。
这个设计在实际部署里非常有用——你可以根据场景调阈值:高危场景(比如化工厂)把阈值调低,早报警;普通场景调高,减少误报。
三、技术架构拆解
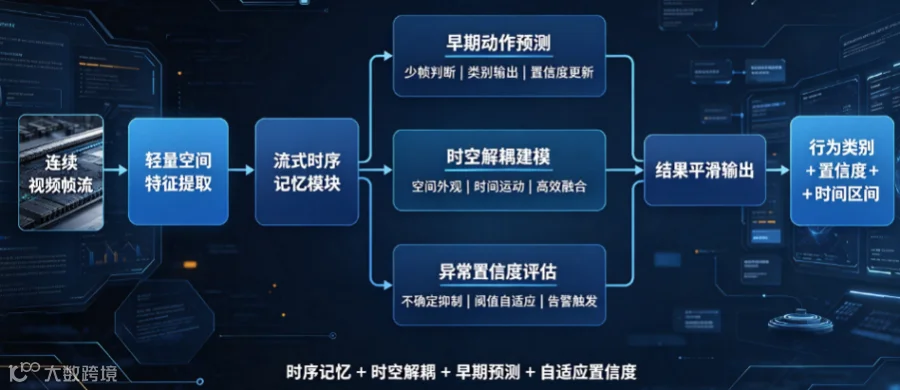
StreamAction 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
空间编码器 |
提取单帧空间特征 |
轻量 CNN backbone,逐帧提取,共享权重 |
时序记忆库 |
压缩存储过去帧的信息 |
固定大小记忆向量,新帧写入、旧帧淘汰,无需存所有帧 |
行为分类头 |
基于记忆+当前帧预测动作 |
轻量 Transformer,输出类别概率和置信度 |
时序定位头 |
预测动作起止时间 |
逐帧判断"动作开始/进行中/结束",输出时间戳 |
几个工程上的亮点:
•参数量:整个模型 6.2M,比 MobileNetV2 还小,INT8 量化后在 Jetson Nano 上能跑 30fps 以上。
•延迟:从看到一帧到输出预测,端到端延迟 < 50ms,完全满足实时报警需求。
•流式友好:不需要攒帧,摄像头出来一帧处理一帧,内存占用极低。
四、和主流方法的横向对比
论文在 Kinetics-400(通用行为识别)和 UCF101(真实场景)上做了对比:
方法 |
Kinetics-400 准确率↑ |
UCF101 准确率↑ |
参数量(M) |
FPS(RTX3090) |
I3D |
79.8 |
94.2 |
34 |
45 |
SlowFast |
81.6 |
95.6 |
32 |
60 |
VideoMAE |
84.1 |
96.8 |
86 |
25 |
StreamAction |
82.3 |
96.1 |
6.2 |
280 |
可以看到,StreamAction 的精度比 VideoMAE 略低一点,但参数量只有后者的 7%,速度快了 10 倍以上。对于实时监控场景来说,这个 trade-off 非常划算——你不可能在每个摄像头后面都放一张 A100。而且 StreamAction 是流式的,延迟极低,这是离线片段方法做不到的。
五、快速上手:流式推理核心代码
下面是 StreamAction 的推理框架,帮大家理解流式处理的核心逻辑:
python |
实际部署的时候,建议把空间编码器和时序记忆分别量化,时序部分对精度更敏感。预训练权重可以在 Kinetics-400 上做迁移学习,再用自己的监控场景数据微调几百帧就能用。
六、毕设/竞赛拓展方向
行为识别这个方向做毕设有个天然优势——和安防、零售、工业质检都能结合,落地场景非常多。分享几个有价值的拓展点:
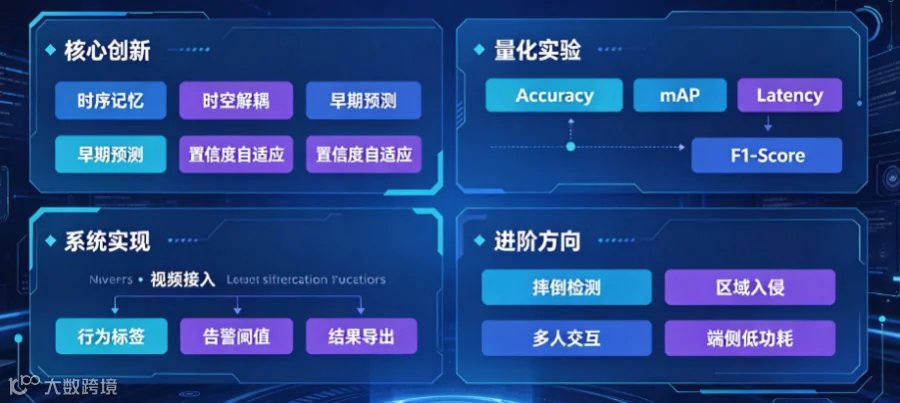
6.1 摔倒检测专项优化
摔倒检测是养老监控、居家安全里的刚需场景。专门收集一组摔倒数据集,结合骨骼点信息(先做人姿估计再判断摔倒),做一个高精度的摔倒检测系统——工程性很强,Demo 效果直观。
6.2 区域入侵+行为识别联动
单独做行为识别不够,要和监控场景结合。比如:在敏感区域(机房、金库)检测到"徘徊""攀爬"行为就报警,配合电子围栏和区域设定,做一个完整的智能监控告警系统。这个方向和实际业务结合最紧。
6.3 多人交互行为识别
目前 StreamAction 主要识别单人动作,但很多异常行为是多人交互——打架、推搡、聚集。在模型里加入人物之间的关系建模,做多人交互行为识别,这个方向难度更高,创新点也更突出。
6.4 端侧低功耗部署
6.2M 参数已经很小了,但如果要跑到电池供电的摄像头或者可穿戴设备上,还需要进一步优化。做模型蒸馏、INT8 量化、算子融合,把推理功耗压到 1W 以内——这是一个非常实际的工程优化课题。
七、写在最后
行为识别这个方向有点尴尬——学术上大家都在卷 VideoMAE、大模型,精度一个比一个高;但落地的时候,大家要的是"够快、够小、够早报警"。
StreamAction 给我的启发是:不要总盯着公开数据集上的绝对精度。实时监控场景里,"早 1 秒报警"比"准确率高 2 个点"有价值得多。流式处理、置信度自适应、早期预测——这些设计在学术论文里可能不显眼,但到了真实场景里就是生死之差。
做毕设的同学如果选这个方向,我建议先拿一个轻量 2D + 时序模型跑通 baseline,然后选一个具体场景去打磨——比如摔倒检测、区域入侵。场景越具体,工作越扎实,答辩的时候故事也越好讲。
大家如果有复现上的问题或者想聊具体的监控场景落地,欢迎评论区交流。