

作者 | 程进· 编辑 | 杨越
你每天在用的 ChatGPT、Claude、开源的 Mistral,或者自动驾驶系统里的视觉大脑,它们在本质上,难道是一模一样的“克隆人”?
就在最近,一条引发广泛讨论的推文写道:
“研究人员证明,地球上每一个 AI 模型,暗地里全都是同一个模型。”
“无论让它写诗、写代码,还是在马路上开车,当科学家切开它们的数学内脏时,看到了不可思议的一幕:1100 多个完全不同的 AI,竟然全都在向着同一个低维几何形状坍缩。”
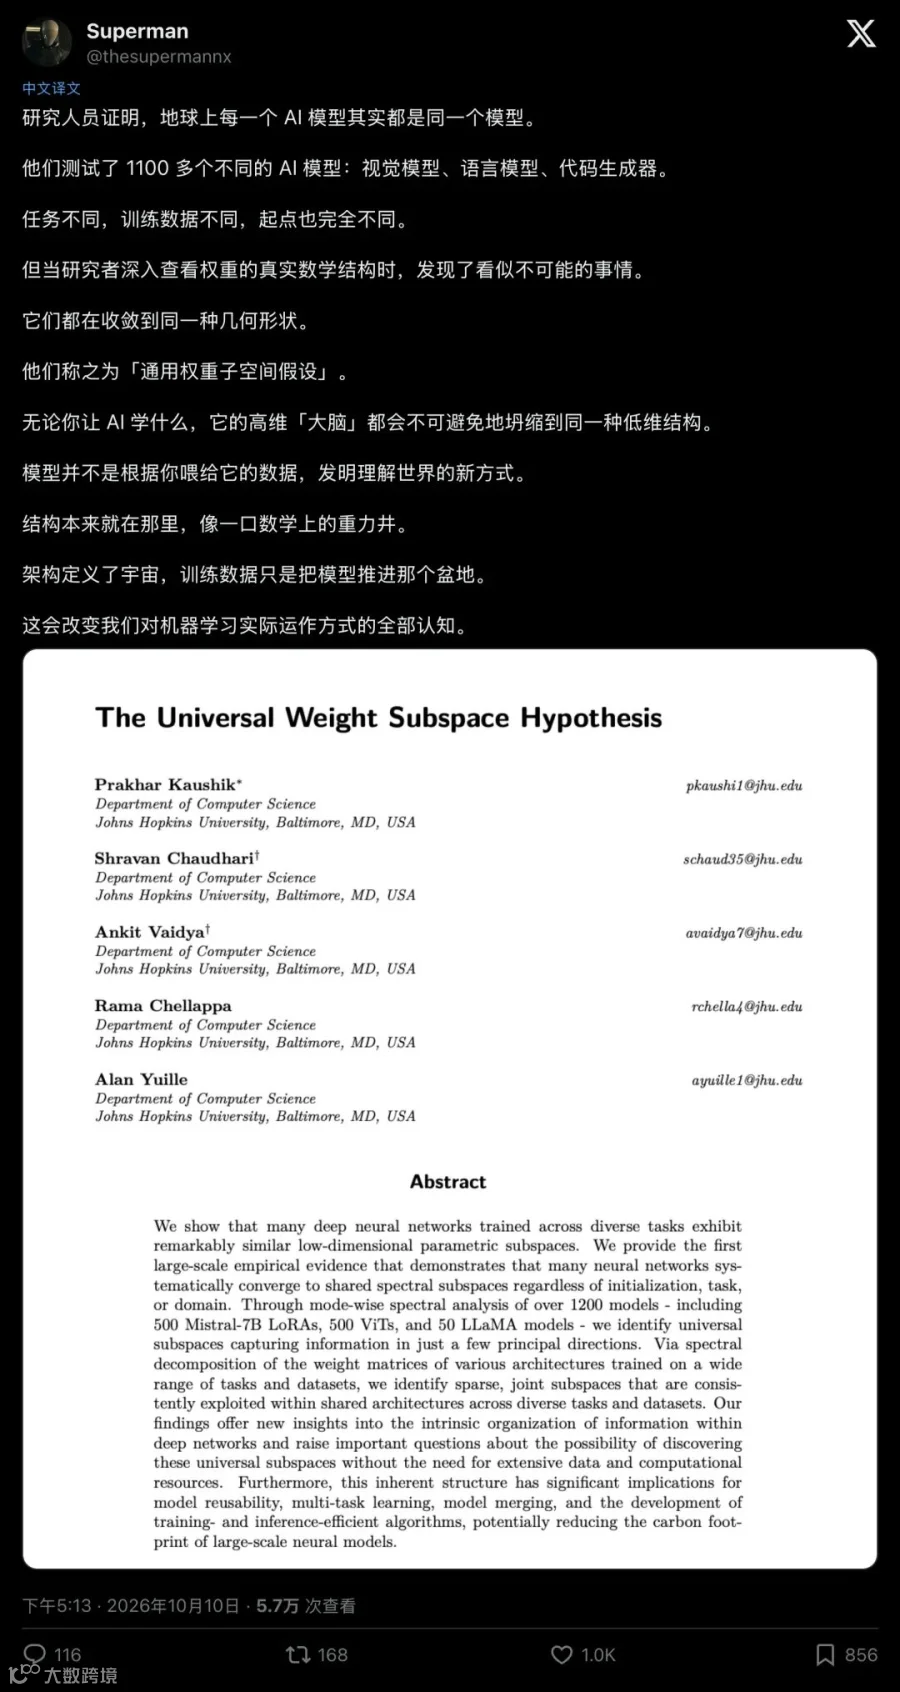
▲ 社交网络上疯传的爆款推文,宣称“所有AI都是同一个模型”
无数人被吓傻了
有人惊呼人类终于触碰到了“智能的普适引力井”;
有人感叹这证明了柏拉图的世界存在;
还有人陷入了技术困惑:如果耗费巨资训练出的几千个大模型,本质上只是同一个几何结构的延展,那全球数千亿美元的算力投入,到底意味着什么?
真相究竟如何?
顺着这篇备受瞩目的论文,我们还原这场讨论背后的学术现场。
01惊天假设:当 1100 个 AI 被推进“CT机”
故事的起点,来自全球顶尖名校的一篇预印本论文。
约翰霍普金斯大学(Johns Hopkins University)的计算机科学团队,在预印本网站 arXiv 上发布了一篇论文,题为《通用权重子空间假设》(The Universal Weight Subspace Hypothesis)。
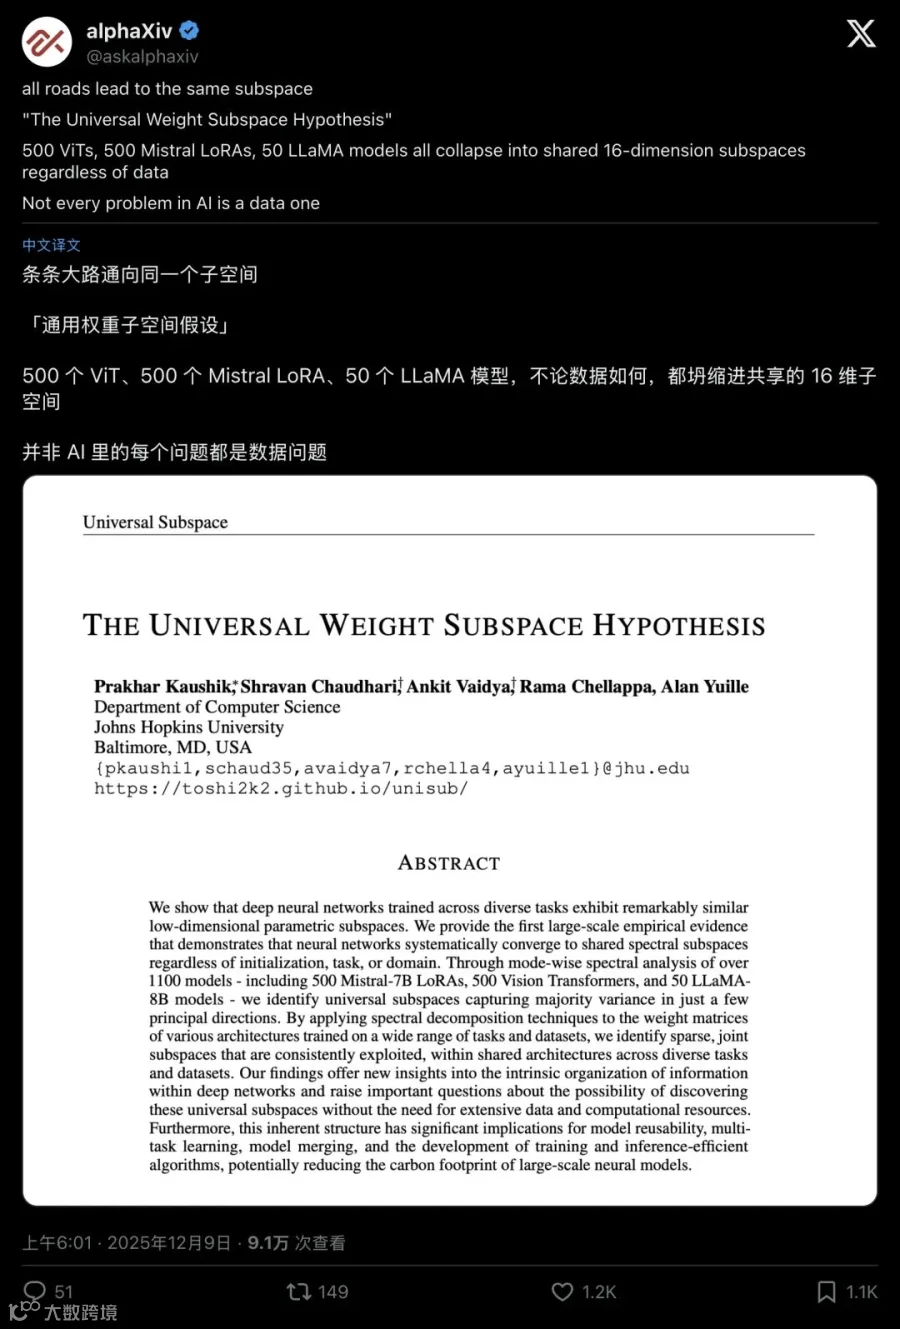
▲ 知名学术分享账号第一时间解读:所有道路,通往同一个子空间
带领团队的,包括计算机视觉界的泰斗级学者 Alan Yuille 和 Rama Chellappa。
这群硬核科学家决定干一件前所未有的苦差事:
他们一口气抓取了 1100 多个被彻底训练好的神经网络。
这其中有在几亿张图片里摸爬滚打过的 500 个视觉 Transformer(ViT),有专门用来做逻辑推理、文学创作、写代码的 500 个主流大语言模型(Mistral-7B),还有 LLaMA、GPT-2 和经典的卷积网络 ResNet。
这些模型的任务完全不相交:一个在识别肿瘤切片,一个在用 Python 刷 LeetCode,另一个可能在教小学生背唐诗。
按照传统机器学习的认知,每一个大模型都是一个拥有几百亿甚至上千亿参数的“高维庞然大物”。
想象一下,一个模型就像一架拥有几百亿个旋钮的巨大控制台。
既然大家经历的训练数据不同、初始状态不同、任务目标千奇百怪,按常理推断,每个模型调出来的旋钮组合,应该是高维空间里漫天飞舞的流星,彼此相距十万八千里。
但当团队对这 1100 多个模型的参数矩阵进行拉伸、拼接,并扔进数学工具箱里做奇异值分解(SVD)时,仪器吐出的谱分析曲线,让整个实验室瞬间安静了下来。
所有的参数摆动,没有漫天飞散
相反,哪怕任务天差地别,几乎所有模型的权重变化,都被一股看不见的数学引力死死拽住,不可思议地挤进了一个狭窄的几何结构里。
科学家们把这个现象,命名为通用权重子空间(Universal Subspace)。
02神秘数字 16:所有智能都住在一个盒子里?
论文一出,科技圈的自媒体彻底狂暴了。
在随后的二次传播中,复杂的线性代数公式被迅速过滤掉,最后只剩下一个极具魔力的数字:16 维。
各大博主开始制作各种绚丽夺目的信息图,配上充满戏剧张力的文案:
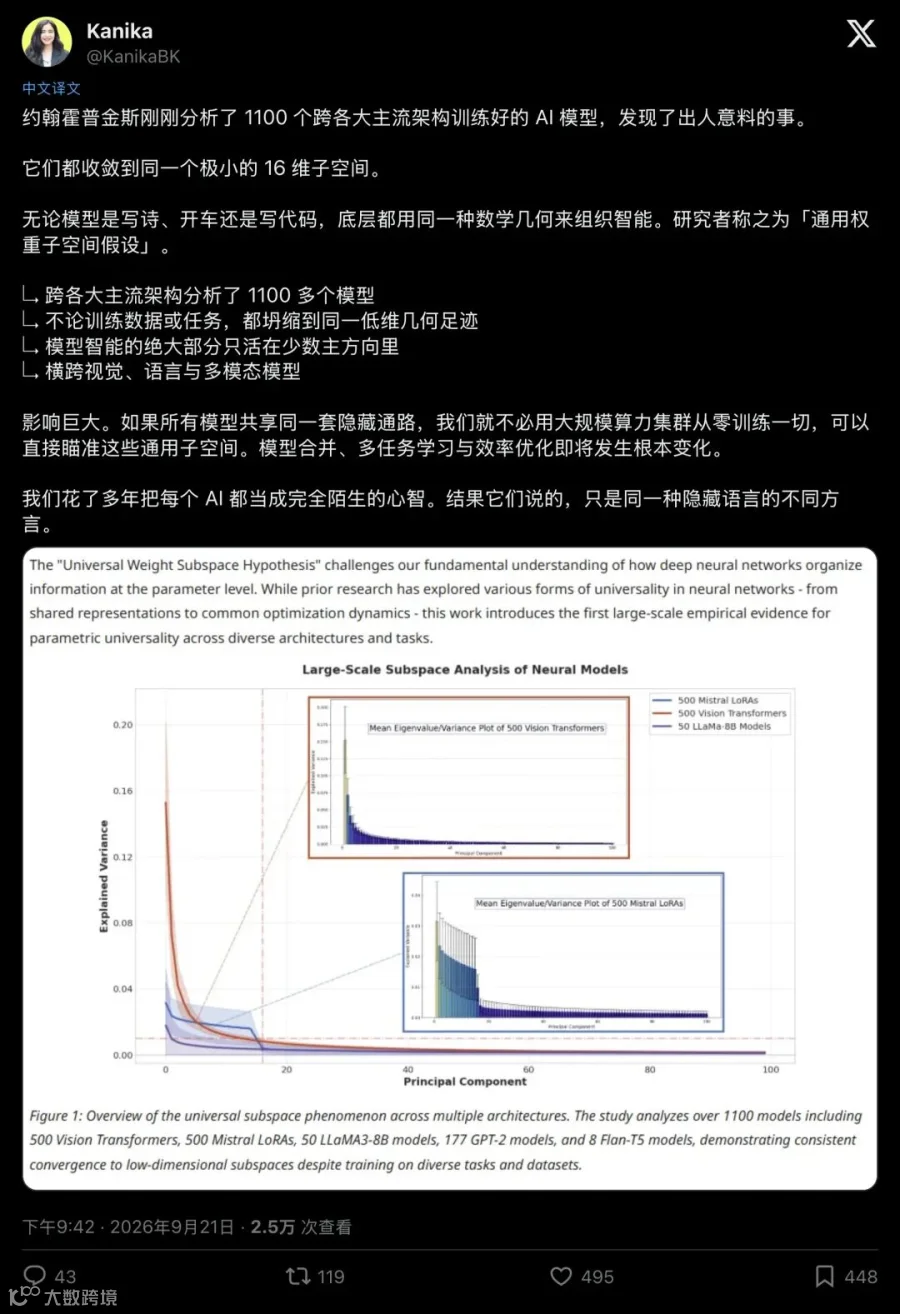
▲ 自媒体账号跟进狂欢:宣称无论写诗、开车还是写代码,AI全都挤在16维里
“不管 AI 是在高速公路上行驶,还是在深夜写十四行诗,其核心参数结构,只需要 16 个主方向就能装下!”
“架构定义了宇宙,训练数据只是把模型推进了这个重力井!”
普通读者看完难免惊异:难道所有智能模型的底层,真是一个只有 16 维的几何常数?
在社交平台的一片惊叹声中,一线技术人员给出了冷静的剖析。
数据工程师 Gul Saeed Khattak 在讨论中留下了一个形象的比喻:
“同一座车库,不同的行驶路线,车本身各不相同。”

▲ 数据工程师 Gul Saeed Khattak 给出形象比喻:同进一座车库,开出的却是完全不同的车
随后,多位研究者在社交平台上贴出了补充说明与技术限制。
如果剥离夸张宣传,回到论文本身,便会发现:“所有 AI 都是同一个”这种说法,实际上忽略了三个关键的前提条件。
03技术还原:拆解三个关键事实
要看清这场风暴的本质,其实高中数学里的几何直觉就足够了。
第一个事实:所谓“16维”,纯属人为设定的截断口径
自媒体高喊的“16”,在数学上不过是奇异值分解中的一个截断口径。
当研究人员把 500 个模型的权重矩阵拼成一个联合巨阵 $\mathbf{W}^{(l)}$ 时,他们发现奇异值(可以通俗理解为这个维度所承载的方差比重)出现了极其尖锐的幂律衰减。
前几个方向很强,后面的方向迅速变弱。
在某些特定的网络层中,前 16 个主成分确实能解释很大一部分方差。
但论文的技术附录写得清清楚楚:在很多关键网络层(比如深层注意力机制和全连接层),即便利落截取 40 个维度,解释方差也仅仅只有 35% 到 50% 之间!
剩下的 50% 甚至更多方差,分散在几百个微小却致命的“长尾方向”里。
把“前 16 个方向比较明显”,硬生生传成“智能只需要 16 个维度”,就像是把“人体 60% 都是水”,直接翻译成“所有人其实都是一滩自来水”一样荒诞。
同时需要看清:权重方差绝不等于模型智能。
占方差 1% 的那些极其冷门的权重波动,恰恰可能是模型能够准确辨识毒蘑菇、写对最后一行关键代码的关键分水岭。
第二个事实:500个模型本就派生自同一个基础权重
论文里研究的那“500 个 Mistral 大语言模型”,到底是从哪儿来的?
答案是:它们全是 LoRA(低秩适配器)微调模型。
这就把底牌掀开了
LoRA 技术本身,就是在原有大模型的基础旁路,硬性安插两个极其扁平的低秩小矩阵。
它在数学公式上从一开始就规定了,模型的更新必须死死限制在极少数的维度里(通常秩 $r$ 就设为 8 或 16)!
在这项实验中,这 500 个模型微调时,挂载的都是同一个开源基座模型,Mistral-7B。
换言之,这些模型并非在真空中独立诞生,而是依托同一套预训练权重展开局部调整。
既然大家都是从同一个基座权重出发,用同一种算法在周围做微调,那么它们的参数更新必然挤在原点附近的局部切空间里!
这并不能推导出从零训练的全新模型也会落入相同子空间。
第三个事实:架构不同,子空间彼此独立
论文作者在正文和后续讨论中明确强调了一个前提:架构依赖(Architecture-dependent)。
视觉模型 ViT 找到的所谓子空间,和语言模型 Mistral 找到的子空间,在几何坐标上毫无任何对应关系。
不仅跨模型不通,就连同一模型内部,第 1 层的子空间和第 20 层的子空间,也完全是两个互不相识的世界。
所谓的“大一统”,瞬间被局限在了极小的边界内:在同一种架构、同一套预训练参数骨架下进行小修小补的微调,AI 确实倾向于在几个固定的房间里挪椅子。
至此,围绕“所有 AI 相同”的过度神化,在严谨的技术事实面前不攻自破。
然而,探索并没有到此结束
在后续的开源复现与极限测试中,工程师们观察到了一个出人意料的特殊现象。
04深夜实验:99% 几何全毁,AI 竟然还在写代码?
独立实践者 Steven A. Thompson 在自己的开源项目 WIZORB 中,决定对这套“通用权重子空间假设”进行一场极限抗压测试。
如果这个假设是真的,即同架构下存在一套通用的基底,我们只要找到这组基底,以后训练新模型,就再也不用几万张显卡乱跑了,只需要在这个极小的子空间里填入几颗系数就行。
他收集了一批写代码的 LoRA 适配器,提取出了全局共享基底,然后做了一个极其暴力的实验:
他把一个原本写代码极其强悍的完整适配器,强行投影到提取出的低维基底上,把所有不在基底里的参数统统砍掉。
当他在显微镜下测量这套新权重时,几何测量仪器全线亮起红灯:
相对 $L_2$ 误差高达 98% 到 99%!
在空间几何的意义上,这个权重矩阵已经被彻底“拧成了麻花”,和原来的高精度模型相比,它几乎面目全非,就像被卡车压过的一块烂铁。
按照传统的工程直觉,模型此时应该彻底胡言乱语,输出一堆乱码。
然而,当他把这具几乎被砸烂的“弗兰肯斯坦”接入代码评测基准时,奇迹发生了:
模型的代码能力,竟然几乎完好无损地保留了下来!
它依然能看懂复杂的 Python 逻辑,依然能精准修复 Bug。
对比实验表明:提取出的主方向具备明确的物理意义,确实承载了模型的功能骨架。
这就是被 Thompson 称为“投影悖论”(Projection Paradox)的诡异现实:
高维权重空间里的几何精确性,与大模型输出的宏观智能功能,竟然发生了极其严重的解耦!
这就好比一个人遭遇了可怕的物理事故,身体 99% 的骨骼坐标都被打乱重装,外表看起来宛如抽象派雕塑,但他一开口,不仅神志清醒,甚至还能当场打草稿解出偏微分方程。
这一幕给全体 AI 研究者带来的震撼,甚至远远超过了自媒体编造的谣言:
大模型的内部机制展现出极强的鲁棒性。
传统工程观念往往倾向于认为微小扰动就会破坏性能;
然而实验显示,高维权重空间存在大量低敏感度冗余,核心功能可能主要凝聚在极少数具备拓扑稳定性的低维几何结构之中。
05终局推演:AI的“MP3时刻”,还是灾难的单点故障?
褪去社交媒体上的夸张渲染,约翰霍普金斯大学这项研究的实际技术价值逐步显现。
尽管没有印证“所有模型源于同一灵魂”的猜想,它依然给产业落地带来了深刻启发。
这是大模型工业的“MP3 时刻”
二十年前,音乐文件动辄几十兆,MP3 编码技术横空出世:它精准识别出人耳听觉冗余,大幅缩减频段数据,将音乐文件压缩至数兆字节,从而开启了数字音乐普及时代。
现在的万亿大模型,正如当年臃肿的 WAV 原始音频文件。
如果同架构下的多任务更新,本质上只是在这组共享的“通用子空间”里调整音调,那么整个模型的存储、传输和计算逻辑将被全盘颠覆:
- 极限制冷存储
:未来的公司或许再也不用为 1000 个业务线保存 1000 套几百 GB 的模型,我们只需要存储一套公用的“通用基底”,每个业务线只分发几十 KB 的轻量系数; - 模型权重的算术化合并
:过去将多个模型直接融合往往面临特征冲突与性能下滑;如果在统一的子空间坐标系内操作,模型融合便有望转化为清晰的向量运算。
但在广阔的工程前景之外,这项机制也揭示了系统性的安全隐患。
如果一个大模型家族真的在反向传播的驱动下,不可避免地滑入同一片重力盆地,这就意味着:
它们正在继承完全相同的盲区、完全相同的偏见、以及完全相同的脆弱性。
在农业上,这叫单作危机(Monoculture),如果全世界的农田里种的都是同一种基因的水稻,那么只要一种特定的病毒袭来,全球粮食系统就会在一夜之间彻底崩溃。
在 AI 领域亦是如此
如果全世界成千上万个基于某开源架构微调的医疗 AI、法律 AI、金融控制系统,其底层权重本质上都挤在同一个由架构决定的狭窄小房间里,那么:
一旦某位黑客顺着这个共享子空间的几何盲区,精心构造出一个恶意的对抗样本(Adversarial Attack),这个攻击指令可能会像幽灵一样,穿透全球所有看似独立、实则同构的“智能系统”。
将模型权重的局部收敛简单等同于“AI意识同源”,显然脱离了客观事实。
这项研究从更深层次敲响了工程警钟:
它提醒整个行业:即便数以千计的模型在不同下游任务上各显神通,只要它们底层共享相同的架构与预训练骨架,就始终在同一套数学边界之内运转。
