

 xerj简介
AI/ML
XERJ 是一个用 Rust 编写的本地 AI 搜索引擎,能够自动索引任意文件夹中的代码、文档、日志等文件。它主要解决 AI 编程助手在处理大型代码库时因上下文窗口有限而大量消耗 Token 的问题,通过提供精准的代码片段检索替代传统的逐文件读取或 grep 搜索,显著降低 AI 编码成本并提升准确率。
它兼容 Elasticsearch REST API,支持全文、向量和混合检索,并提供原生 MCP集成,可直接作为 Cursor、Claude Code 等 AI 编程工具的搜索后端。同时,它还具备增量索引、AST 感知解析和 Agent 长期记忆等能力,适用于参考编码、安全审计、RAG 等多种场景。
 亮点特性
01极致节省 Token
实测表明,相比 grep 驱动的方式输出 Token 减少 2.7 倍,相比纯记忆方式减少 26 倍,且保持相同的任务解决率
02零配置自动索引
只需指向一个文件夹,系统会自动识别代码、PDF、CSV、SQLite 等格式,并利用 tree-sitter 提取 AST 符号和行号进行索引
03完全兼容 Elasticsearch API
通过了 1369 项兼容性测试中的 1366 项,现有的 Kibana、ES 客户端库均可直接连接使用
04原生 MCP 支持
内置 13 个 MCP 工具,无需额外插件即可让桌面 AI 助手直接调用搜索、向量检索和记忆功能
05单文件无依赖部署
由 Rust 编写,编译为单一静态二进制文件,无需 JVM,支持离线环境部署
 使用场景
场景 1参考编码
在编写代码前,让 AI 助手检索相似开源项目的实现方式,减少重复试错和 Token 消耗
场景 2代码库问答与 RAG
对私有仓库建立索引,通过语义搜索精准定位函数定义和代码逻辑,而非返回整个文件
场景 3安全审计与日志分析
跨多种文件格式统一查询危险调用、敏感信息泄露或异常日志模式
场景 4AI Agent 长期记忆
利用内置命名空间存储 Agent 学习到的知识,并在后续会话中按语义召回
场景 5轻量级 Elasticsearch 替代
在单机环境下使用单一二进制文件运行兼容 ES API 的搜索引擎
 快速上手
安装
XERJ 是单一静态二进制文件,无需 JVM 或其他依赖,支持 Linux、macOS 和 Windows。
Linux / macOS:
|
Windows PowerShell:
|
启动服务与索引项目
|
核心用法示例
1. 命令行搜索与跳转定义
|
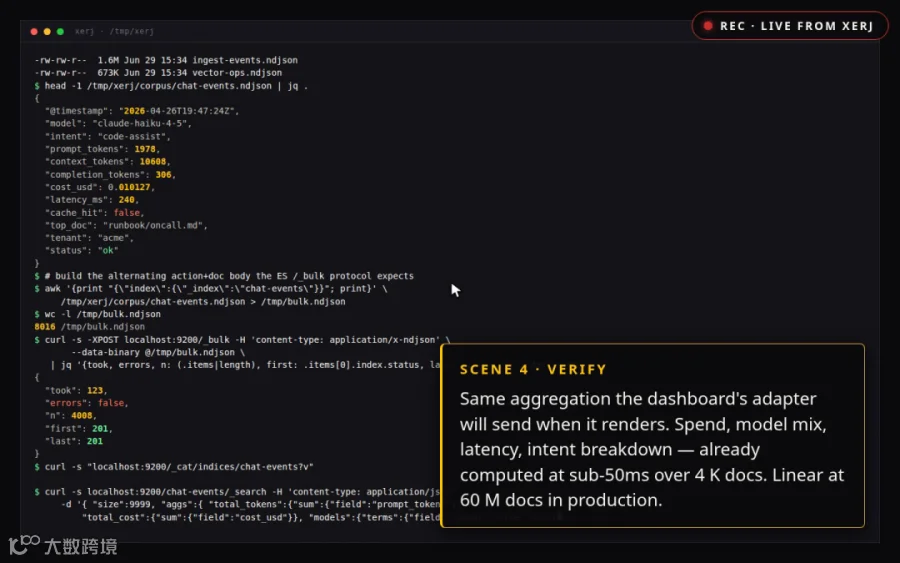
2. 兼容 Elasticsearch API 查询
|
3. 接入 AI 编程工具(MCP 配置)
在 Cursor 或 Claude Code 等支持 MCP 的客户端中添加以下配置:
|
 替代方案
对比 1Elasticsearch / OpenSearch
XERJ 兼容其 API,但 XERJ 是单二进制文件,无需 JVM,部署极轻,专为本地 AI 检索优化;而 ES 更适合大规模分布式集群生产环境
对比 2Qdrant / Milvus
专业的向量数据库,适合纯向量检索场景;XERJ 则融合了 BM25 全文检索、kNN 向量检索和混合检索,且自带多格式文件解析能力
对比 3Bloop / Sourcegraph
面向开发者的代码搜索工具,侧重于人类开发者的 UI 交互体验;XERJ 更侧重于作为 AI Agent 的后端基础设施,提供 MCP 接口和 Token 优化
 相关资源
项目地址github.com/xerj-org/xerj
文档xerj.org/docs/cli.html
演示xerj.org/aise-demo.html