

📝 英文题目:From revision to learning transfer: Self- and socially shared-regulated pathways in AI-assisted feedback
📚 来源期刊:Learning and Instruction
🗓 发表时间:2027-02
✍ 作者:Shijun (Cindy) Chen, Conrad Borchers, Christian D. Schunn
🏆 期刊等级:SSCI Q1 · JCR Q1 · 中科院 教育学1区 · TOP 教育学TOP · Scopus
📌 本文看点
01
AI 辅助反馈
02
学习迁移
03
自我调节学习
BACKGROUND
研究背景
问题提出
生成式 AI 已经改写了写作反馈的供给方式,但一个关键机制问题一直悬着:学生跟 AI 反馈打交道、照着改稿,带来的到底是「这一稿改好了」(即时表现),还是「下一篇也写得好」(学习迁移)?前人研究大多只盯单一反馈模式、只看当下修改质量,长期迁移几乎没有被追踪过。也就是说,AI 反馈的「学习效应」这条链——投入怎么变成修改、修改怎么变成迁移——一直是断的。
难点剖析
难点有三:① 得把「表现」和「学习」干净地拆开——操作化上,即时修改 = 同一任务二稿与初稿的分数差,学习迁移 = 下一任务(新题目)初稿的成绩,两者不能混;
② 投入深度要可编码、可跨条件比较——两种条件的教学活动本来就不同,编码框架必须用同一把尺子;
③ 数据是重复测量嵌套结构(学生嵌套学校、任务多次重复),需要混合效应模型而不是简单组间比较。
理论脉络
理论拼图三块:① 自我调节学习(SRL)——个体学习走「计划(forethought)→ 执行(performance)→ 反思(reflection)」的循环;
② 社会共享调节学习(SSRL)——小组共同监控、共同加工反馈,调节责任由群体分担;
③ 认知投入的 ICAP 框架——按生成性从低到高分被动、主动、建构、互动四层,层级越高学习越好。AI 辅助自评反馈(AISF)天然框在 SRL 里,AI 辅助同伴互评(AIPF)天然框在 SSRL 里,这正好给两种条件各自的「学习路径」提供了理论预测。
METHOD
研究方法
理论模型
概念框架(见模型图):投入(Engagement,对应计划与反思)→ 修改(Revision,对应执行)→ 学习(Learning,对应反思-下一轮计划)。两条路径并存:AISF 走个体 SRL 循环——线性、成绩依赖,学习跟着「投入深度 × 修改幅度」走;AIPF 走 SSRL 路径——同伴对话中介、有韧性,学习不依赖个人投入与修改水平。研究问题两个:RQ1——AISF 与 AIPF 在 AI 投入、即时修改、长期学习迁移上的相对效应如何?RQ2——AI 反馈投入与即时修改成绩,在两种条件下是否同样预测学习量?
研究问题
RQ1:AISF(AI 辅助自评反馈)与 AIPF(AI 辅助同伴互评)在「与 AI 的投入、即时修改表现、长期学习迁移」三方面有何相对差异? RQ2:与 AI 反馈的投入、使用 AI 支持反馈的即时修改表现,在 AISF 与 AIPF 两种条件下是否以相同方式预测学习量?
分析策略
16 周整群随机实验:班级层面整群随机分入 AISF 或 AIPF。分析用线性混合效应模型(学生嵌套大学的随机截距):① 条件差异——投入均值比较、修改增益建模(控制前测)、滞后模型(上一任务初稿分 + 条件 → 下一任务初稿分)捕捉跨任务迁移;
② 机制——投入 → 即时修改、修改 → 迁移、以及投入+修改+条件及其交互的整合模型。投入先按五级连续处理,再按「低(1–3 级)/ 高(4–5 级)」二分,与连续线性、二次规格做 AIC/BIC 与似然比检验比较——结果呈阈值样模式,故主分析用二分。效应量报 Cohen‘s d。
DESIGN
实验设计
数据收集
中国中东部两所理工类高校,商务英语专业必修英语写作课(全部通过 CET-4,约 CEFR B1+–B2)。每校一名教师的多个教学班中各取两个班参与,班级整群随机分组。全程 16 周,每人完成 10 个写作任务:1 个课堂手写前测 + 4 个形成性任务(每个含初稿与修改稿)+ 1 个后测;全部为议论文(250–300 词),题目取自学生未接触过的 TEM-4 历年真题以保证任务等值、考察迁移。两条件共用同一套 AI:DeepSeek R1-0528(DeepThink),用嵌入写作量规的角色设定提示引出反馈。AISF:学生自己向 AI 提问(AI 分别扮演有经验教师和更强同伴)、填结构化自评反思表;AIPF:三人小组(两评一收,角色轮换),先由评阅者引出 AI 意见,小组共同评估 AI 反馈并讨论,再填同伴反思表。
研究样本
初始 123 名本科生;110 人完成全部写作任务进入成绩分析(AISF 51 / AIPF 59,保留率 89.4%);108 人完成全部反思表进入投入分析(AISF 51 / AIPF 57,保留率 87.8%)。分析样本共 1100 个写作分数(含前测、四个任务的两稿、后测)与 432 份 AI 反馈反思表。
测量工具
① 写作评分:DeepSeek-V3.2 + 标准化提示(角色设定 + few-shot 示例,经 ChatGPT-4.0 与两位写作教师迭代、两位 AI 专家验证),每篇独立评三次取均值;先用 62 名学生的作文与两位专家双评对照校准(Spearman rs=0.84, p<.001),全量重复评分一致性 ICC=0.97。修改增益 ΔJ = 二稿分 − 初稿分。
② 投入编码:432 份反思表按五级编码(1 无投入 / 2 被动采纳 / 3 选择性判断 / 4 策略性推理 / 5 元认知或社会共享性认识),取每份反思表现出的最高认知层级;演绎(反馈素养、GenAI 反馈投入模型)+ 归纳双路编码,两名研究者独立编码约 20%,Cohen‘s κ=0.71,分歧讨论解决。
RESULTS
结果与分析
核心发现
RQ1 三组对比(学-绩脱钩是全文之眼):① 投入:AIPF 略高于 AISF(M=3.37 vs 2.97,F(1,106)=8.92, p=.004, d=0.35);但高投入(4–5 级)比例几乎持平(42% vs 40%,p=.61)。整体投入中等(M=3.18,中位数 3),高投入只出现在 41% 的任务上。
② 即时修改:两组无差异(β=0.08, 95% CI[−0.12, 0.28], p=.42)——平均修改增益 +7.12 分,AISF 94.6%、AIPF 96.6% 的任务为正增益。二稿一样好。
③ 学习迁移:AIPF 显著更高(β=0.30, 95% CI[0.08, 0.51], p=.006,控制前次表现后)。优势出现在「下一篇」,不在「这一稿」。
分项结果(RQ1/RQ2)
机制三条(RQ2):
① 投入 → 即时修改:主效应显著(β=0.09, 95% CI[0.01, 0.16], p=.024),但与条件交互显著为负(β=−0.13, p=.034)——正效应只存在于 AISF;投入与修改呈阈值样模式(非线性、非二次),高投入(4–5 级)才带来更大修改增益。
② 修改 → 迁移:修改增益显著预测下一任务初稿(β=0.32, 95% CI[0.20, 0.44], p<.001),但与条件交互显著为负(β=−0.28, p=.001)——AISF 改得多才学得多;AIPF 在各种修改水平下迁移都高。
③ 整合模型:投入(β=0.26, p=.041)与修改增益(β=0.29, p<.001)都独立预测后续表现,条件效应仍显著(β=0.26, p=.018)——控制投入与修改后,AIPF 仍占优;修改 × 条件交互 β=−0.25(p=.002)。一句话:AISF 的学习是「成绩依赖」的——投入和修改缺一不可;AIPF 的学习不是。
CONCLUSION
总体结论
研究结论
「改得好」和「学得到」是两回事——这就是本文最硬的发现:两种 AI 反馈条件产出了同样强的二稿,但只有同伴互评组把能力迁移到了下一篇。机制上分岔成两条路:AI 自评组(AISF)走成绩依赖的 SRL 循环——投入必须够深(建构性加工,而非照抄 AI 意见)、修改必须够实,才换得来迁移,且呈阈值效应,浅投入学不到东西;AI 同伴互评组(AIPF)走 SSRL 路径——共同评估 AI 意见、讨论采纳理由、协商分歧,把写作标准的理解「共建」了出来,学习不依赖个人修改量和 AI 投入深度。给教学的提示:别把 AI 当「反馈打印机」,把它当认知刺激——嵌进结构化的「起草-重写循环 + 同伴对话」里,AI 反馈的长期价值才出得来。
研究局限
① 机制归因受限:AIPF 条件同时打包了同伴解释、协作讨论、相互问责、反馈生成等多个特征,无法把「社会共享调节」从其他协作机制里单独剥离出来;
② 情境特殊:商务英语专业、中国两所高校、写作单科,向其他学科、学段、文化的推广待检验;
③ 投入测量靠反思表,取的是最高认知层级,未捕捉频率与一致性,也缺过程数据(AI 交互日志、提示历史、修改轨迹、同伴讨论转录);
④ 干预与评分都用 AI(不同模型版本与提示,且 AI 分数与专家评分高一致),共享方法效应虽被缓解但不能完全排除;
⑤ 保持间隔短(约一周),迁移的持久性未知。
未来展望
用延迟后测或跨学期迁移任务检验 AIPF 优势在撤除脚手架后是否持久;用更受控的实验设计把社会共享调节与同伴解释、对话互动、精细化加工等协作机制分离开;整合 AI 交互日志、提示历史、修改痕迹与同伴讨论转录等过程数据做更完整的投入刻画;将 AISF/AIPF 与传统反馈(教师/同伴/自评)及无脚手架的 GenAI 反馈做对比;用独立人评或不同模型家族的评分模型排除共享方法效应。
金句
二稿改得一样好,不代表学到一样多——真正把能力带走的,是那组一起讨论 AI 意见的学生。
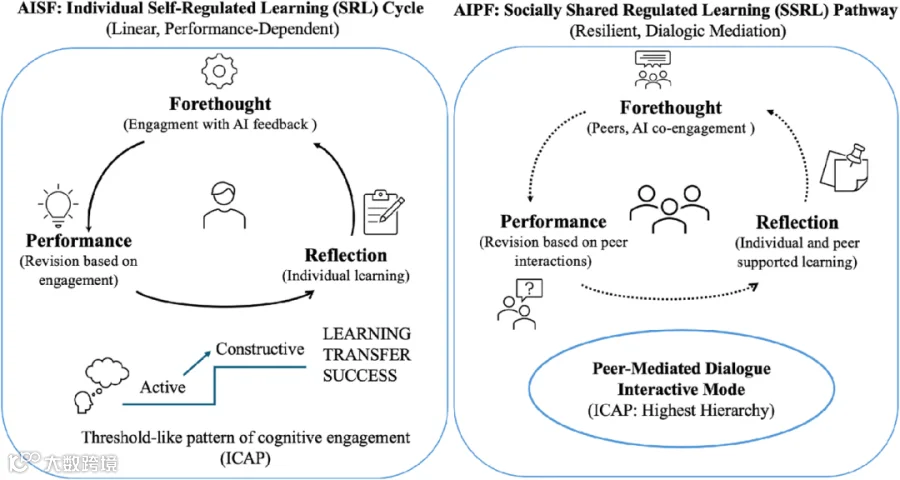
— 研究模型图
📄 摘要原文
Background: Generative artificial intelligence (GenAI) has transformed feedback provision in writing practices. However, little is known about the mechanisms through which AI-mediated engagement and revision contribute to longer-term learning transfer. Research aims: Framed by theories of self-regulated learning (SRL), socially shared regulated learning (SSRL), and cognitive engagement, the study examined the relationship among engagement, immediate revision gains, and longer-term learning transfer in AI-assisted feedback. Methods: This 16-week cluster-randomized experiment involving 108 undergraduates in China compared two feedback modes: AI-assisted self-feedback and AI-assisted peer feedback. Analyses drew on 1100 writing samples (including pretests, four assignments with two drafts each, and posttests), and 432 reflection forms on AI feedback. Findings: Linear mixed models revealed a decoupling of learning and performance: while both conditions produced similarly strong second drafts, AI-assisted peer feedback demonstrated significantly greater learning transfer to subsequent tasks. In AI-assisted self-feedback, learning followed a performance-dependent SRL cycle in which AI engagement and revision improvements independently predicted learning. A threshold-like pattern further showed that benefits emerged only when students engaged constructively, measured by reflection forms, to internalize writing standards. Conversely, AI-assisted peer feedback was associated with stronger learning transfer that was less dependent on revision gains or engagement with AI, a pattern consistent with an SSRL perspective emphasizing interactive engagement and co-constructed understanding. Conclusion: These findings highlight the importance of revision mechanisms and depth of engagement across feedback contexts. The study contributes to theories of regulation and cognitive engagement and offers pedagogical and design implications for fostering meaningful learning through AI-assisted feedback.
📎 阅读原文:DOI: 10.1016/j.learninstruc.2026.102489
END
我是扣子,高校教师/在读博士/AI顾问。关注AIGC,学术科研,博士生活;分享AI赋能和论文带读,打破AI信息差。视频号:扣子说AI。
如需推广论文,请咨询WeChat:Q495428。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
欢迎关注我的视频号
(❤️会不定期更新AI工具哦❤️)
三连一下,不失联!