


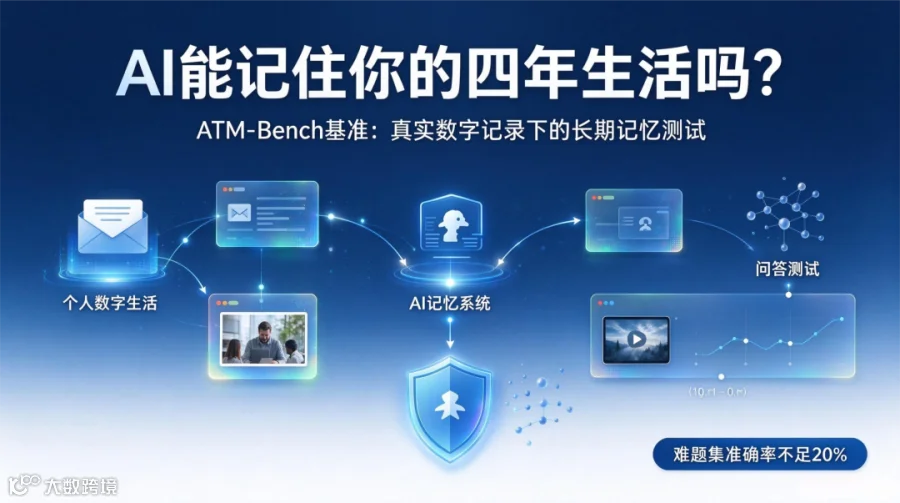
2026 年 3 月,剑桥大学团队发布了一个名为 ATM-Bench 的基准:把一个人约四年、上万条真实数字生活记录,包括邮件、照片、视频,在隐私保护处理后交给 AI,再向它提问关于这个人生活的问题。
团队测试了 5 个目前表现靠前的记忆系统和一套传统的关键词检索方案,结果在难题集上,这些系统的准确率不足 20%。
这个分数低得意外,却不难解释。真实的个人记忆跨时间、跨来源,一个问题的答案可能散在三年前的一封邮件、上个月的一张照片和某段视频的对话里,需要把多条证据串起来推理。靠关键词检索,找得到片段,拼不出答案。装下上万条记录容易,从里面回忆出对的那条,很难。
到了今年10月,多家头部模型厂商密集把记忆能力写进新模型的发布稿,Meta 等公司公开表示主动记忆将成为模型的重要组成,记忆开始成为行业集体关注的竞争焦点。
窗口撑得起长度,撑不起理解
过去几年,大模型的军备竞赛有一条清晰的主线:上下文窗口。从几千 token 到几十万,再到百万级,窗口的大小成了发布会上的招牌数字。
但窗口解决的是容量问题,不是理解问题。2023 年的公开研究「Lost in the Middle」给出了一个可复现的结论:长上下文模型对中段信息的利用率显著低于首尾,位置越靠中间,越容易被忽略。窗口是一张更大的桌子,桌子大了,摊开的文件多了,坐在桌前的人未必读得更多。
更现实的问题是成本。把一段业务的对话历史灌进窗口,比按需检索关键记忆贵出几十倍乃至上百倍。窗口撑得起长度,撑不起理解,也撑不起账。
对话即忘,是今天多数 Agent 的共同困境
如果把今天的 Agent 比作员工,他们大多患着同一种病:会话结束,记忆清零。
用户上周说过的偏好,这周要重新交代;客服机器人昨天处理过的投诉,今天从头再问一遍;一个跨了三周的项目,Agent 每次都像第一天入职。问题不在模型不够聪明,而在它没有一个能沉淀经验的地方。
这种「对话即忘」带来双重损耗:
⦿体验上,用户被迫反复自我介绍;
⦿成本上,企业只能用更长的上下文窗口硬扛历史信息,花更多的钱,换更差的准确率。
记忆缺位,正在变成 Agent 落地的一道隐形门槛。
大厂跟进前,AI记忆已成独立赛道
变化的信号已经很明显。2026 年 10 月的集中发布只是表象,更深处是三件事在同时发生:
❖其一,记忆开始有了独立的评测。围绕长期记忆、记忆读写准确率的公开基准陆续出现,ATM-Bench 正是其中之一,记忆能力不再依附于综合榜单,而是被单独打分。
❖其二,记忆开始有了独立的产品形态。从附属于对话的功能,变成可以单独设计、单独优化的系统层。
❖其三,行业叙事在转向。讨论的重心从「窗口能装多少」移向「记忆能留多准」。
一条赛道被单独衡量的时刻,往往就是它开始独立的时刻。判断一个记忆系统好不好,可以看三个问题:记得准不准,取得快不快,忘得对不对。
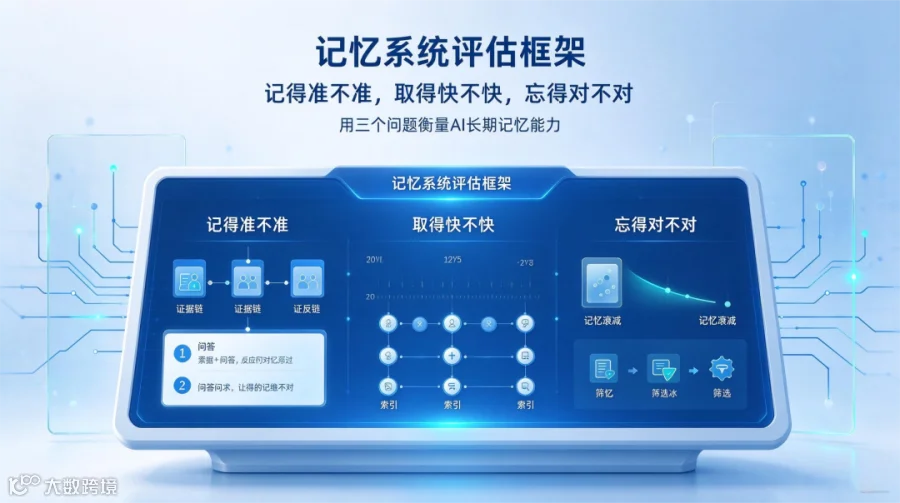
开头的实验里,系统手里握着上万条记录,准确率却不足两成,缺的正是这三件事:没有筛出对的记忆,没有在对的时刻取出来,也没有把过时和无关的信息忘掉。

AI记忆这门课,红熊从模型底层修
在红熊AI的理解里,记忆不是挂在模型外面的插件,不是一套外挂的数据库,而是长在模型里的能力。模型自己决定记什么、怎么取、何时忘,像人的记忆一样,会筛选、会沉淀、会更新。支撑这条路的,是红熊自研的 MemoryBear 类人脑记忆引擎。记忆的筛选、沉淀与更新,由模型底层完成。
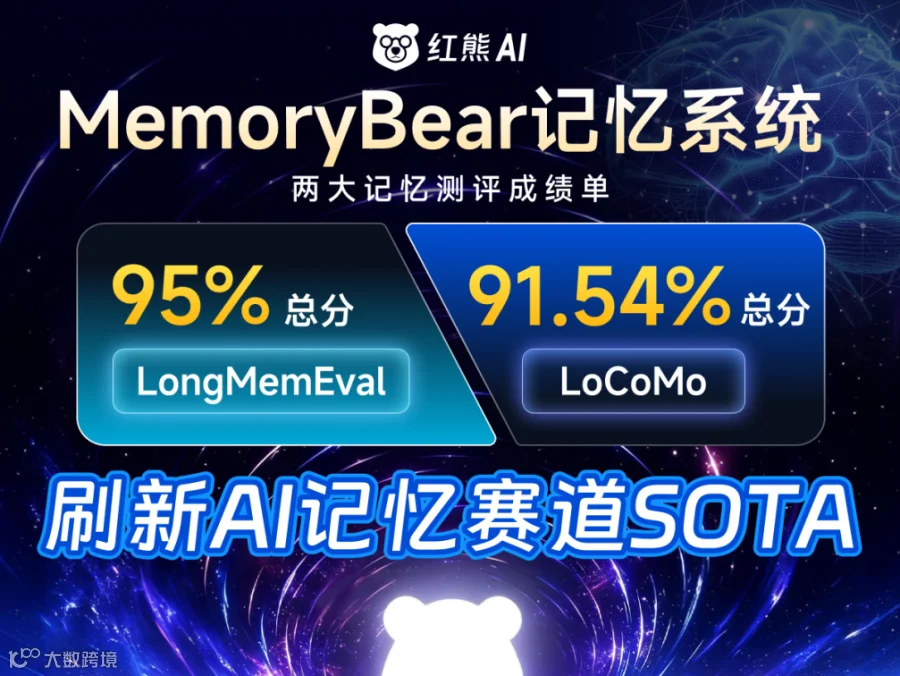
这条路不是只在公司内部被验证。红熊AI记忆科学团队公开了技术论文与白皮书,并在 LongMemEval、LoCoMo 两项国际公开记忆基准上公布了完整的测评结果与复现方式,任何人都可以查证。
这条路更难,要动模型本身的结构,但我们认为这才是记忆该有的形态。在客服与金融行业的共创场景中,这条路线已经给出了一些早期的答案:跨会话任务的关键信息召回明显回升,长周期服务中的重复沟通轮次明显压缩。阶段性的答案还会更新,方向不会变。

窗口的竞赛会放缓,记忆的竞争才刚开始。装下更多,终究要输给记住对的。红熊AI从创立起就站在这条路上,会一直走下去。
如果你正在思考 Agent 的记忆问题,欢迎关注红熊AI,或预约一次记忆技术交流,与我们一起走这条路。
