

AI模型库 · 今日一模
DeepSeek-V4.1-Flash-1017
API 仍叫 deepseek-flash · 价格未变 · MIT 可下
模型卡自报 TB4.0 42.3(旧 31.2)· Search&Fetch $0.75/千次

10 月 17 日下午,DeepSeek 在 X 发了一条帖:V4.1-Flash-1017 上线,网站、App、API 同步切过去。那条帖子截止我写稿时大约 438 万次浏览、近 3 万赞。更值得盯的不是「又发了一个 Flash」,而是两件反差:
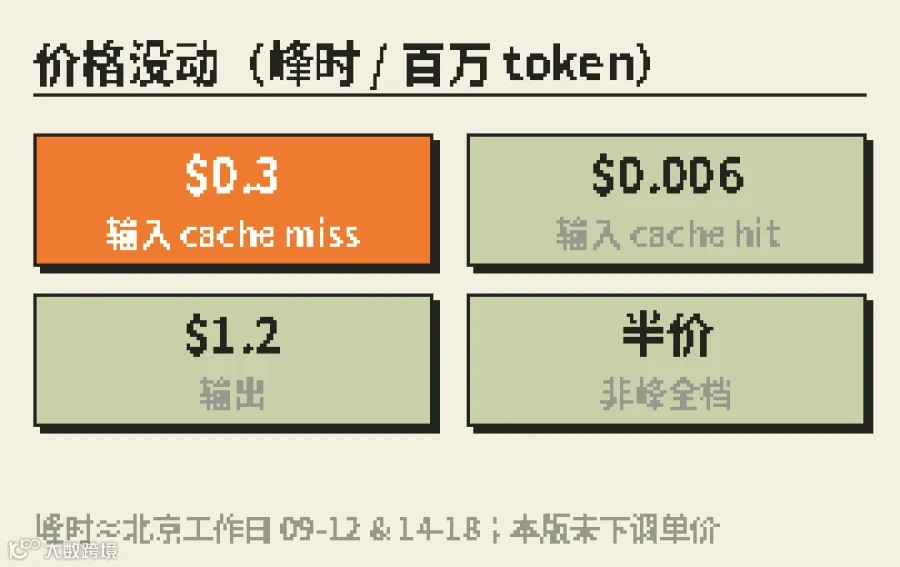
第一,你在代码里写的 model 名还是 deepseek-flash,定价页也没改数字——峰时 cache miss 每百万输入 0.3 美元、cache hit 0.006、输出 1.2;非峰半价。第二,官方自己说这是一次 minor update,但基准、任务完成速度、输出长度都往更好的方向挪了一截,还顺手把 Search & Fetch 全面开放成按次计费的独立接口。
换句话说:接口名字没变,价格没动,后面的模型换了。对已经接好 deepseek-flash 的团队,这更像一次「免改代码的换芯」;账单会不会更低,主要看它是不是真的输出更短——官方文案明确写了 shorter outputs。权重同步挂上了 Hugging Face 与 ModelScope,许可证是 MIT,想自托管或二次分发的人终于少了一层许可纠结。
下面按老规矩拆:它能干嘛,对做应用意味着什么,冷水泼在哪。
01
PART
它能干嘛
WHAT IT DOES
定位仍是 Flash 这一档:推理、编码、Agent、视觉都能碰。模型卡写得很直白——相对旧版 V4.1-Flash,推理、编码、Agent、视觉基准都有明显提升,同时压缩任务耗时和输出长度,想把性能–成本的 Pareto 往外推一截。优化目标点名了 DeepSeekHarness(建议版本 ≥v0.2.1-rc.1)、腾讯 CodeBuddy、WorkBuddy;还提到用强化学习里的 self-feedback,改善「从零做完整项目」的端到端表现。官方演示口径里有从零做游戏、做 3D 这类完整交付,不是只刷单题——这对接 Agent 写长任务的人更有参考价值:你要看的是它能不能收尾,而不只是中间一步对不对。
定价页还列了 Flash 这一档标配能力:支持 thinking / non-thinking 切换、JSON Output、Tool Calls、Responses API、Anthropic API,以及 Chat Prefix 与非思考模式下的 FIM。对已经用工具调用串业务流程的人,1017 更像是「同一套管线换更强的执行层」,而不是让你重写编排。
1M
上下文
384K
最大输出
2500
并发
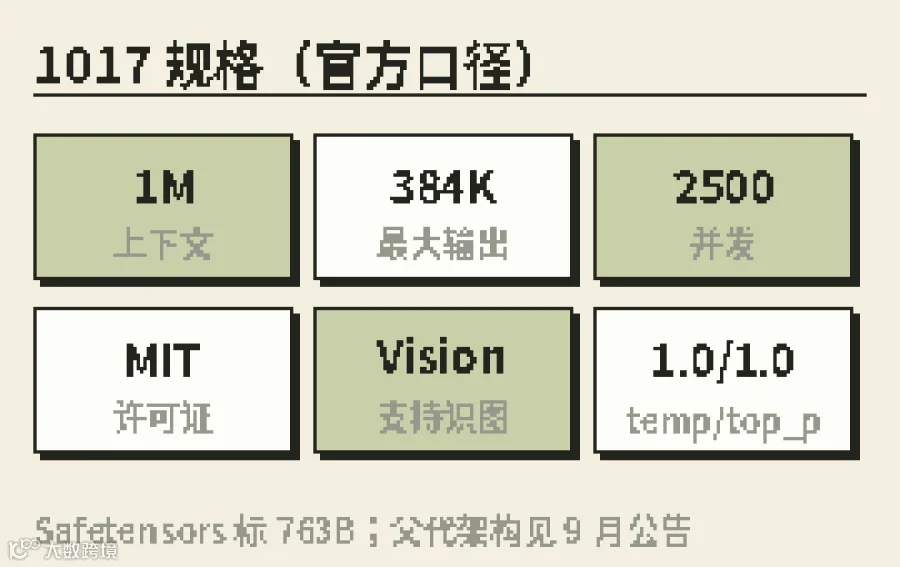
架构参数要分清出处:父代 V4.1-Flash(9 月公告)写过 552B MoE、prefill 激活约 8B / decode 约 16B、KV cache 压缩。1017 这张模型卡没有再单列总参/激活,Hugging Face Safetensors 页标注 Model size 763B——写进规格表时请当成文件级标注,不要和父代 552B 混成「升级到 763B」的叙事。本仓库没有 Jinja 格式的 chat template,编码协议在 encoding/ 目录,生产侧另有 deepseek-recipe。
想本地起推理,模型卡指向 inference/ 目录做权重转换;采样别一上来就抄别家的 0.2——官方推荐就是 temperature=1.0、top_p=1.0,上下文按 1M 规划,单次生成长度建议拉到至少 256K 量级,长任务才不至于中途被截断。
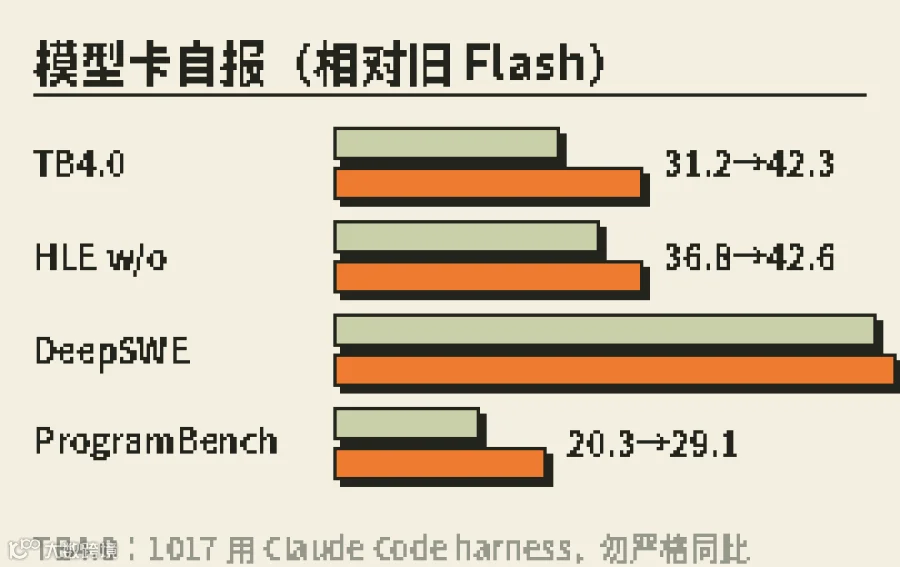
跑分一律当「模型卡自报」。相对旧 V4.1-Flash:HLE(无工具)42.6 vs 36.8;Terminal-Bench 4.0 42.3 vs 31.2;DeepSWE 77.0 vs 74.2;ProgramBench 29.1 vs 20.3;NL2Repo 68.2 vs 65.4;Automation-Bench 60.5 vs 54.8。模型卡脚注写得很关键:1017 的 Terminal-Bench 4.0 用的是 Claude Code harness;旧版编码相关分数可能来自 DeepSeek Harness——不能拿这两个数当严格同比。我把它读成方向信号:官方认为终端/Agent 这条线明显变强了,而不是「绝对领先某闭源模型多少」。
02
PART
对做应用的人意味着什么
WHY IT MATTERS
第一,改一行配置的成本接近零。定价页写明:继续用 deepseek-flash;旧名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 已退役,但请求仍会路由到 1017,并按 Flash 价计费。你昨天的 base_url、昨天的 key、昨天的业务代码,今天大概率不用改。验收重点变成:同一批真实任务,通过率、延迟、输出 token 有没有往好的方向走。
第二,单价没降,用量可能降。新榜有条目把这次写成「下调 API 价格」——请别照搬到 1017。官方口径与公开 changelog 整理都强调 calling method and prices stay the same。峰时仍是那三档;非峰半价;峰时窗口是 UTC 01:00–04:00 与 06:00–10:00 的工作日,换算北京时间大约是工作日 09:00–12:00 与 14:00–18:00,周末和中国公休日全天非峰。若账单变好看,主因应是 输出更短、任务更快,不是单价表动了。做报价单的人,可以单独开一列「同任务输出 token」,别把「换代=降价」写进客户合同。
第三,Search & Fetch 变成可单独买的能力。定价页:Search、Fetch 各 0.75 美元 / 千次成功请求。经 DeepSeekHarness、Claude Code、Codex 走的服务端工具调用,目前免费;北京时间 2026 年 11 月 1 日 0 点起按次计费。现在接 Agent 检索链路的人,最好在免费窗里把调用次数、失败重试、缓存策略跑清楚,11 月别被账单打脸。
视觉能力这次也跟着 Flash 档位保留:定价页 Features 里 Vision 打了勾,旧的 vision-exp 名退役后流量同样进 1017。做截图排障、表格识读、带图工单的流水线,可以在同一 model 名下做回归,不必再维护一套实验模型名。Search & Fetch 开放价 0.75 美元/千次成功请求,适合写进毛利表;免费窗只到 10 月底,别把 Demo 期的调用密度当成长期常态。
第四,权重 MIT,想自托管或二次分发的路径更干净。相对一些「能看不能随便商用」的许可,MIT 对小团队做私有化、做蒸馏数据、做客户侧部署更省事。API 并发上限 2500,对中小流量产品通常够用;真要上大流量,还是得自己压测。
举个落地用法:你已经有一条 deepseek-flash 的客服或编码 Agent 流水线——今天不用换 endpoint,先把回归集里 20 个真实工单重跑一遍,盯三个数:是否解决、耗时、输出 token。若通过率持平或上升、token 下降,这才是「同价换芯」对你账户有意义的证据。官方从零做游戏/3D 的演示,适合当作「长任务能不能收尾」的压力测试模板,而不是直接拿去对客户承诺工期。
03
PART
冷水该泼哪
COLD WATER
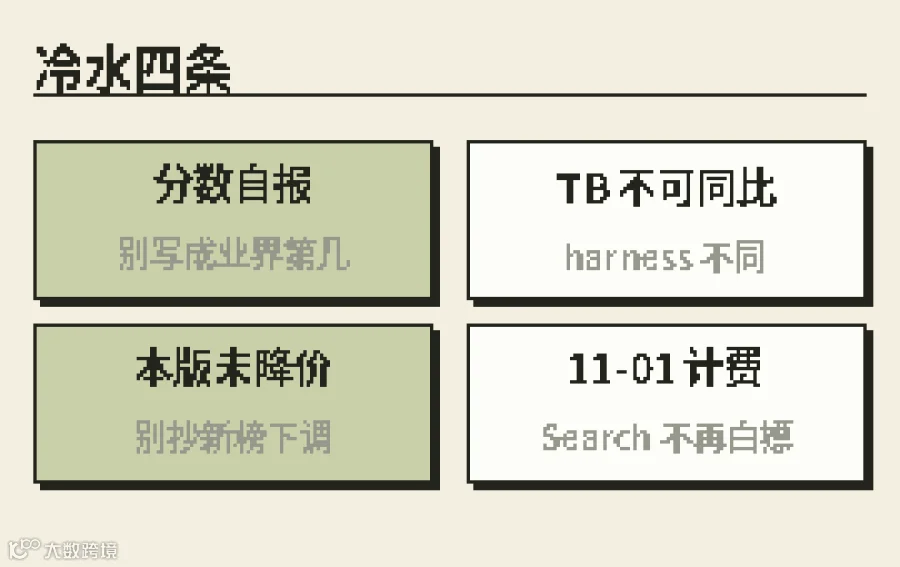
第一盆:这些分数是厂商自报。没有第三方同日复测之前,别把 42.3 写成「业界第几」。对比表里还有 K3、GLM-5.3、GPT-5.6 Sol、Opus 5——那是模型卡排版用的参照列,不是你业务集上的结论。
第二盆:Terminal-Bench 4.0 的 42.3 vs 31.2 不可严格同比。harness 不同,分数差里混着「模型变强」和「评测外壳变了」。对外宣传或对内周报,建议写成「模型卡自报,Claude Code harness」,并附上旧版可能用 DeepSeek Harness 的脚注。
第三盆:本版没有降价。若有人拿 9 月 Flash 相对更早代际的降价当「这次又降了」,请把时间戳掰开。1017 的卖点是同价换芯 + 更短输出,不是价目表再砍一刀。
第四盆:11 月 1 日起,Harness / Claude Code / Codex 路径上的 Search & Fetch 不再免费。现在「工具调用随便开」的 Demo 成本,不等于下季度的运营成本。按 0.75 美元/千次粗算:一天成功检索 1 万次,大约 7.5 美元;规模上去之后,缓存与合并查询会比「换更贵的模型」先成为优化项。
第五盆:采样建议 temperature=1.0、top_p=1.0,和不少团队默认的 0.2/0.7 不一样。上线前用自己的回归集扫一轮。另外 763B 与父代 552B 的口径别混用——对外讲架构时写清「父代公告 / 本卡 Safetensors 标注」。
还有一件容易忽略的事:legacy 模型名还活着,但模型已经退役。团队里如果有人仍在文档里写 deepseek-v4-flash,以为自己锁在旧版上,其实流量已经打到 1017。灰度发布、版本钉死、评测对照,这三件事要一起做。
我的态度比较直:DeepSeek 这次玩的是 静默升级——名字不变、价格不动、能力往上抬,对已经绑定 flash 的产品是好事。但静默升级最怕两件事:你以为还在测旧模型;你按旧输出长度估的成本,和新模型对不上。把回归集和 token 看板先拉起来,比转发一张跑分截图有用得多。
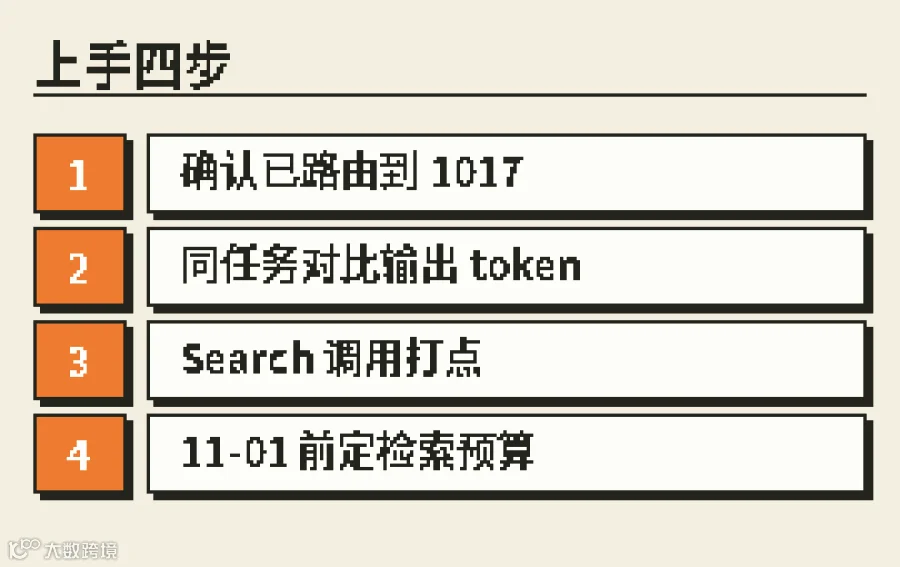
CHECKLIST
确认路由到 1017 → 同任务比 token → 峰时/非峰分开算 → Search 调用打点 → 11-01 前定预算 → 要自托管再下 MIT 权重。
照着做可以按这张单子:① 调用里继续写 deepseek-flash,打一条请求看返回或控制台是否已是 V4.1-Flash-1017;② 拿你线上 Top 20 真实任务,对比旧版(若还留着日志)的通过率、延迟、输出 token;③ 账单按峰时/非峰拆开,别用混合均价忽悠自己;④ 若走 Harness / Claude Code / Codex,给 Search & Fetch 打点,估算 11 月按 0.75 美元/千次的成本;⑤ temperature/top_p 先按官方 1.0/1.0 跑一版,再和你的旧参数做 A/B;⑥ 需要私有化再去 Hugging Face 或 ModelScope 拉 MIT 权重;⑦ 想对外报价,把「交付物、过关标准、改几轮」写成一页纸,别只写「接了最新 Flash」。
OpenAI 兼容示例(model 名不用改)
from openai import OpenAI
client = OpenAI(api_key="...", base_url="https://api.deepseek.com")
r = client.chat.completions.create(
model="deepseek-flash",
messages=[{"role": "user", "content": "回归测什么?"}],
temperature=1.0, top_p=1.0,
)
很多人卡在第 ⑦ 步:API 会调了,命令也跑通了,就是不知道怎么变成一单生意。买家是谁、交付什么文件、过关标准写什么、改几轮,这些和模型强不强没关系。
你会不会立刻把回归集切到 1017?评论区聊聊。
出处:DeepSeek 官方 X @deepseek_ai(10月17日)、Hugging Face 模型卡 deepseek-ai/DeepSeek-V4.1-Flash-1017、api-docs 定价页;父代架构背景见 V4.1-Flash 9月公告。
往期 · 接着看
Reflection开源Beam:501B只激活23B,Apache 2.0可商用,第三方测出幻觉率47%
Meta开源Muse Spark Open:816B只激活42B,两台Mac能跑?NVFP4仍要约700GB显存
蚂蚁开源Ling-3.1-flash:560B只激活25B,1M窗线上先给256K
「AI商业实战」新人邀请礼遇 ¥25,进圈可领两张短卡:「交付定义卡」把买家、交付文件、过关标准、改稿轮次一次写清;「一周试跑清单」按天跑通一个最小交付闭环。不保证接单,帮你少走弯路。
每周风向标和项目拆解都在星球里。开启 AI 实战交流。
新人邀请礼遇:开启 AI 实战交流
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING