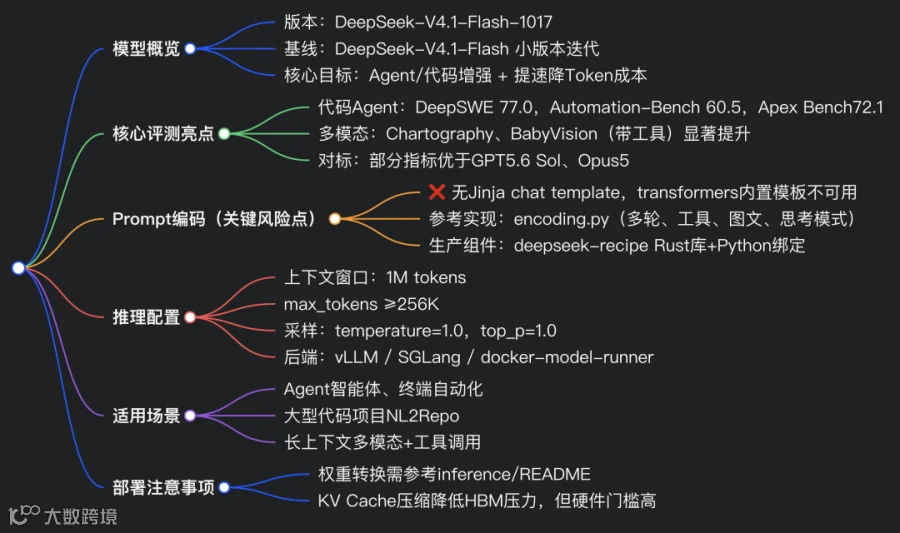
encoding.py参考实现;生产环境推荐 deepseek-recipe(Rust 库 + Python 绑定),支持消息转原生 prompt、token 编码、流式输出解析,覆盖思考模式、工具调用与图文混排。 上下文窗口 1M tokens,最大生成≥256K tokens,推荐采样参数 temperature=1.0、top_p=1.0。支持 vLLM、SGLang 本地部署。底层依托 KV Cache 压缩技术,降低长上下文显存开销,适合私有化 Agent 平台、代码工程生成、多模态自动化任务。
10 个技术问题 Q&A
-
Q:DeepSeek-V4.1-Flash-1017 是什么版本,相比原版 V4.1-Flash 改动定位? A:属于 minor 小版本更新,不是大模型基座升级,核心聚焦 Agent、代码、视觉能力提升,压缩输出 token,降低任务执行成本。 -
Q:最突出的 Benchmark 提升是哪几项? A:DeepSWE v1.1、Automation-Bench、Apex Bench 三大 Agent / 代码评测提升幅度最大,得分超过 GPT5.6 Sol、Opus5。 -
Q:最大坑点:能否直接用 Hugging Face transformers chat_template? A:不能,该模型没有 Jinja chat template,直接使用会造成对话格式错乱、工具调用失效。 -
Q:prompt 编码有哪些官方方案,生产环境推荐哪个? A:轻量测试用 encoding.py;生产系统优先 deepseek-recipe(Rust+Python 绑定),完整支持思考、工具调用、图文混合、流式解析。 -
Q:模型上下文窗口与最大生成长度是多少? A:上下文窗口 1M tokens,建议设置 max_tokens≥256K。 -
Q:推荐采样参数 temperature=1.0、top_p=1.0,为什么用这个配置? A:官方推荐配置,匹配模型原生分布,最大化推理、Agent 工具调用与代码生成能力;业务上线前可根据场景微调。 -
Q:支持哪些本地推理后端? A:HF 页面原生支持 vLLM、SGLang、docker-model-runner,权重转换步骤参考 inference/README.md。 -
Q:模型原生支持哪些能力:工具调用、思考模式、多模态? A:全部支持;支持多轮对话、中途插入 system message、图文交错输入、工具调用、显式思考模式。 -
Q:底层 KV Cache 压缩价值是什么? A:继承 V4.1-Flash 的 KV 压缩技术,大幅降低长上下文场景 HBM/SSD 显存开销,让 1M 上下文私有化部署可行性提升。 -
Q:该模型适合哪些业务,哪些场景不推荐优先落地? A:适合企业 Agent 平台、终端自动化、完整代码项目生成、长文本 + 图表多模态分析;简单短问答场景收益有限,硬件成本高,不建议优先选用。

DeepSeek-V4.1-Flash-1017 是 DeepSeek-V4.1-Flash 的小幅迭代版本(minor update),核心目标:推理、代码、Agent 智能体、多视觉基准全面提升;同时缩短任务耗时、精简输出长度,降低 Token 成本,优化 Agent 场景下性能 - 成本帕累托最优。网页端、APP、API、HuggingFace 权重同步更新,API 调用名称依旧使用deepseek-flash,无需修改业务代码。
一、亮点
- Agent / 代码能力大幅增强
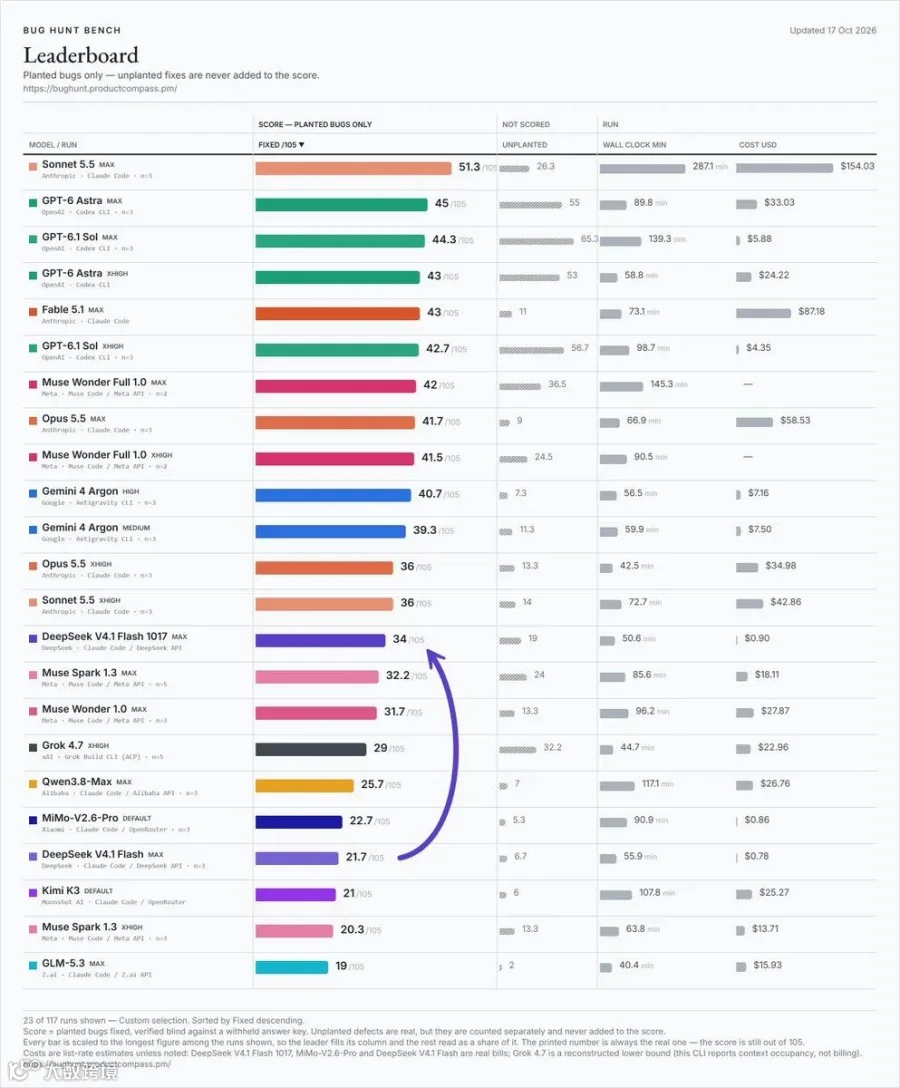
专项针对 Agent harness 框架优化,在 DeepSWE、Terminal-Bench、Automation-Bench 等硬核 Agent 评测上显著超越原版 V4.1-Flash,部分指标超过 GPT-5.6 Sol、Claude Opus 5;强化许愿式编程,少量提示词从零构建完整项目(网页游戏、3D 建模等)。 - 输出瘦身,降本提速
减少冗余思考文本,在保持解题 / 工具调用质量前提下缩短输出 token,任务执行耗时下降,Agent 场景 Token 开销显著优化。 - 原生多模态视觉 + 工具调用
支持图片理解、多轮对话、工具调用、思考模式、中途插入系统消息、图文交错输入。 - 超大上下文
上下文窗口:1M tokens,推荐最大生成≥256K tokens;推荐采样参数: temperature=1.0,top_p=1.0。 - KV Cache 压缩底层优势(继承 V4.1-Flash)
552B MoE,Causal-Encoder-Decoder 非对称结构,激活仅 8B 输入 /16B 输出;KV Cache 大幅压缩,HBM/SSD 开销远低于同规格模型,适合长上下文 Agent 部署DeepSeek。
二、Benchmark 核心对比(DS-V4.1-Flash-1017 vs 原版 V4.1-Flash / K3 / GLM-5.3 / GPT-5.6 Sol / Opus5)
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
77.0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
60.5 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
72.1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
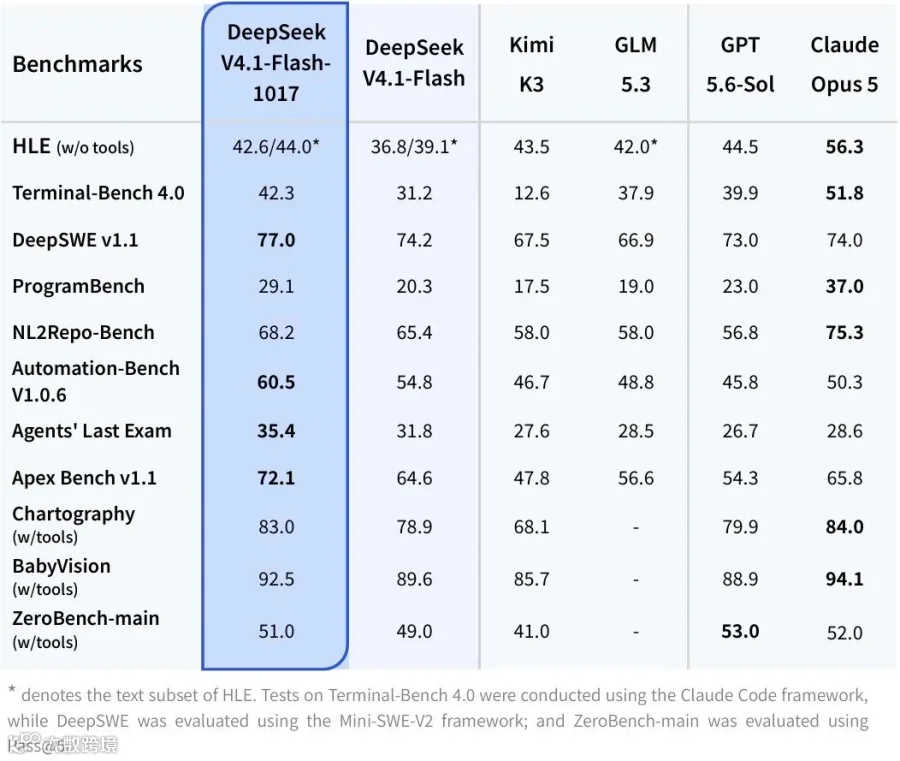
 说明:HLE 带†为纯文本子集;Terminal-Bench4.0 使用 Claude Code 评测框架;DeepSWE v1.1 使用 Mini-SWE-V2 评测框架。 ✅ 突出项:DeepSWE、Automation-Bench、Apex Bench 三大 Agent / 代码基准,1017 版本超过 Opus5 与 GPT5.6 Sol。
三、Prompt 编码(重点,和普通 HF 模型不一样)
⚠️ 该模型没有 Jinja 格式 chat template,不能直接用 transformers 内置 chat_template
-
参考实现:HF 仓库 encoding/encoding.py,附带测试用例,覆盖多轮对话、工具调用、思考模式、数值推理、中途系统消息、图文混合输入。 -
生产环境推荐:deepseek-recipe(Rust 库 + Python 绑定) -
把 OpenAI Messages / ChatCompletion API 请求转为模型原生对话格式 -
编码为 V4/V4.1 prompt 或 token ID,同时解析流式 / 完整模型输出 -
自动处理思考文本、工具调用、图片、生成参数;推理、工具执行、HTTP 传输由业务方自行实现 -
本地推理:参考 inference/README.md,包含权重转换与本地部署文档;HF 页面内置 vLLM、SGLang、docker-model-runner 一键本地启动入口。
四、License、引用、部署要点
-
License:仓库与权重使用仓库内 LICENSE 协议 -
BibTeX 引用
@misc{deepseekai2026deepseekv41flash,
      title={DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression},
      author={DeepSeek-AI},
      year={2026},
}
-
联系:service@deepseek.com,HF 仓库提 issue -
适配建议:Agent 应用建议升级 DeepSeek Harness ≥0.2.1-rc.1,才能完整发挥 1017 版本优化收益
五、适用场景与局限
✅ 适合:
-
企业 Agent 智能体平台、自动化任务、浏览器 / 终端操作 -
大型代码项目生成、NL2Repo、许愿式完整项目开发 -
长上下文多模态数据分析、图表理解、视觉工具联动 -
追求高性价比、降低 KV 缓存开销的私有化部署
⚠️ 注意:
-
不能依赖 transformers 标准 chat template,必须接入 deepseek-recipe 或者官方 encoding.py,否则对话格式错误,工具调用 / 思考模式失效 -
本地硬件门槛极高(552B MoE),KV 压缩降低显存压力,但 1M 上下文依然需要大量 HBM;vLLM/SGLang 是推荐推理后端。 附录二