

对话助手需要记住用户的偏好,机器人需要调用过去的操作经验,视频系统需要找回很久以前出现过的片段。要让AI长期工作,存储、检索和遗忘都得跟上。
Memories.ai联合香港科技大学(广州)、剑桥大学、布里斯托大学、哥伦比亚大学及Meta的研究者,在Proceedings of the IEEE发表综述《Human-Inspired Perspectives: A Survey on AI Long-Term Memory》。
论文从人类长期记忆出发,梳理AI记忆的类型、存储方式和处理机制,提出自适应长期记忆认知架构SALM,并给出基于Llama的实现与长对话实验。相关代码已公开。
其中,论文第一作者贺梓弘(Zihong He)是香港科技大学(广州)博士生。通讯作者林炜哲(Weizhe Lin)博士毕业于剑桥大学,研究多模态检索增强问答。主通讯作者沈俊潇(Junxiao Shen)是Memories.ai联合创始人,博士毕业于剑桥大学。
01
AI需要怎样的长期记忆
记住一次交谈的时间和场景、理解一个概念、掌握一项技能,对应着人类长期记忆中的情景记忆、语义记忆和程序性记忆。论文沿着这三类功能,讨论AI如何积累和使用经验。
在AI系统中,交互记录和历史事件可以构成情景记忆;知识库及模型学到的概念关系可以承担语义记忆;通过强化学习获得的策略,以及可调整的规则和代码,则可以承载程序性记忆。历史经验也可以参与策略学习,让这些记忆发生联系。
另一个分类依据是信息存放的位置。参数化记忆通过更新模型参数保存信息,非参数化记忆把信息保存在模型外部,例如数据库和文件系统。RAG检索外部资料辅助生成,就属于使用非参数化记忆。
记忆的功能与存储形式,是两个不同的分类维度。语义知识既可以进入模型参数,也可以留在外部知识库中;程序性知识既可以表现为训练得到的策略,也可以表现为可调用的规则和代码。
02
SALM如何管理记忆
论文比较了ACT-R、Soar、Sigma、CoALA等认知架构的记忆模块,在此基础上提出SALM。它包含感知寄存器、工作记忆、长期记忆和执行动作的模块。
SALM把存储、检索和遗忘的决策交给可学习的适配器:系统根据任务反馈,学习何时存储信息、从哪里检索,以及删除哪些内容。适配器负责选择操作的触发时机、记忆类型和具体内容。
适配器的优化,也对应着程序性记忆的积累。长期记忆中既有事件和知识,也有处理这些信息的策略;SALM通过反馈更新策略,使记忆管理本身成为学习的一部分。

图1|SALM认知架构,取自论文图8。长期记忆同时包含参数化和非参数化形式,适配器参与记忆处理决策。
在具体实现中,团队以Meta-Llama-3-8B-Instruct为骨干模型,用LoRA适配器保存参数化记忆,用外部上下文承载非参数化记忆。
(1)存什么?
存储适配器先判断信息是否值得进入长期记忆,再选择存储形式。对于时效性强、长尾的信息,或参数化存储容量受限的情形,可以使用非参数化记忆。过滤低质量数据、投毒输入和隐私敏感信息,也是存储机制的设计目标。
实现中,存储决策随每段会话触发。判别网络先决定是否保存,再决定写入哪类记忆。选择参数化存储时,系统会在复用现有LoRA适配器与新建适配器之间做选择,并结合质量评分、剩余容量及语义分支确定写入位置。
(2)怎么找?
检索适配器根据当前上下文选择记忆来源。面对外部记忆库,它挑选与任务相关的信息;面对多个承载记忆的模型或适配器,它选择合适的调用对象。
非参数化检索会为记忆条目与查询的联合特征打分,筛选候选后选出Top-K条目,再结合相关性和记忆质量排序。参数化检索则通过路由网络,综合LoRA适配器的存储质量、历史调用频率及与当前查询的相关性,选择调用对象。
(3)何时忘?
遗忘适配器决定移除哪些外部记忆条目,或删除哪些承载参数化记忆的模型、适配器。主动遗忘释放存储容量,也能减少后续检索时的干扰。在SALM中,这三类操作都可以根据任务反馈学习。
具体实现会先判断是否触发遗忘,再选择记忆类型,最后为待移除的条目或LoRA适配器打分。两类记忆的清理对象不同,都由可学习网络做出选择。
(4)用任务反馈训练记忆策略
系统采用多分支决策树,在存储、检索和遗忘的候选路径中探索不同组合,每条长对话历史最多同时保留20条活跃路径。各条路径分别生成答案,奖励综合答案质量、相对无记忆基线的改善,以及存储、遗忘和参数化记忆训练的效果,再通过策略梯度更新记忆处理策略。
03
长对话实验:记忆策略
如何变化
实验使用包含500条长对话历史的LongMemEval_S。每轮随机打乱数据、选取128条样本,独立运行4轮,以累计平均奖励观察记忆策略的学习过程。
每条历史由多段会话组成,总长度约11.5万token,并对应一个用于评估长期记忆的问题。问题涵盖时间推理、知识更新等能力,需要系统把不同会话中的信息带到当前问答。
第一组实验比较同时使用两类记忆、仅使用非参数化记忆和仅使用参数化记忆的配置。第二组比较完整SALM与无适配器的系统:对照系统默认保存全部会话,将全部非参数化记忆载入上下文,并调用存储量最大的LoRA适配器完成推理。
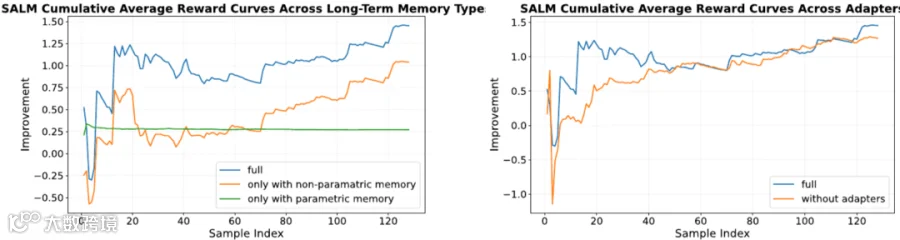
图2|不同配置的累计平均奖励曲线,取自论文图10。每轮选取128条长对话历史,曲线为4轮独立实验的平均结果;左侧比较记忆类型,右侧比较是否使用适配器。
结果显示,引入适配器后,SALM的累计平均奖励呈现更稳定的上升趋势。在记忆类型的比较中,同时使用两类记忆的配置逐渐趋于稳定,仅使用非参数化记忆的配置呈上升趋势,仅使用参数化记忆的配置则在早期略有上升。这组实验中,适配器对非参数化记忆处理的学习效果更明显。
END
关注+星标,获取AI前沿进展与开源一线动态