

DGX Spark 这类小机器的卖点很直白:功耗特别低,还能一台一台往上堆,堆得越多越好。但它的短板同样直白——慢。一台这样的小机器到底能跑什么、值不值得一路堆到四台,就是这场独白想回答的问题。
0xSero 说,它基本只能跑总激活参数比较少的混合专家模型,还得配上 dSpark 或 dFlash,或者多 token 预测,速度才勉强够用。单台约 128GB 内存(实际拿不到那么多)、每秒 273GB 带宽;用 ConnectX-7 互联线(USB-C 也行)串起来、四台走一个交换机,能给 CUDA 用的内存带宽几乎线性增长。他买了四台,基本每次去美国买一台;主机现在大概四千八到五千八美元,交换机一千美元上下,线八十美元左右,而他说这个价格已经不成立了,觉得后面还会再放货。最典型的一幕是他让本地模型画一张芯片 3D 图,画完当场指出不对:芯片其实是平的,HBM 是堆叠的,LPDDR5 不是。
他是一位独立本地 AI 工程师,主要做开源模型的量化与专家剪枝(REAP、EXL3/Trellis),也是 YouTube 频道 @0xSero 与播客 Ethers Club 的主持人;他自己买了四台 Spark 做量化、剪枝和推理实验,自述主要算个外包、有公司接活,做技术写作、测评与策略,评测上用 KLD 和 Harbor。这场独白从为什么买四台 Spark、HBM 与 LPDDR5 的制造难度差别,讲到低比特量化的保真度取舍与推理实测。他的主要观点包括:
四台 Spark 串起来,给 CUDA 用的带宽几乎线性增长。 单机规格是每台约 128GB 内存、每秒 273GB 带宽;用 ConnectX-7 互联线,甚至 USB-C 也行,再把四台挂到一个交换机上,能给 CUDA 用的内存带宽几乎线性增长。他说四台也得靠交换机,没交换机大概只能搞环形连接,交换机一千美元上下,线八十美元左右。
制造难度差在链条上:很多环节只有一两家公司能做。 他讲芯片在不同地方、由不同实验室造,需要的技术不一样,高带宽内存比低功耗双倍速率内存难搞多了。讲到先进制程那条链条时他说,现在全世界只有台积电这一家公司能做出来(这是他在对话里的说法),因为放硅晶圆用的那种晶体、那台机器、用来蚀刻的激光,很多东西只有一两家公司在做。
GDDR 在 HBM 和 LPDDR5X 中间,这是他认可的说法。 模型重做了一遍解释、加上 GDDR 之后,他核对后说「这个还不错」:GDDR 是游戏卡和工作站卡上的内存,几个 DRAM 芯片焊在 GPU 周围,每 GB 比 HBM 便宜得多,按系统算比 LPDDR5X 快得多,但满载时很耗电。这是模型给出的解释,他只是认可。
HBM 是堆叠的,LPDDR5 不是——他当场纠正了模型画的 3D 图。 他让模型做一个并排展示两种内存芯片设计的 3D 文件,还要求能缩放、能点开看细节。出来以后他指出图错了:芯片其实是平的、所有东西都铺在芯片上,HBM 是堆叠的,LPDDR5 不是,让他去看截图。
先跑 KLD,再跑 Harbor 上的基准。 他说 KLD 比较便宜,Local Inference Labs 那个仓库有很好的 Pro 6000 索引,看 KLD README 就够;KLD 在合理范围内,再做更小的评测基准。他记得 GDPval 这类很短,还有 GPQA Diamond;他说也可以只跑部分样本,但他一般尽量跑完整,只是有时候这么做挺贵。
同一任务换到 HomeLab 那版,他说至少快六倍、更接近八倍。 他把正在跑的任务从本地切到 HomeLab 上的 GLM 5.3,指着说 6000 上快很多;他自己也说十倍夸张了,估计六到八倍之间。他还说 Opus 现在是每秒八十到一百 token,用 Astro 这种每秒三十五 token 的就很难受,本地推理涉及的细节太多。
低比特量化里,trellis 是他认为最接近 16 位表现的办法。 他现在的构建是完整上下文 260K、支持视觉、EXL3 量化,表现基本跟 NVFP4 差不多,再加上 FP8 KV 缓存,打算公开。他主要用 trellis 量化,用一卷很长的磁带打比方:16 比特只是其中一段,三、六、十二、十五,十五差不多是极限。他自己说这很难解释、还在琢磨它到底怎么工作。

为什么买四台DGX Spark:低功耗堆叠的诱惑
0xSero:好,今天就聊聊 DGX Spark。我上周刚写了一篇关于它的东西。这段时间我一直拿它做量化、剪枝,还有各种乱七八糟的实验和推理,用下来是真的好用。这玩意儿功耗特别低,你还能一台一台往上堆,堆得越多越好。
当然它也有问题,就是慢。所以基本只能跑那种总激活参数比较少的混合专家模型,还得配上 dSpark 或者 dFlash,或者多 token 预测,速度才勉强够用。而且现在越来越不好买了,这个价格已经不成立了,我觉得他们后面还会再放货。
0xSero:这类机器的限制其实比另一种小得多。你想,高带宽内存比这种低功耗双倍速率内存难搞多了。所以我买了四台,基本上是每次去美国就买一台,然后慢慢攒起来。一开始我就是想搞清楚它到底能跑什么,因为你要硬上 27B 那种,它真的太慢了。所以我得试出哪些模型最合适。
如果只有一台 Spark,我觉得最能打的大概是 DeepSeek V4 的 0731 版本,我记得那个是带视觉的,不过我不太确定记没记错。反正这种模型跑两比特或者三比特,效果其实挺不错。还有 Qwen 3.6 35B 也相当好,能改文件、能写代码、能做很基础的自动化。我现在还在重做我自己那个本地 studio 应用,把跟我已经没关系的东西基本全砍了,只要不是经常用的我就删掉。
说回 Spark,每台大概 128GB 内存,实际上拿不到那么多,会少一点,但大体在这个区间。每台的内存带宽是每秒 273GB。可你要是用线把它们串起来,用 ConnectX-7 互联的线,甚至 USB-C 也行,它们就是这么跟那些卡配合起来的,再过一个交换机,你能给 CUDA 用的内存带宽几乎是线性增长的,用来更快出结果。所以你往集群里加机器,它就越跑越快。
我接了四台。我看看这儿有没有图,没有图。反正就这四台,你能在旁边看到,这是两台的样子。四台的话就得用交换机了,没交换机你大概也能搞个环形连接,但用交换机省事。交换机一千美元上下,线大概八十美元,可能再便宜点。Spark 主机现在大概四千八到五千八美元,看你能不能找到好价钱,还有不少非 Micro Center 那种店手里有货,你打几个电话问问本地商家,应该能找到。我不是说你一定要买,就是如果你对 Spark 感兴趣、又觉得价格偏高的话。
我想跑模型的时候,就直接选用几台,因为我有四台。现在我就用两台,跑 GLM 5.3 flash,希望它能起来。不过话说回来,往 DGX Spark 上加载模型是真的慢。但我觉得现在用 Opus 应该能优化一下,它确实够强。如果你想租来试试,Vast.ai 上挺便宜的,我租过一个月才二三十美元。想体验一下的话可以租。你问 Thor 和 Spark 有什么区别?Thor 我见过,但没用过,可能显存也不一样吧,Spark 好像只有 128。
我想让你用 HTML 可视化的方式给我讲讲,高带宽内存和低功耗双倍速率内存到底差在哪,不只是原理上的区别,还有功耗,为什么这种混合芯片的功耗比高带宽内存低,以及各自的制造难度。我猜高带宽内存更难造、也更难搞到货,现在数据中心卡基本都用它。行,那就让它去跑。
我挺喜欢 OMP 的,喜欢它的搜索,网页搜索那些,整体做得很惊艳,比我刚开始用的时候强太多了。它能接进 Claude Code 的搜索、codex 的搜索。谷歌那个也不错,谷歌的网页搜索确实挺好。能把这些数据全都拿过来用,太爽了。
好,报告出来了。这个是本地模型做的,说本地模型有点夸张,其实是 GLM 5.3 flash。我想让你重点讲生产成本,还有大家一般从哪买这两种芯片。
HBM与LPDDR5:芯片制造难度的分野
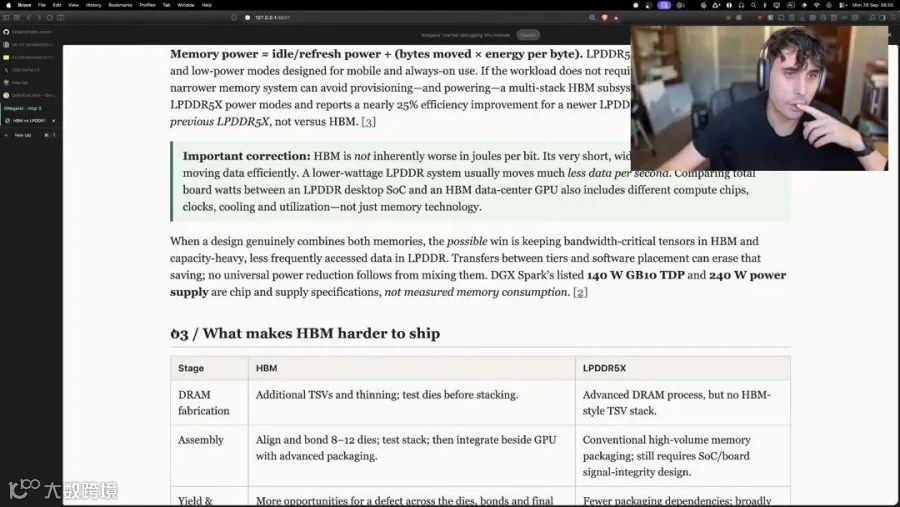
0xSero:这些芯片是在不同地方造的,背后是不同的实验室,每一款的生产难度都不太一样,需要的技术也不一样。高带宽内存更难,而大多数 GPU 用的就是它,因为它们需要极高的晶体管密度。现在全世界只有台积电这一家公司能做出来。台积电之所以是唯一能做的,是因为背后有一整条链条,里面很多东西只有一两家公司在做,比如他们用来放硅晶圆的那种晶体,还有那台机器,还有用来蚀刻的激光。
Spark 最烦人的一点就是慢,怎么还在加载?好,应该差不多了,模型该起来了,不过刚才 bug 是真的多。你们有什么 prompt 想让我丢给这个跑在 Spark 上的家伙吗?有。给我做一个 3D 的 HTML 文件,用 Three.js 什么的都行,要 3D 的,展示低功耗双倍速率内存的芯片设计和 HBM 的芯片设计,让它们并排显示,可以点击、可以展开看细节,尽量准确。你可以上网搜,找芯片的图片。对,去翻厂商的资料,看看这些芯片有没有共用的架构设计模式之类的。这东西解码大概每秒六七十到八十个 token,预填充差不多一千四。OMP 的问题是它的系统提示词比 Pi 长,所以……
0xSero:所以它的表现也会受到这段更长系统提示词的影响。

量化与推理实测:散文为什么更慢
0xSero:还有写散文的时候它表现更差。散文就是让它写普通文本,像人写的那种文字,不是代码或者工具调用,它就会更慢,大概在四十到五十之间。我也不确定我这套配置是不是优化好了,反正这就是我的日常主力。我还觉得 GLM 5.3 Flash 对细节的把握更好。挺有意思的,现在这些新的 Flash 模型都很强,就是因为这个。所以现在上下文窗口堆起来一点之后,它反而开始提速了,因为它们注意力那块就是这么设计的,它开始变得更准——那个叫什么来着,它上面的 MTP,也就是多 token 预测,开始变得更准。不过它还是有点慢,我也不知道到底为什么。
麻烦在这个里面也加上 GDDR 内存,还有现在除了你举过的例子之外,推理在用的任何别的东西都加上。做可视化的时候去看看我最近的 Notion 文章,用那种可视化方式来传达你要说的东西。你要让这个 3D 渲染器能缩放进去看内部组件,还能点开看细节,你得下狠功夫,也许你该立个目标。不行,我们只有十五分钟要弄完这个,所以也许你该并行化,把 HomeLab 上的这个 GLM 5.3 当子 agent 用。我来给它打标签。这是 OMP 加的一个很酷的功能,你可以给模型打标签,这样下一个子 agent 就用你配好的那个,而不是模型自己随便挑,因为模型自己真的很不擅长做这种决定。
所以基本上就是把网页搜索发给 Anthropic,让它去写代码,通过写代码做代理,然后它用的是 SiteGeist,这是我最近做的。太好了。所以现在我跟那边的 Opus 说了速度的问题,它就直接把正在跑的模型杀了,我把它切到 HomeLab 那个版本。对,你能看到在 6000 上快多少,至少十倍。不,十倍有点夸张了,至少快六倍左右,应该更接近快八倍,但本地推理涉及的细节真是太多了。没错,但你也能看到它有多快,这个速度太离谱了。所以当你手上有这么快的东西时,再用 Astro 这种每秒三十五 token 的就很难受了。当然,你也知道,想让这些模型跑这么快不容易,所以你要么得堆大量硬件,要么得订阅 Fireworks 这类服务。记住,T3 Code 不是 harness。
好,它把这份解释重做了,加上了 GDDR,看看它做得对不对。对,这里有。GDDR 就是游戏卡和工作站卡上的内存,几个 DRAM 芯片焊在 GPU 周围,每个都跑得很快,走的是很宽的总线。它处在另外两类的中间,每 GB 比 HBM 便宜得多,按系统算比 LPDDR5X 快得多,但满载时很耗电,而且没有堆叠空间了。这个还不错。我还觉得 Opus 和 Astra 现在写作都好太多了,它们不用破折号了,就是没以前那么笨了。我是说,如果你能解决那个问题,那就快得多。Opus 现在是每秒八十到一百 token,所以你这差不多是它的三倍速,这太酷了。做这类讲解一直都很有用。
0xSero:我总是让模型做可视化、做文件,试着给我把某个东西讲清楚,这个快。对,现在这大概是八个并行会话,能有这么快真是离谱。我们来给 3090 党做个 GitHub。所以这就是我们现在的位置:完整上下文 260K,支持视觉,EXL3 量化,它的表现基本跟 NVFP4 差不多,再加上 FP8 KV 缓存。所以这个构建对你们来说应该更合适,我会把它公开。
如果你有 3090,你怎么赚钱?因为采用上最大的限制因素基本上就是钱。对。那我是怎么赚钱的,我做很多技术写作、测评、策略、做东西,我主要算个外包。我有个公司,我接活,简单说就是这样。我有几个客户,我拿到客户的方式基本就是去那些大型活动。
你怎么做基准测试?对,我会做几件事。有 KLD,KLD 就是 KL 散度测试,Local Inference Labs 那个仓库,有很好的 Pro 6000 索引,你其实只需要这里面的 KLD README。所以先做 KLD,它比较便宜。如果 KLD 结果不错、在合理范围内,那你就可以做评测,在更小的评测基准上。我觉得有几个挺短的,比如 GDPval,我记得就很短,还有 GPQA Diamond。你可以做这些,或者只做这些基准的一部分样本;如果可以的话我一般做完整的,能行的话我尽量做完整的,有时候这么做挺贵的。但你看这里,你有这么多基准。然后有 Harbor,Harbor 是我推荐用的东西。Harbor 是个框架,它是个 CLI,你可以用,你的 agent 显然也能用,它们能在 Terminal-Bench 或者别的上面跑基准。有一大堆不同的 Harbor 基准 harness,这个算是主 harness,也有专门给 Terminal-Bench 的那种。
HBM是堆叠的,LPDDR5却铺在芯片上
0xSero:所以我推荐这么做,这是正路。但问题是它错了:芯片其实是平的,所有东西都铺在芯片上,你这么展示就不准,去看截图就知道。HBM是堆叠的,LPDDR5不是。有意思的是,现在这么多人开始对本地AI感兴趣,太疯狂了。
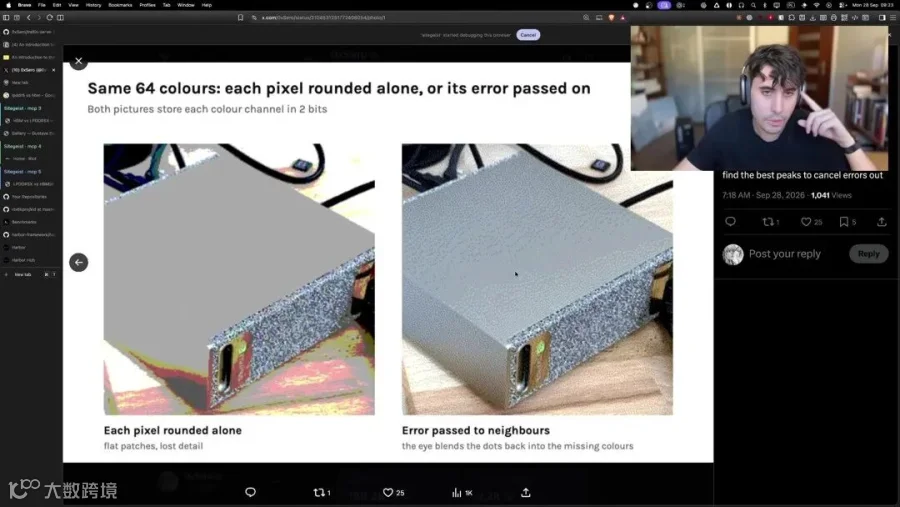
0xSero:我最喜欢的一张图:用越来越少的比特表示一张图,每一步都在丢掉大量保真度——只用两三个比特表现颜色,画面就变得很平。而trellis量化(我主要用的那种)要想象一卷非常长的磁带,16比特只是其中一段,你得找一个窗口:要做三比特的模型又要好的表现,就得想办法怎么叠——三、六、十二、十五,十五差不多是极限。也就是在一个16位的串里并排放五个值,让这个固定的串覆盖尽可能多的可能结果。这很难解释,我自己也还在琢磨它到底是怎么工作的。
用trellis做低比特量化:保真度的取舍
0xSero:我大概会这么理解:我们有这些颜色,就像右边你看到的那个金属网格,它更亮一些。而且我们不是只有一整块黄色,我们可以用网格的一部分来替换保真度——这就是为什么你在这里看到这些颜色。但我们是在 16 位的范围里做的,所以颜色才不完美,不过整体看起来比原来好多了,也清晰多了。模型也是一样的道理:如果你直接把它量化到三比特或者两比特,你会丢掉太多模型可能有的保真度;但如果你用这个 trellis 的办法,你实际上能得到非常非常好的表现。
0xSero:是的,它会丢东西,因为比特更少,但它准得多。在我看来,它目前是在低量化上尽可能接近 16 位表现的最好办法。谢谢你们花时间来做这个,跟你们聊得很开心。
原视频:DGX Spark Handbook
https://www.youtube.com/watch?v=V17WkdXCH9U
中文播客:在小宇宙App搜《硅谷对谈》,或直接访问下面的链接
https://www.xiaoyuzhoufm.com/episode/6acb714c195d838e2af02bf4
编译:磊哥Thomas