


左:主持人,右:嘉宾
模型越来越强,但你能买到的算力却在收紧。嘉宾算了一笔账:现在 500 美金的套餐给的量,跟以前 200 美金的一样多——一边在减少,一边还在涨价。当「无限调用」不再成立,把 AI 跑在自己硬件上就从极客爱好变成了正经选项。
这场对话里他直接演示了两件事:让 Opus 自己琢磨怎么给一台 16GB 内存的 Mac mini 加外接 RTX 3090 调度 80GB 模型,做到了每秒 28 token;又用 Browser Use 浏览器智能体在两台 DGX Spark 上画旧金山金门大桥,让它开车、滑板。他的结论是:沿着硬件、推理引擎、模型、agent、用例这条栈拆到足够高的层面,普通人也能完整理解并动手。
嘉宾没有给出可查证的背景资料,对话中他以实操者身份出现:自建渗透测试环境做漏洞赏金狩猎、夜里让 agent 批量生成 3D 资产、维护一个按配方奖励 50 美元的开源 repo。这场对话从第一性原理的全栈拆解出发,延伸到夜间自动化用例、硬件经济学、Browser Use 演示和多卡并行调度。他的主要观点包括:
第一性原理就是沿技术栈讲够高,让人能完整理解。 硬件、推理引擎、模型、agent、用例五层往下走再往上走:容量装多少(Spark 是 128G)、内存带宽多快,预填充看 flops、解码看内存带宽,讲到这个高度就能判断一台机器能不能跑得动某个模型。
你被分配的算力有限,而且越来越少、越来越贵。 现在 500 美金的套餐给的量就跟以前 200 美金一样多。所以不可能让云端模型一周七天 24 小时不停造东西、处理数据或保护安全,本地硬件才有办法承担这种持续的夜间工作。
漏洞赏金正在变得真的可行。 过去一年发布的 CVE 数量曲线完全不乐观。他用 Opus 搭了个渗透测试 harness 追踪看过哪些仓库、发现了什么错误,去换 bug bounty;任何公司都可以买一堆 GPU 做这种事,这些用例都有经济价值。
今年所有东西都涨了 20% 到 80%,软件补偿正好对冲。 内存需求更高而产量跟不上,PlayStation 凑齐主机零件更难,Apple 也为此涨价,他不觉得会好转。但他看到的是模型在变小、加速研究有突破,软件端的进步恰好抵消硬件越来越难搞的事实。
5000 美金不如买一张 Blackwell 24GB 显卡。 大概 4000 美金再加一点内存;CPU offloading 进步很大只是需要更多人采用。3090 是速度对价格帕累托前沿上的最优解,而 H100 这种数据中心卡的噪音和热量长期根本不可持续。
AI 厉害的地方在于把纯意图变成基本符合需求的产物。 很多人缺的是从 A 到 B 这一步:脑子里有个想法,下一步就得搞定签证、订 Airbnb 一堆琐事。把纯粹的意图描述给 AI,大多数时候它能还你个基本可用的东西,剩下你自己筛掉没用的部分。
让 Opus 自己学会调度,比等人更新软件靠谱。 Intel Arc B70 配 Chestnut 开箱不支持,他丢给 Opus 捣鼓了一会儿就自己搞出来了,USB-C 连上 Mac。Strata 框架加一篇论文交给 Opus 想互联调度,做到解码每秒 32 token、预填充每秒 550 token,首 token 延迟五到九秒。
模型该按激活情况最优地摆到不同硬件上。 张量并行、流水线并行之外,更好的做法是把 dense layer 和被触发最多的专家放到更快的卡上,剩下的进内存甚至 NVMe。比如一块 RTX Pro 6000 加一台 DGX Spark,MTP 投机解码器放快的卡上就行。

性原理:硬件、推理引擎到用例的全栈拆解
嘉宾:我把它交给 Opus,让它自己琢磨怎么跟这套系统做互联。它做到了大概每秒 28 token,现在快接近 32 了,但解码是每秒 32 token。预填充大概是每秒 550 token,首 token 延迟大概五到九秒。
主持人:我经常听到这个词——第一性原理。从你的角度看,你说你从第一性原理出发去解决问题,那你到底带着什么在切入问题?
嘉宾:我的意思是:你有没有足够的基础知识,能在一个比较高的层面理解这里到底发生了什么?比如硬件——至少在这个例子里,我们有硬件;还有软件;还有推理引擎,它也算软件的一部分,但我还是想把它单列出来。所以我们有硬件、推理引擎、模型、agent,还有用例。
沿着这条线往下走:关于硬件,它的容量是多少?能装下多少东西?比如 Spark 就是 128G。然后还有内存带宽,就是你把模型放上去的那块内存有多快。它必须快的原因是,推理是在对权重做大量的数学运算,权重就是我们存下来的一堆数字。GPU 能让这些运算并行化,CPU 每个线程一次只能干一件事。
所以这里的思路是沿着这个技术栈往下走再往上走,讲到足够高的层面,让人能完整理解。这说得通吗?如果你想想进入这个领域需要知道什么:要么你有硬件,要么你有一笔预算想买一两个这样的设备,二选一,目的是拿到一个够好的、能在你机器上跑的模型,然后把它接进你用 AI 的那个软件里,随着时间慢慢个性化,并且搞清楚怎么利用这个资源。比如对我来说,晚上它就一直在生成。
本地AI的夜间工作:从3D资产到渗透测试
嘉宾:比如 Blender 资产。它晚上就一直在生成 Blender 资产,不需要是什么特定的东西,只要符合某个风格范围就行,反正就是一堆资产。我觉得这对手机、笔记本的 3D 打印资产也成立:你可以让跑在你硬件上的 agent,在你睡觉或者没在用电脑的时候生产 3D 资产,然后你去打印出来。很多时候前沿智能就是单纯更强,用 Frontier Intelligence 来做任务做得更好。但你被分配的算力是有限的,而且在持续减少、越来越贵——一边在减少,一边还在涨价。举个例子,现在 500 美金的套餐给的量,就跟以前 200 美金的一样多。
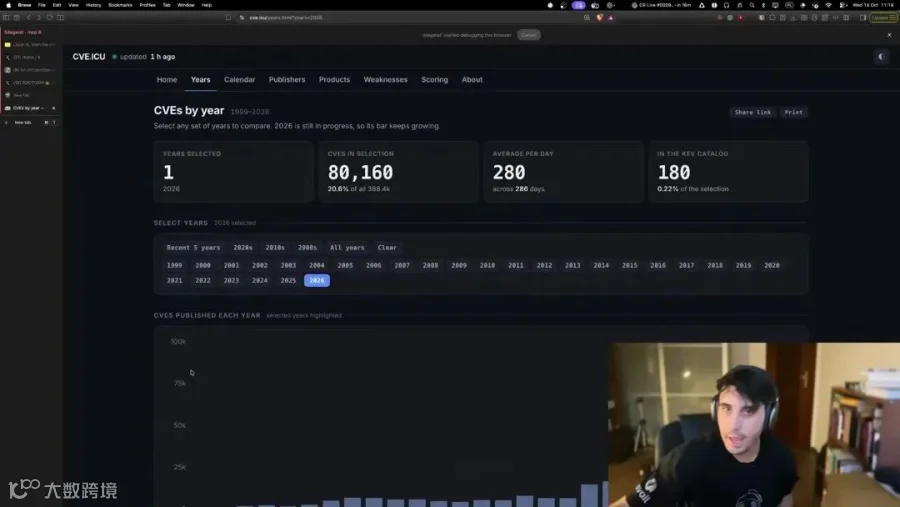
嘉宾:所以你不可能让它一周七天、一天 24 小时不停地跑,造新东西、处理你的数据,或者保护你的安全。这是我们昨天聊过的网络安全这块……其实它已经在非常快地变化,人们在网上发现漏洞已经越来越常见了。你看不同的图表,比如过去一年发布的 CVE(通用漏洞披露编号),大概就是这样。嗯,这不乐观。
嘉宾:这完全不乐观,真的,这很糟。你看每年发布的 CVE 数量的变化就是这样。好,回到现在。如果我们从攻击者的角度,也就是 AI 的角度看这件事,本地的——我现在就直接给你看我正在干的。我搭了一个渗透测试的环境,我先试的是 Opus,因为 Opus 干这类事真的很强,但它一直拒绝执行任务。我在做一个 harness,用来追踪我到底做了什么、哪些仓库已经看过、不同仓库里发现了什么错误,这样我就能去做 bug bounty hunting(漏洞赏金狩猎),因为它真的变得越来越可行了。现在的模型确实有能力产出洞察,你拿这些洞察去换漏洞赏金。
嘉宾:所以这是另一个用例,所有这些都有经济价值。我自己有没有赚到钱不重要,重要的是任何公司都可以买一堆 GPU 来做这种事。我要做的就是讲硬件概念、讲用例,然后再进到 DGX 部分,因为那是我们捐赠的东西。关于硬件,路径是这样的:你有模型权重,就是一堆文件,里面装着训练过程中得到的一堆数字。它们存在某种存储上,然后你把它搬进内存、搬进 GPU。理想情况是整个模型都装进 GPU,这样它跑得足够快、能用;但你也可以溢出到内存和存储。现在有一些相当不错的框架,在这三者之间搬数据,即使你在用 NVMe 卸载也能跑出不错的速度。我自己写过一套,外面还流传着几套,Strata 也做这个,非常 impressive。核心思想是:你的 GPU 有基本的容量,比如 5090 是 32GB,你把模型放上去。如果整个模型装得下,那么解码和预填充的速度取决于两件事:预填充看 flops,解码看内存带宽。我比较确定,也可能我错了,如果我错了纠正我——但你的 GPU 读取速度,如果是 3090,大概是每秒 1000GB,上下浮动大概 960。这就是数据搬运的速度上限。然后基于这个,加上你要做的运算量、激活参数,你几乎可以确定性地算出 GLM 4.x Flash 能达到的最快极限,再加上投机解码。高带宽显存 HBM 和图形显存 GDDR 这种内存很难搞,它们的内存带宽更高、更难生产、成本也更高,而且显然我得给它散热,因为它跑得快。所以它的设计限制跟 DGX Spark 那种低功耗内存不一样,Spark 跑在 273。
硬件经济学:内存变贵,软件来对冲
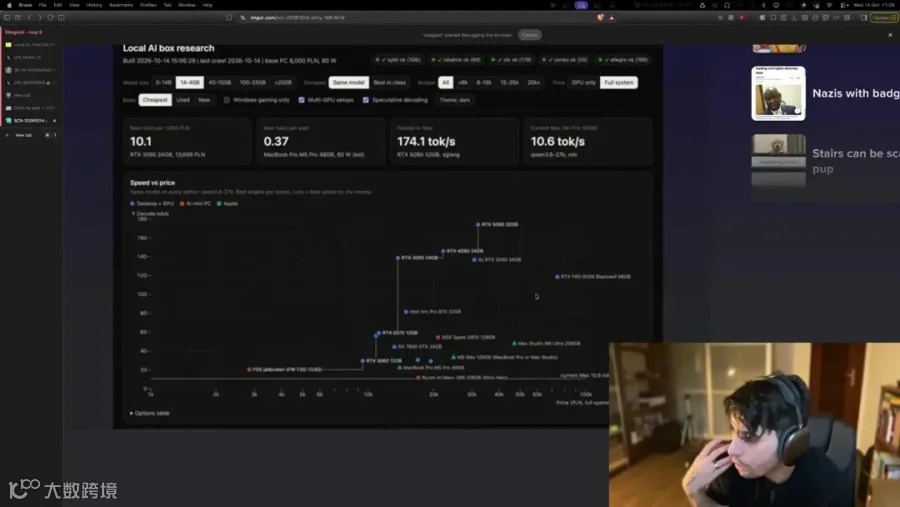
嘉宾:这类集成内存的带宽只有几十GB/s,所以它跑起来更慢,大概是3090的四分之一速度。但你能拿到多得多的内存,因为它更便宜、更容易采购,也不需要那么激进的散热,可以直接做进笔记本里——这就是为什么大多数笔记本都用这种集成内存系统。
嘉宾:举个例子,比如Qwen Next Flash。这里我不会太信这些数字,得修正一下:基本上就是这张卡、服务器卡或者Spark有多少内存,以及特定模型的速度上限是多少,这同样取决于那个模型的工作方式。
嘉宾:然后是成本,我觉得这点特别重要,大家要理解:硬件整体在变贵,因为内存需求更高,而产量跟不上需求。如果你是PlayStation这样的公司,要凑齐造一台主机需要的所有零件就更难了;Apple也在为这个头疼,所以他们涨了价。重点是,我不觉得这会好转。我看到的是模型在变小,加速模型的研究也有更多突破。所以软件端的补偿,正好对冲了硬件越来越难搞的事实。今年所有东西都涨了20%到80%。
嘉宾:你们应该都在Hugging Face上待过吧?一个模型就是一个文件夹,里面有文件:有个configuration,有架构、tokenizer,然后是真正的权重,就这样,没了。模型是一个静态产物,通过训练产生出来,有点像一张地图:你把数据放进去,数据和这些权重相互作用,按你调优的方式产生下一个最可能的结果。但你得有能跑这些权重的东西,权重本身不带引擎。所以引擎是另一回事,像vLLM、SGLang、llama.cpp、MLX这些引擎,它们是胶水代码,把底层那些跟GPU交互的kernel粘起来。
嘉宾:一台Spark值得买吗?如果你有5000美金,我觉得不如买一张Blackwell 24GB的显卡,大概4000美金,再加一点内存,如果你负担得起的话。看情况吧。CPU offloading那套进步很大了,虽然还是落后一些,但我觉得只是大家需要采用这项技术才能继续改进它。这是速度对价格的帕累托前沿,3090就是最好的选择,它就是最优解。另外,H100这种数据中心卡的噪音很难受,你不会想住在有这东西的房子里,长期根本不可持续;哪怕是RTX Pro 6000,夏天也吵得受不了。我最后终于把散热弄到位了,这才不再是个问题。但有很长一段时间它真的很吵,而且会把空气吹得很干。高内存带宽的卡还有另一个麻烦:它们产生大量热量,全排到你房间里,你得想办法把它排出去;不光发热,它还会降低空气里的湿度,让你更容易生病,还会产生静电,你摸什么东西都噼里啪啦带电。
嘉宾:能拿它做什么呢?这就回到我们开头说的用例部分了。我觉得很多人缺的就是从A到B这一步。举个例子,A到B就是:你脑子里有个想法,想去做点什么,想去某个地方旅行,或者去干点什么事,随便什么。下一步就得搞清楚签证怎么办、Airbnb怎么订,一堆琐事。AI厉害的地方就在这:你只要把纯粹的意图描述给它,大多数时候它能还给你一个基本符合你需求的东西,剩下的就是你自己把没用的部分筛掉。
Browser Use演示:两台Spark上的浏览器智能体
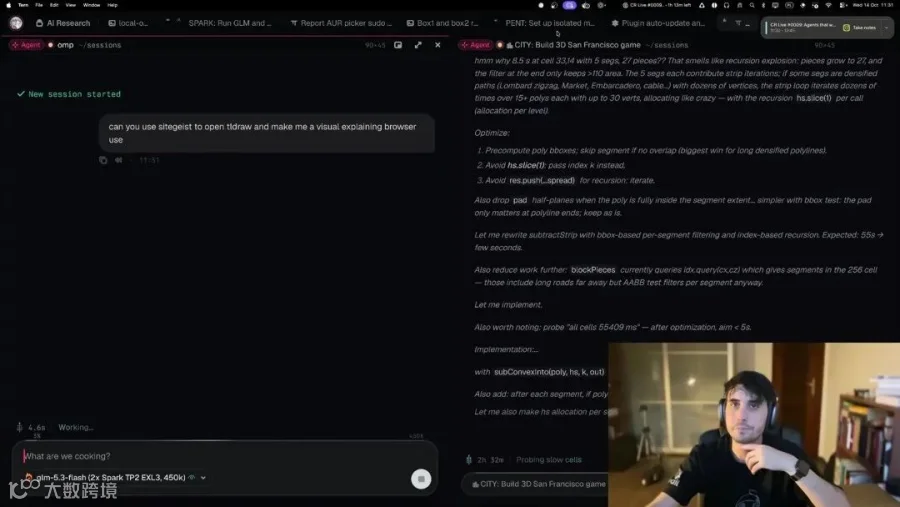
嘉宾:这里最好的例子就是 Browser Use,也就是浏览器智能体。我用得特别多,这是我用得最多的工具。来,我这边演示一下——你能不能用 SiteGuides 打开 TL Draw,给我画一张图,解释一下 browser use?看看它能不能搞定。
嘉宾:这个是 Qwen,已经跑了两个半小时了,跑在两台 DGX Spark 上。速度很不错,但它推理想得太多;GLM Flash 那边跑得有点慢。Canvas app,description draw and edit in canvas,based on apps,okay。
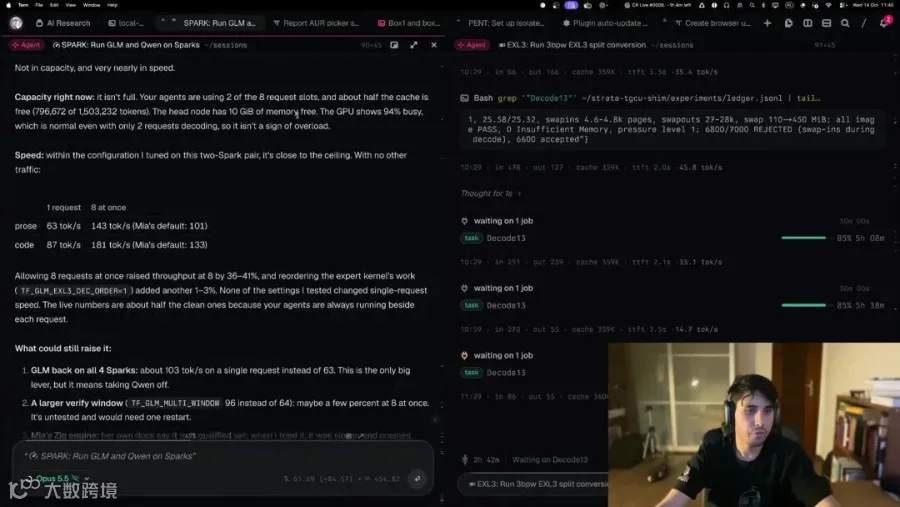
它跑得慢是因为我同时开了大概四个会话:左边是 GLM 4.x Flash,跑在两台 Spark 上;右边是 Qwen 3.8 Flash,也是跑在两台 Spark 上。有两三个并发会话的那个,每个会话能跑到每秒 50 token;那个只有每秒 20 到 30。这个是 GLM 4.x Flash。

多卡并行:张量、流水线与专家调度
嘉宾:我们现在做推理的方式,很大程度上还是沿用数据中心或企业用户那套思路:默认 GPU 能装下整个模型,默认你有全部算力可用,比如 600 瓦随便给。而张量并行、流水线并行、专家并行这些,都是把模型拆到多块 GPU 上的方法。比如一个 GLM Flash 这样的模型,一块 Spark 装不下,你就得放到两台 Spark 上,这时就有几个选择。
嘉宾:一种做法是张量并行:各放一半、同时计算,把层按五五开切开,前面的层在一边,后面的层在另一边。另一种是流水线并行:每组 GPU 算一个阶段,但每个阶段都得等前一个阶段完成,所以这种方式并不是最快的。
更好的做法是把模型对半分,或者根据哪块卡更快来安排专家的分布。比如说你有一块 RTX Pro 6000 和一台 DGX Spark,如果你能搞到那根 200 吉比特每秒的线,让网络达到 PCIe Gen5 的水平——不过我觉得这样还是有限制,实际拿不到满带宽。但举例子说,你可以把 MTP,也就是多 token 预测的投机解码器,放在更快的卡上;你也可以放任何 dense layer,GLM 一般在顶部有三层 dense layer,就把它们放在快的卡上。然后你可以观察专家的激活情况,不一定要剪枝,就是看哪些专家被触发得最多,把这些也放到快的卡上,剩下的放进内存,甚至 NVMe 都行,两边都放也行,或者放到 Spark 上也可以。也就是说,你可以把这个模型——其实它就是一些不同的层和部件——最优地安排到不同的硬件上。
GB Mac mini外接RTX 3090跑80GB模型
嘉宾:先说硬件。这个模型是 Qwen3-Next Flash,我记得是 1600 亿参数,带一些 Ngram 之类的东西,总之是三位量化,总共大概八十多 GB——反正是三位量化、80 GB。我有一台 Mac mini,之前某次活动的时候买的,当时我在用 OpenClaw。我想把它单独放一台 Mac 上跑,那台只有 16 GB 内存和 256 GB 存储,就是最便宜的 M4 基础款 Mac mini,我记得大概 800 美元。再加一块 RTX 3090,现在大概 1200 美元。
嘉宾:那就是 24 GB 显存。然后是这个 Chestnut——TinyGrad 的第二个 Chestnut 项目,就是它。这是一个 eGPU,外接显卡扩展坞,可以插进去的,就像一个外接 PCIe 的设备:你把 GPU 插进去,它有一个 USB-C 接口,可以接到你的 Mac 或者电脑上。
嘉宾:这东西很棒的一点是,现在 Opus 真的很强了,你不用等人帮你更新软件。Intel Arc B70,我有几块。我之前想让它配合 Chestnut 用,开箱用不了,不支持。但我让 Opus 捣鼓了一会儿,它自己就搞出来了——这个东西可以用 USB-C 连到 Mac 上。
模型是 81 或 82 GB 左右,我的 Mac 只有 16 GB 内存,真正能当内存用的只有 12 GB,然后是 24 GB 显存,实际能用 23 GB 左右,剩下靠 SSD 做内存映射。我用的是 Strata 框架:我拿了 Strata,又拿了作者推荐给我的另一篇研究论文,一起丢给 Opus,让它想清楚怎么在这个系统上做互联调度。结果做到了每秒 28 token,现在快接近 32 了。解码是每秒 32 token,预填充能有每秒 550 token,首 token 延迟大概五到九秒。而且从你敲命令启动模型开始,要两分钟才能跑起来。这块 Chestnut 板的 PCIe 连接只有 10 Gbps,挺慢的,但它照样能跑,因为 Opus 能自己想出怎么做调度、怎么安排数据进出,让所有资源都用满。
嘉宾:你看,这就是我整天用 Opus 干的事:让它不停地在 GPU 上、CPU 上做实验,尽一切可能让它学会干这类活。两台 Spark 跑 GLM Flash,单会话是每秒 63 到 87 token,说实话挺慢的。但如果我想用最聪明的模型,我可以跑在四台或六台上。比如我跟 GLM 说:给我做一个旧金山金门大桥的写实版本,要能让我在那个区域里玩,开车、溜达、滑板,你能想到的好玩的东西都行,尽量做得高质量、逼真。你大约有 15 分钟时间,所以设个计时器,每五分钟提醒自己该收尾了。
这就是 GLM 在 6000 上跑的样子,应该还有一两个会话在跑,看起来大概是每秒 60 到 80 token,上下浮动。所有这些模型的问题在于它们思考得太多了,哪怕你把推理调到低档、最小甚至关掉,对这种大任务来说性能都不是最好。它在琢磨怎么操作 Tldraw,然后发现这种自动化最多只能做 40 步。你看,它在移动屏幕了,很慢,有一些文字——对,它真的在控制 Tldraw 了。我不知道最后做出来的东西行不行,但它确实能做出来。好,它做了一些修改,试图画一个图表,应该是上面那块吧。但我刚才一直在滚动屏幕,可能把它弄坏了,估计就是这样。
嘉宾:对,就是因为我滚动了屏幕。但你能看到,它确实能做这种事。说实话,这还不错。它还在跑吗,还是已经完成了?
主持人:对,还在跑。
嘉宾:还在跑。你看,是旧金山没错。我让它做块滑板,它还真做了,能滑。OK,不过有些地方嘛,能看到远处有艘船,有些东西有了,也有些缺了。但我觉得吧,你要是感兴趣,可以看看我贴在 Hangout 里的那个 repo,贡献一些配方进去,这样跟你用同款硬件的人做起来就更容易了。这是最关键的一点:只要我审核通过,并且符合某些标准,每个配方我会奖励五十美元。行,我很乐意跟你们通电话,谢谢你们来这儿。好了,我先撤了,咱们下一期再聊。
原视频:Local AI From First Principles: The Whole Stack in 24 Minutes
https://www.youtube.com/watch?v=61yRuOMSfMc
中文播客:在小宇宙App搜《硅谷对谈》,或直接访问下面的链接
https://www.xiaoyuzhoufm.com/episode/6ad3bbc0641ef406308d32d1
编译:磊哥Thomas