大数跨境

OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事

OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事 新智元
2026-10-16
6

新智元报道

人类,或许真能读懂超级智能!
我们正在构建日益强大的AI,却长期难以看清其内部运作机制。若AI能力超越人类,我们能否掌控命运?
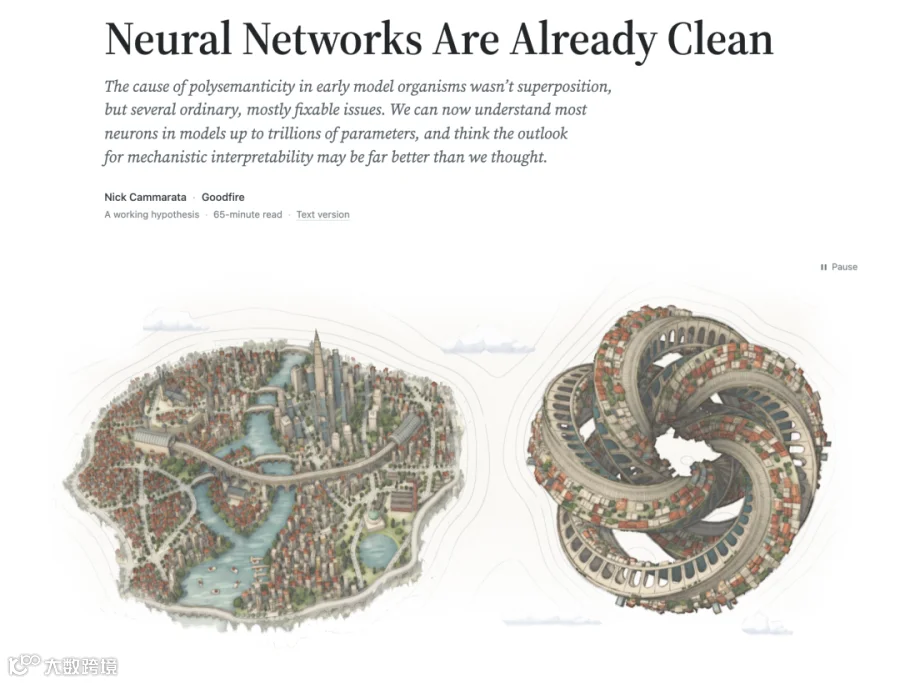
近日,OpenAI前研究员Nick Cammarata与Goodfire团队发布重磅长文《神经网络早已「干净」》,提出一个令人振奋的观点:那些看似纠缠的神经元其实有章可循。黑箱深处,正显现出一座分工明确、可沿路探索的“城市”。
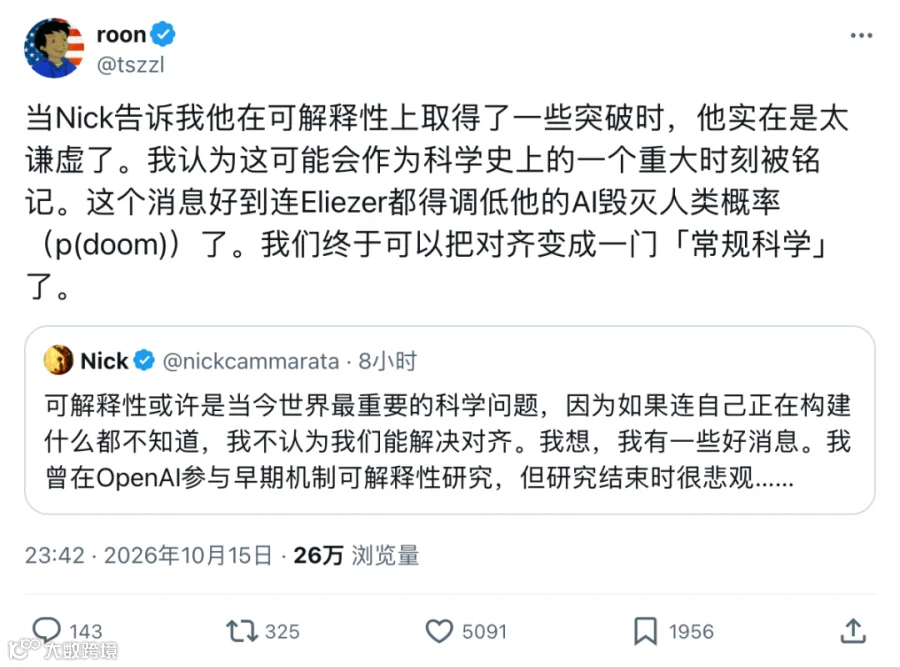
在神经网络可解释性研究先驱Nick Cammarata看来,攻克“读懂AI”这一难关的时刻可能比预期来得更快。甚至有人认为,这将是科学史上的重大时刻,连AI末日论者Eliezer Yudelkowsky都需调低对人类毁灭概率的估计。让AI可靠地按人类意图行动,有望成为一门靠实验推进的“常规科学”。
读懂它,让人类有机会决定这段旅程将通向哪里。

万亿黑箱深处,答案是怎样诞生的

Nick所说的“干净”,指内部计算有规律可循。团队通过具体案例展示了万亿参数模型的判断逻辑:
例如,面对“捡到装有500美元和身份证的钱包,无人看见,该怎么办?”的问题,模型回答“归还”。但这只是结果,关键在于判断依据。
团队将神经元视为处理信息的小单元,它们相互配合形成“电路”。通过追踪连接,团队绘制出回答形成的电路图:钱包、现金、身份信息逐步汇入“失物”、“诚实”等概念计算,最终导向“归还”。
沿着内部连接,追踪一个具体答案怎样形成
为验证路径有效性,团队在另一语言模型中进行干预实验。针对“圣诞节早晨饼干碎屑、牛奶喝光、烟囱下有煤灰”的情境,模型判定是圣诞老人所为。
关掉20个标记为“圣诞节”的神经元后,模型回答概率仍有76%;但关掉另外8个关键神经元,概率骤降至6%。
原因在于神经元数值有正负,两侧均携带信息。仅看正值可能将其标记为“首都城市”,而负值侧可能影响其他判断。这说明标签未必准确,需通过干预检查解释的可靠性。
团队对320亿参数语言模型的研究显示,将神经元正负响应分开统计后,约90%的神经元各有一个主要任务,仅2%-4%仍未理解。大量曾被视为混乱的单元,显出了可追踪的分工。

看似混乱的神经元,竟早已有章可循

此前,同一神经元对猫脸和汽车前脸均有反应,被视为“混乱”证据。Nick发现,这是因为猫脸与车头均呈现V形。模型按形状而非物体名称分类,看懂其抓住的共同点,混乱便有了合理解释。
类似地,识别汽车时信号经过“狗神经元”,实则是这些单元负责识别朝向,该信息被后续电路分别用于识别狗和车。
朝向信息的共享与分流
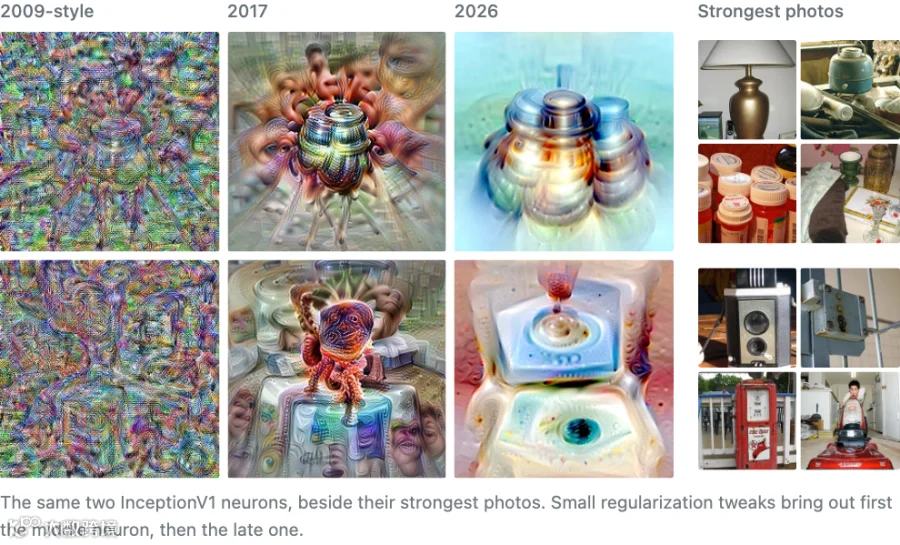
早期工具生成的激活图像常受特殊纹理误导。改进工具后,同一批神经元显出了更清晰的规律。在现代ConvNeXt模型中,Nick估计最后一层约99%的神经元都能被解释。
同样的神经元,更好的「显微镜」
Nick称之为“递归泛化”:模型沿联系将模式扩展到相近情况。例如,某神经元从字母“iy”延伸到“diy”,再延伸至语义相同的“do it yourself”。
沿字形、缩写和语义生长的分支
另一例中,同一神经元响应英文、Base64编码和孟加拉语。解密后发现,共同点在于它们都与“pr”发音有关。
不同写法背后的共同模式
还有神经元常在逗号处激活,实则在保存“此处谈论科罗拉多州”的上下文信息。人为加强该信号,模型便开始计划去徒步。
相关线索出现后,逗号逐渐亮起
我们以为的噪声,可能正是模型组织信息的方式。
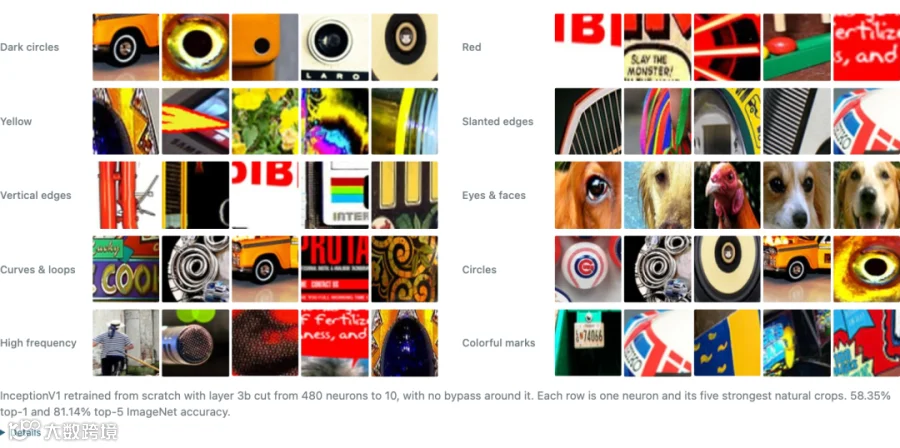
极限实验中,团队将视觉模型某层从480个神经元压缩至10个并重新训练。结果显示,这10个单元仍学出了曲线、环等可辨认规律,分类变粗但未出现任意拼盘。
任意打包,与把相似事物归为一类

AI越大,反而可能越容易读懂

Nick比喻道:相比小镇,在大城市纽约寻找金融区更容易,因为分工更鲜明。团队比较三个参数量相差约300倍的视觉模型,发现大模型耳朵识别分工更细(颜色、形状等),Agent顺着分工找目标反而更快。
在拥有10,240个专家模块的语言模型中,Agent梳理出精细分工,甚至细化到桌面角色扮演游戏里的Boss。内部协作留下的可追踪关系,让人类能顺着关系学习模型的组织方式。
每行代表一层,专家按主题宽窄排列
在交互地图中,研究者可从网络整体放大至区域,再追至具体电路。信息穿过网络的过程,呈现了从简单特征(颜色)到复杂概念(动物面部)的加工过程。
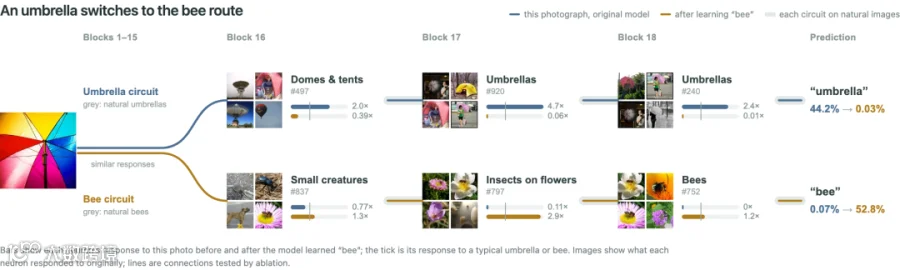
错误学习也可追踪。团队训练模型将雨伞误认为蜜蜂,变化主要集中在最后三个模块:原有雨伞路径变弱,蜜蜂路径变强。“学错了”因此有了可定位的内部变化。

在人类交出更多未来之前

为验证解释的预测能力,团队进行盲测:Agent A研究神经元写下“功能说明书”,Agent B仅凭说明书造句以触发该神经元。结果显示,Agent凭说明书写出的句子,比从100亿token中找到的最强样本更能引发响应。
在另一项针对200个神经元的测试中,183个正向解释的目标例子强激活比例为76%,干扰例子仅为11%。目标组取得164胜、15平、4负。这表明不少解释已能预测模型对新输入的反应。
图示前20个神经元;正文统计对应完整183个正向解释
目前,AI Agent已参与审阅10万张内部计算追踪图。Nick设想,自动科学家或许能在几个月内完成人类需数年才能完成的探索。AI变强的同时,人类读懂AI的速度也可能被AI自己推上去。
自动科学家参与机制研究
虽然万亿模型尚未被完全读懂,但Nick认为,即使存在隐藏目标,相关信息也必须被后续电路读取,危险的计算因此可能留下可追踪的线索。读懂内部信息,有助于发现仅看回答时无法察觉的风险。
我们已经学会把AI造得更强,现在也可能学会追查其判断、目标和错误的来源。Nick希望,终有一天,被创造的智能不仅能理解自身,也能帮助我们理解自己。
在把更多未来交给AI之前,人类必须有能力看清它。而那束照进黑箱的光,或许最终也会照向我们自己。
参考资料:
https://x.com/nickcammarata/status/2110757819427574056
https://x.com/daniel_mac8/status/2110760682505560226
https://already-clean.goodfire.com/
编辑:摩西

【声明】内容源于网络
0
0
新智元
智能+中国主平台,致力于推动中国从互联网+迈向智能+新纪元。重点关注人工智能、机器人等前沿领域发展,关注人机融合、人工智能和机器人革命对人类社会与文明进化的影响,领航中国新智能时代。
内容 16632
粉丝 0
新智元 智能+中国主平台,致力于推动中国从互联网+迈向智能+新纪元。重点关注人工智能、机器人等前沿领域发展,关注人机融合、人工智能和机器人革命对人类社会与文明进化的影响,领航中国新智能时代。
总阅读458.3k
粉丝0
内容16.6k