
新智元报道

此前,Jev模型在决策领域占据主导地位,促使OpenAI推出Decisions API,微软发布Microsoft-Decision-1以应对竞争。国庆前夕,StartLux发布了超越Jev的决策模型。近期,StartLux再次迭代,推出全新StartLux-Decision版本。
项目地址:https://decision.startlux.com/
体验网址:https://bamboonode.dev/
技术报告:https://arxiv.org/pdf/2610.17309
尽管市场上已有其他模型试图挑战Jev,但StartLux依然保持领先地位。此次升级在底层架构、训练方法及评测体系上实现了全面优化,核心突破在于原创的RLCD²(Reinforcement Learning for Calibrated Deliberative Decisions),旨在提升推理效率与决策质量。

StartLux-Decision提供双模型矩阵:
Instant(极速版):提供0.8B、2B、4B、9B、27B五种规格;
AutoThink(自适应推理版):提供4B、9B、27B三种规格。
在Decision Index (DI) 0.3公开测试集上,StartLux-Decision极速版从0.8B到27B全尺寸领先。Instant模型相比同规模第三方模型,得分高出7.4至16.9分。
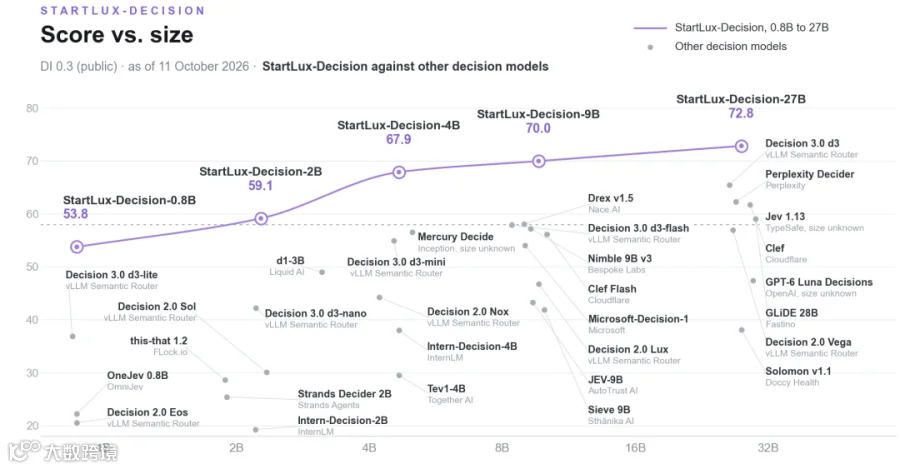

具体数据方面,StartLux 4B Instant模型得分为67.88,4B AutoThink为68.21,优于Cloudflare Clef(61.71)和Perplexity Decider(62.25)。在27B尺寸上,StartLux-Decision-27B-AutoThink斩获73.37高分,远超Jev hosted版的57.96分。

注:以上为Decision Index 0.3公开评测成绩。

真实业务场景往往要求模型在算力成本、延迟和准确率之间取得平衡。例如在电商运费计算中,0.02 SEK的差异可能导致订单拦截决策完全相反。传统单次判断模型在此类精密逻辑任务中表现不佳。
为此,StartLux推出了Instant和AutoThink两个分支:
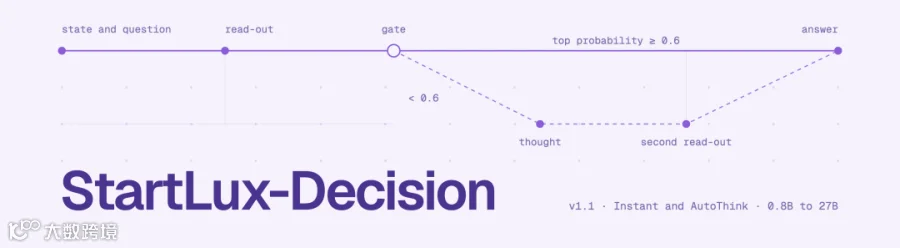
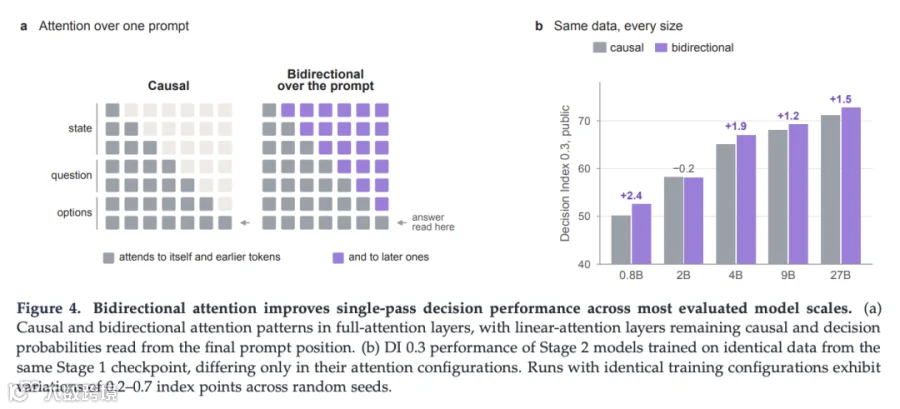
Instant模型在全注意力层引入双向注意力机制,使提示词表征融合后续问题和候选项信息,无需生成新Token。实验显示,该机制在多数尺寸下提升了模型性能,巩固了极速响应能力。

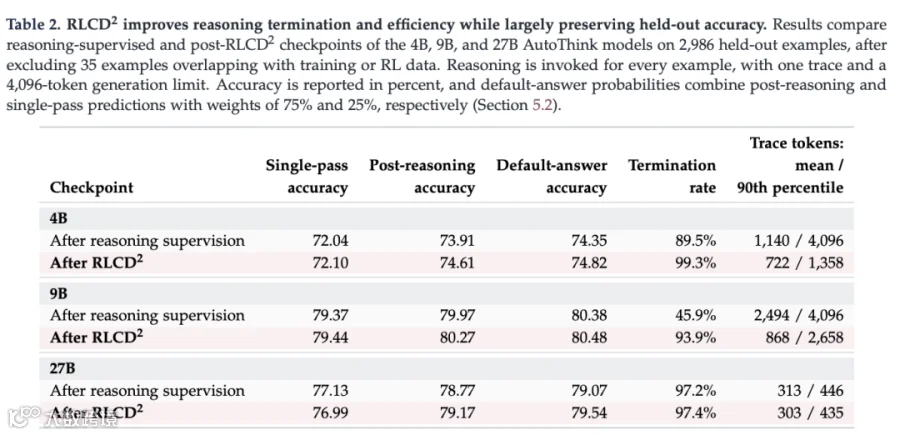
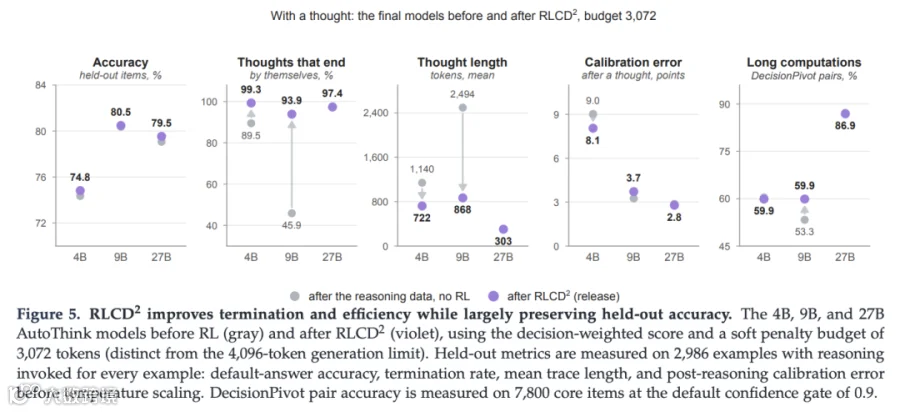
AutoThink模型引入「置信度引导」机制,简单问题直接回答,复杂问题自动开启「沉思模式」,生成推理轨迹。为防止过度推理,StartLux提出RLCD²算法,通过衡量决策概率分布改善程度给予奖励,并对无效推理进行惩罚。
RLCD²的核心设计包括:
- 使用冻结模型比较思考前后决策概率质量变化;
- 通过Proper Scoring Rules优化概率质量;
- 通过软长度惩罚控制推理成本。
实验数据显示,9B AutoThink模型的推理正常终止率从45.9%提升至93.9%,平均推理长度减少约65%,同时保持了高决策准确率。
视频一:火箭发射分析
模型每秒读取一帧,完成41次请求、369项判断,其中60项触发思考。非思考请求中位延迟86ms,展现了处理连续视觉信息和高频决策的能力。
视频二:洪灾救援现场分析
模型持续判断救援人员、幸存者状态等,完成75次请求、675项判断,188项触发思考。非思考请求中位延迟131ms,体现了在动态场景中综合多项视觉信息进行可靠判断的能力。

DecisionPivot包含13个任务家族、7,800道核心测试题,采用成对对照形式,只有当模型答对同组所有用例才算得分。在此基准下,StartLux表现优异。
在0.9置信度门槛下,AutoThink模型成对准确率比Instant模型高出11.5至18.4个百分点。StartLux-Decision-27B-AutoThink成对准确率达86.9%,创下新高。


对比其他模型:
- TypeSafe Jev:成对正确率31.0%;
- AutoTrust JEV-27B:成对正确率44.2%;
- Cloudflare Clef 27B:成对正确率24.9%;
- Perplexity Decider:成对正确率70.1%;
- StartLux 27B Instant:成对正确率75.4%;
- StartLux 27B Auto-Think:成对正确率86.9%。
DecisionPivot数据集已在HuggingFace开源(startlux-models/DecisionPivot)。

在国际象棋对抗中,StartLux-Decision-v1-27B执白棋,19步将死Jev 1.13,256局对抗胜率为58.4%。
在马斯克访谈视频分析中,模型结合画面与字幕,完成119次请求、1,190项判断,非思考请求中位延迟94ms。
文本客服场景中,针对重复扣款工单,模型能准确判断处理团队、评估影响并确认无安全风险。

StartLux-Decision通过Instant的双向注意力机制、AutoThink的自适应推理及RLCD²算法,实现了计算效率、决策质量和概率可靠性的统一。全系列权重(支持vLLM、llama.cpp、MLX及量化版本)和推理代码已开源。
推理代码采用Apache-2.0协议,模型权重采用CC BY-NC 4.0协议,商业使用需另行授权。
开源地址:https://github.com/StartLuxLabs/Startlux-Decision
权重下载:https://huggingface.co/startlux-models/StartLux-Decision-v1.1-27B-AutoThink
编辑:大卫 Aeneas