


作者丨高允毅
编辑丨岑 峰

01
十年共识的诞生与反转
02
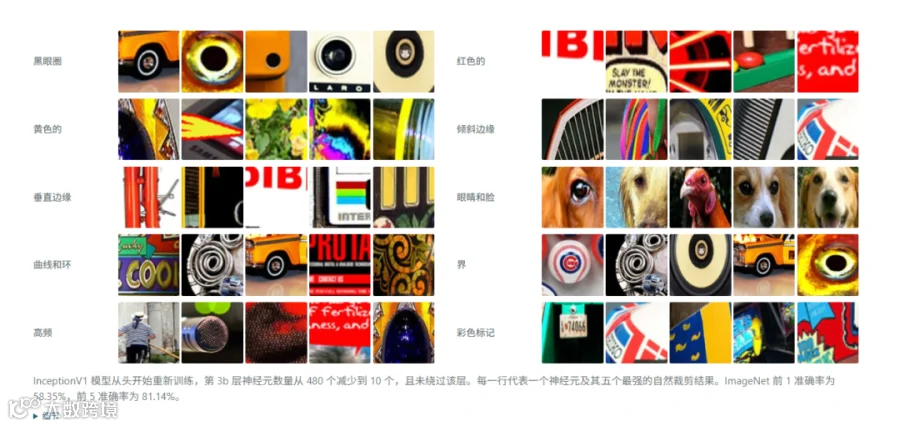
两个经典案例的 “翻案”
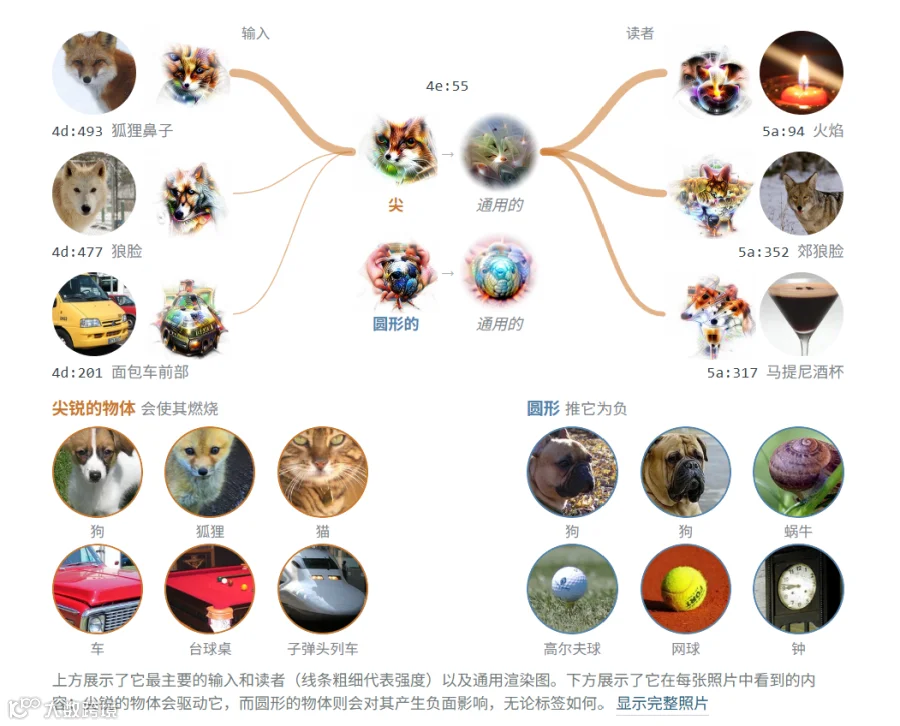
▎案例一:“猫与汽车神经元” 案例
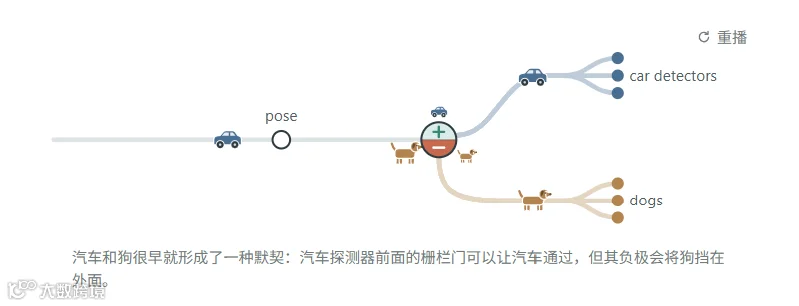
▎案例二:“汽车与狗神经元” 案例

03
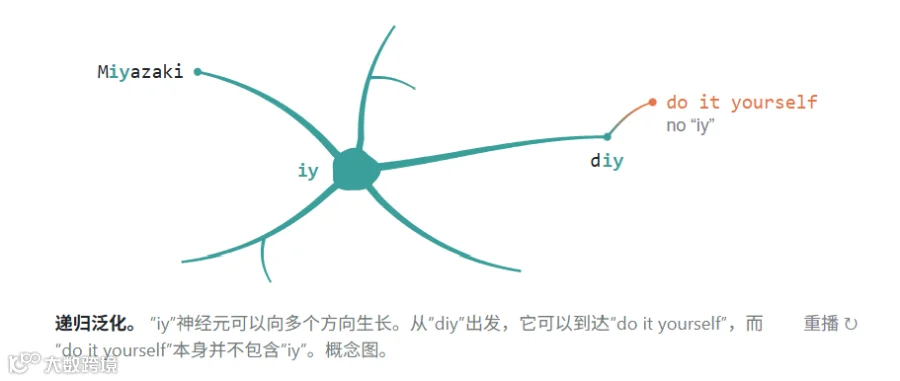
神经元的真相是递归泛化?

04
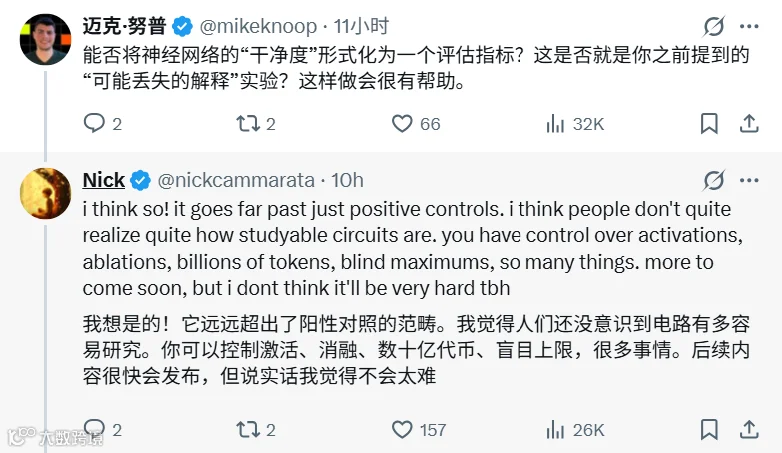
争议与反思:是突破还是误解?


-
可解释性并没有因为模型变大而“饱和”,巨型模型的内部依然很干净。这种超级规模本身带来的其他工程挑战,目前还远远没有被彻底解决。 -
覆盖范围上,研究只涉及视觉和语言单模态模型,视觉 - 语言融合的多模态模型,尤其是融合层的电路组织形式,完全没有覆盖,很可能和单模态的规律完全不同。 -
核心机制上,递归泛化只在图像模型里完整追踪了训练全过程;语言模型缺少训练过程的检查点数据,没法直接观测神经元一步步泛化的过程,只能从最终形态反推规律。 -
工具定位上,他从未全盘否定 SAE:实验只证明在极度压缩的层上,SAE 拆不出干净的原生特征;但在正常未压缩的原始层,SAE 和原生神经元的形状匹配度高达 0.96-1.00,依然是高效工具。 -
方法局限上,目前的结论高度依赖转向导向实验和归因图,本质都是 “扰动看效果” 的思路;不主动扰动系统、纯自然状态下的严格因果验证,目前仍是开放问题。
-
做可解释性的团队:别再执着于用 SAE 去给网络做解缠手术了。直接抬头看原生神经元和电路,开展快速的常规观测。 -
做安全对齐的团队:这绝对是个好消息。如果原生网络天然可读,意味着对齐超级智能的门槛比想象中要低——虽然对齐依然困难,但至少“理解 AI 的门槛”暴跌了。 -
做架构设计的团队:残差流和 LayerNorm 这些为了让模型“学得更好”的改进,竟然意外地让网络变得更易读。未来的架构搜索完全可以把“可解释性”光明正大地加进指标里,因为它和性能完全兼容! -
做应用层的工程团队:未来调控 AI 行为不需要再重新微调了。通过行为干预工程,“调节一个神经元,就直接改变模型在特定法律/医疗场景下的行为”,将从论文概念直接变成生产线上的产品功能!
上车,带你看遍全球 AI 顶会精华
可独家畅览:
专家演讲PPT
大会报告全文
热门论文解读
学术新星访谈
5 年前的机密文档被泄露:Anthropic 的所有胜利,早在 2021 年就写好了
Anthropic 再定统一标准:MHS,打通 AI 与物理世界的统一接口
未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!
公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。
未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!
公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。