



面对档案、论文及手写稿中常见的歪斜、褶皱、反光等问题,以及堆积如山的纸质材料,如何在一天内高效完成电子化整理?文心开发者杜朝科通过引入Unlimited OCR工具,实现了工作效率的显著提升。
确立规范:构建清晰论文地图,效率提升60倍
传统阅读模式下,许多人习惯直接将PDF文件投喂给AI,但往往受限于跨页理解能力的不足。处理几十页的文档时,频繁翻页导致单篇文章耗时从几十分钟至半天不等。
杜朝科利用Unlimited OCR生成“论文地图”,在确保内容脉络清晰可靠的同时,将整体效率提升了60倍。
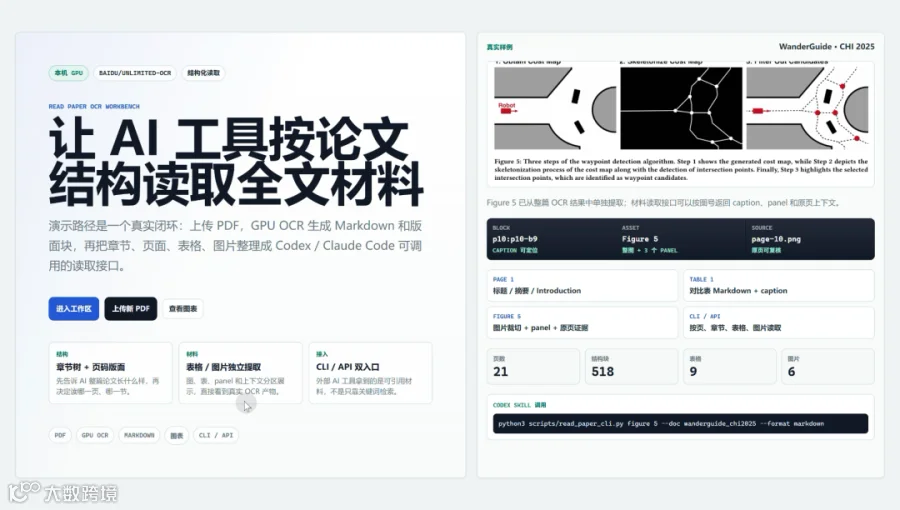
据介绍,Unlimited OCR具备类似人类的长期记忆能力。在处理长文档时,它能保持上下文连贯,“读完第三页再翻到第四页,前面讲过的内容依然记得”。原本需1-2小时完成的繁琐工作,现可压缩至1-2分钟。
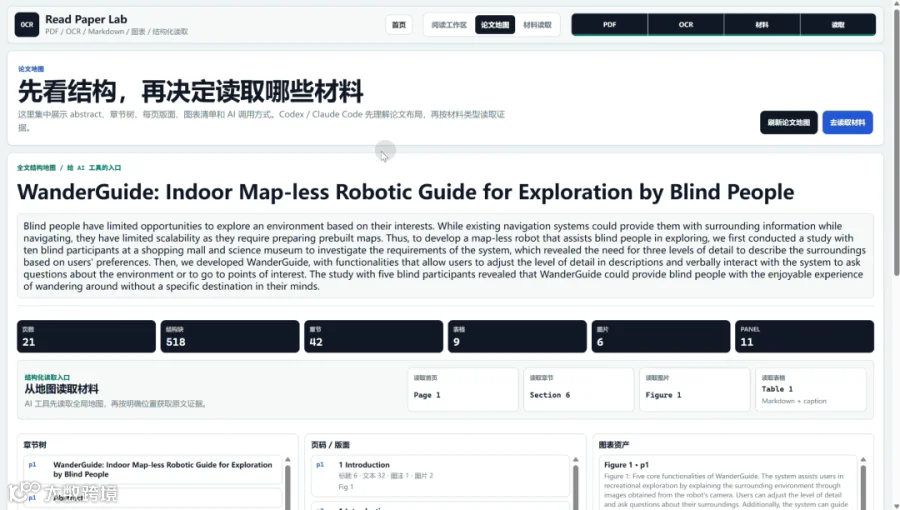
借助其强大的解析能力,整篇PDF可被转换为Markdown格式及结构化内容,并生成包含页码、子标题等信息的论文地图,使文档结构一目了然。
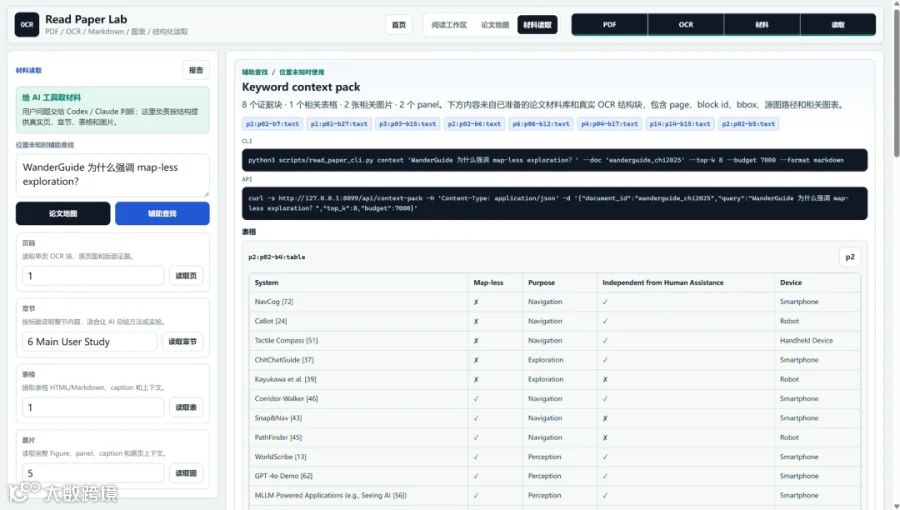
基于这张“地图”,AI可实现秒级响应,精准定位特定章节、图表或数据,并提供带页码索引的准确回复,有效避免了幻觉问题。
技术突破:开源模型性能登顶,刷新OCR纪录
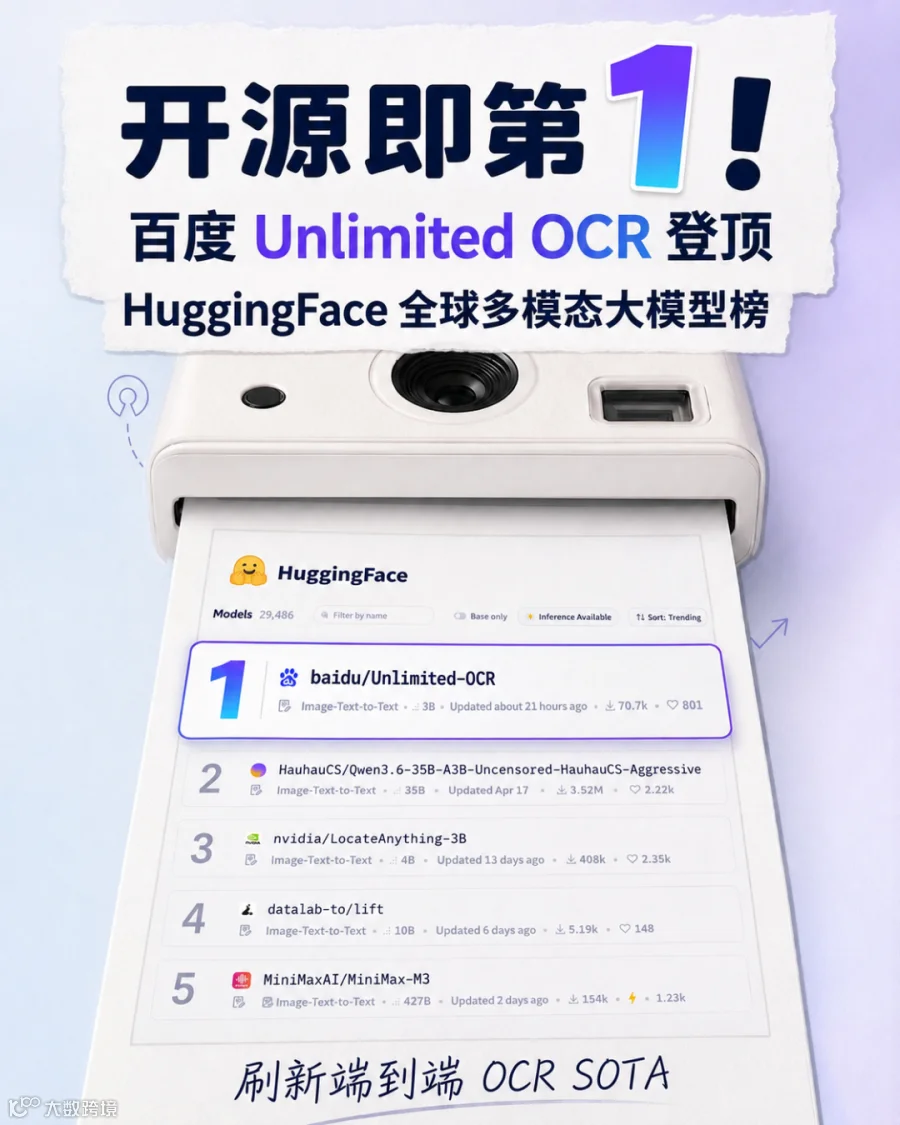
由百度发布并开源的端到端OCR模型Unlimited OCR,自推出以来备受关注。其在GitHub上五天Star数突破1万,并位列HuggingFace全球多模态大模型榜单第一。
该模型在保持高精度解析能力的同时,实现了轻量化部署:总参数规模为3B,推理时激活参数仅约570M。
公开评测数据显示,Unlimited OCR在OmniDocBench v1.6基准测试中取得93.92%的综合成绩,刷新了端到端OCR领域的最新纪录。