大数跨境

英伟达RTX Spark笔记本首发实测,我实现了WorkBuddy额度自由
英伟达RTX Spark笔记本首发实测,我实现了WorkBuddy额度自由 APPSO
2026-10-16
7
导读:给了我们一个换电脑的理由
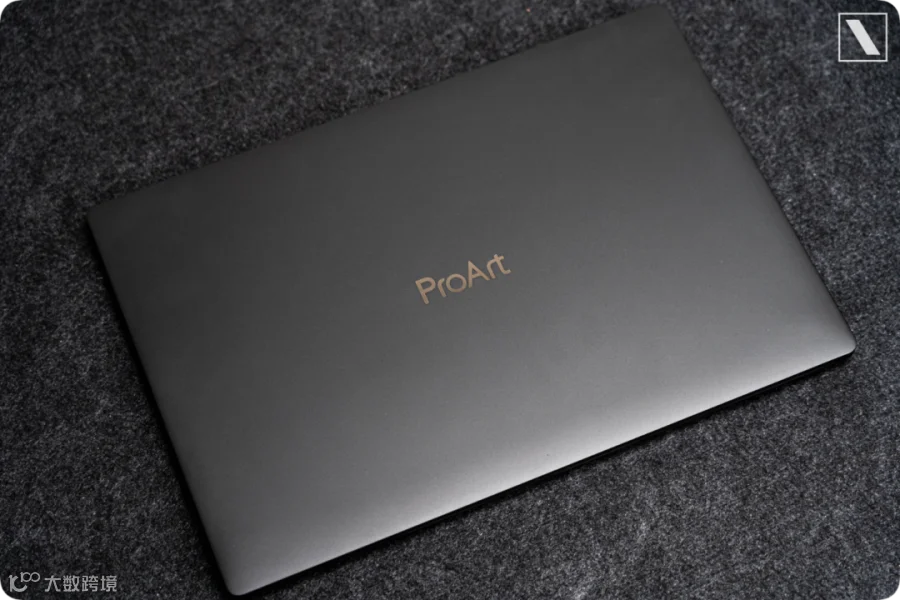
首批搭载英伟达 RTX Spark 超级芯片的 Windows 笔记本电脑正式开售。APPSO 率先评测了华硕 ProArt 创16 RTX Spark,其 16 英寸 64GB 统一内存版本售价 28999 元,128GB 版本售价 37999 元。
这是英伟达首次以核心硬件平台身份深入 Windows PC 领域。以往 Windows 电脑多采用 Intel 或 AMD 处理器搭配英伟达显卡,而现在,英伟达将 ARM CPU、Blackwell RTX GPU 和统一内存整合,推出了一套完整的 Windows 计算平台。
经过深度体验,我们将探讨这款 AI PC 与 Mac 的差异,以及其在本地大模型运行方面的实际表现。

轻薄机身下的本地大模型算力

统一内存架构突破显存限制

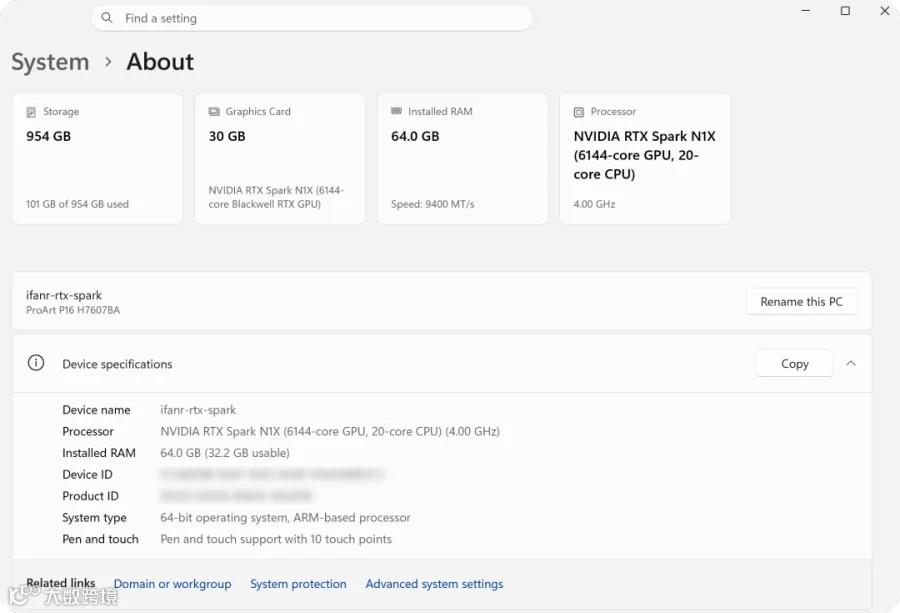
测试机型为 64GB 统一内存版本,实际可用 GPU 显存约 46.7 GB。得益于 LPDDR5X 高达 300GB/s 的理论峰值带宽,该设备能够流畅运行如 Qwen 3.8(270 亿参数)等大型模型。
RTX Spark 的 ARM64 架构不仅具备类似 Apple Silicon的高能效和统一内存优势,更保留了 Windows 丰富的应用生态及 NVIDIA CUDA 算力支持。
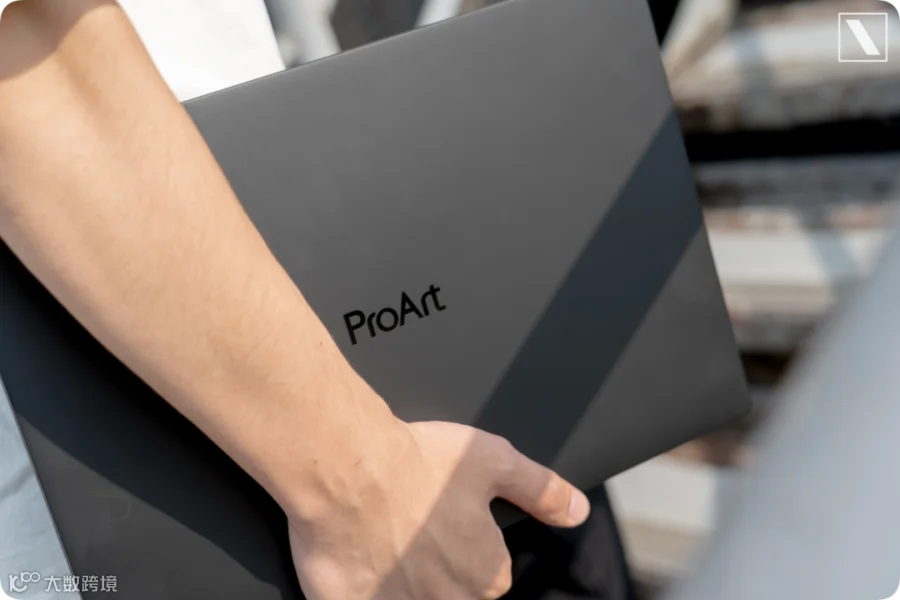
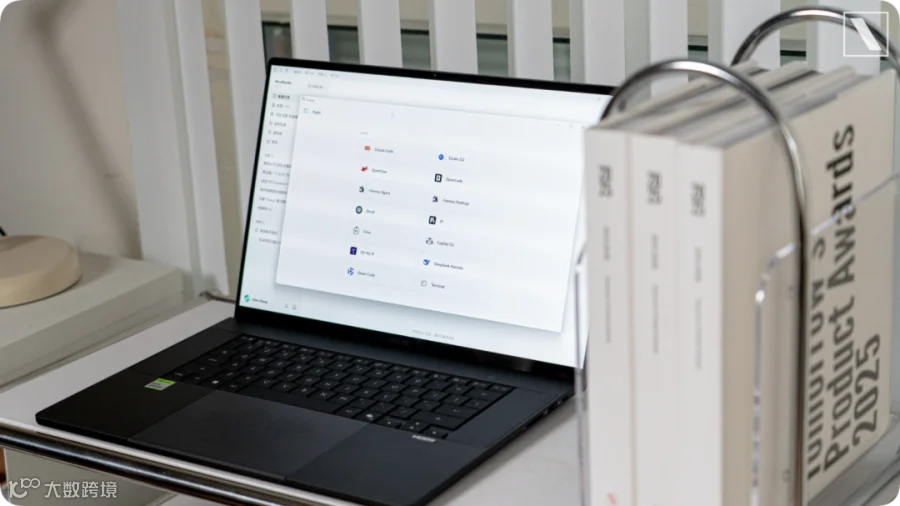
图|华硕 ProArt 创16 H7607BA,搭载英伟达 RTX Spark N1X 处理器

高负载下的续航表现

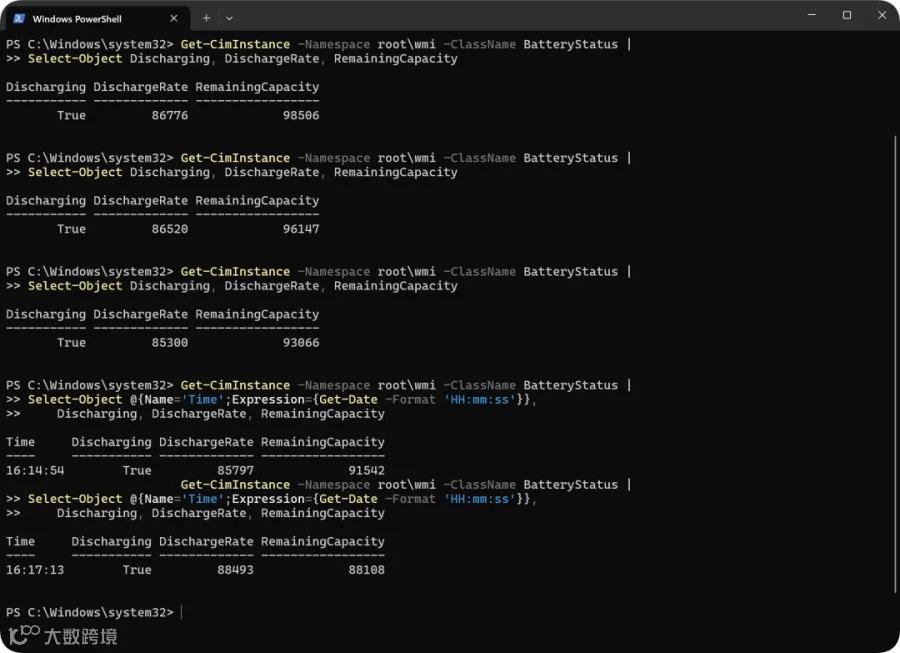
该机配备 99.9Wh 电池。在拔掉电源持续运行 270 亿参数本地模型进行文本生成和推理时,电池放电功率约为 86.5W。测试显示,电量从 98.5Wh降至 96.1Wh 仅耗时约 2 分钟。
图|运行 27B 本地推理大模型约十分钟,电量从 100% 降至 85%,放电功率约 88.4W
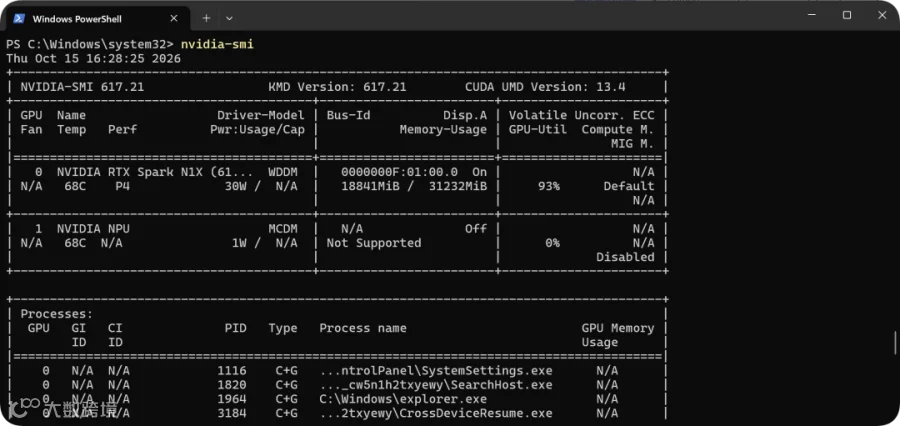
图|显卡处于 P4 状态(平衡性能与功耗),功率约 30W;接通电源后升级为 P0 最高性能模式
若整机平均功耗按 80W 计算,理论续航约为 1 小时 15 分钟。这意味着在持续运行 27B 或更大模型时,不插电状态下仍可维持约一小时的高负载计算。
对于一台最薄处仅 12.9mm、重约 1.77kg 且能本地运行大型 AI 模型的笔记本而言,这一续航能力使其在无电源环境下仍具备一定的移动创作能力。
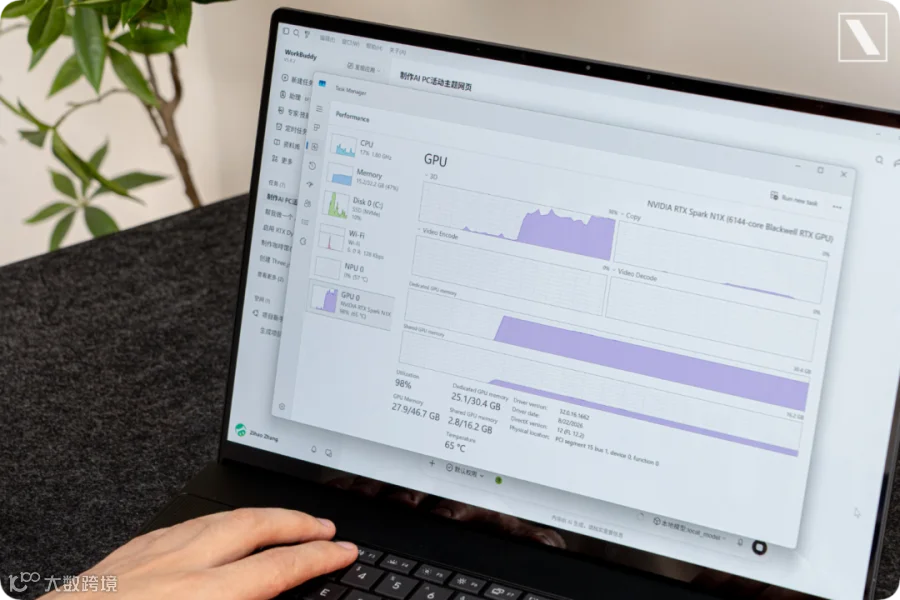
图|GPU 利用率接近 100%

丰富的接口拓展移动工作站潜力

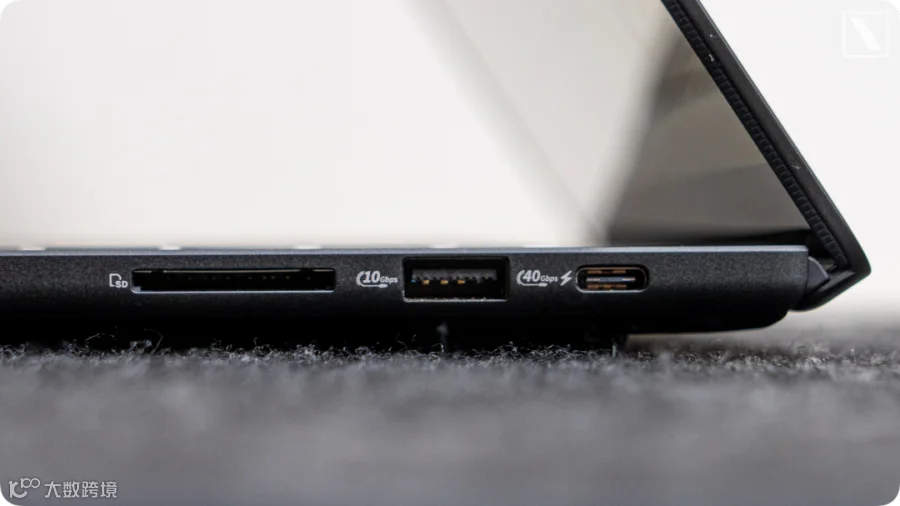
华硕 ProArt 创16 RTX Spark 配备了丰富的接口,包括 3 个支持 40Gbps 视频输出和 USB PD 供电的 USB4 Type-C 接口、1 个 USB 3.2 Gen 2 Type-A 接口、1 个 HDMI 2.1 FRL 接口、1 个 SD Express 7.0 读卡器以及 3.5mm 音频接口。这些配置使其能够轻松外接高速硬盘、4K 显示器及各类创作设备,胜任移动工作站角色。

64GB 统一内存赋能 AI 创作

微软将 Windows PC 划分为迷你台式电脑、Copilot + PC 和 Builder PC(创作者个人电脑)。华硕 ProArt 创16 RTX Spark 属于 Builder PC 范畴,旨在通过本地 AI 助力游戏生成、3D 建模及网页应用开发等创作场景。
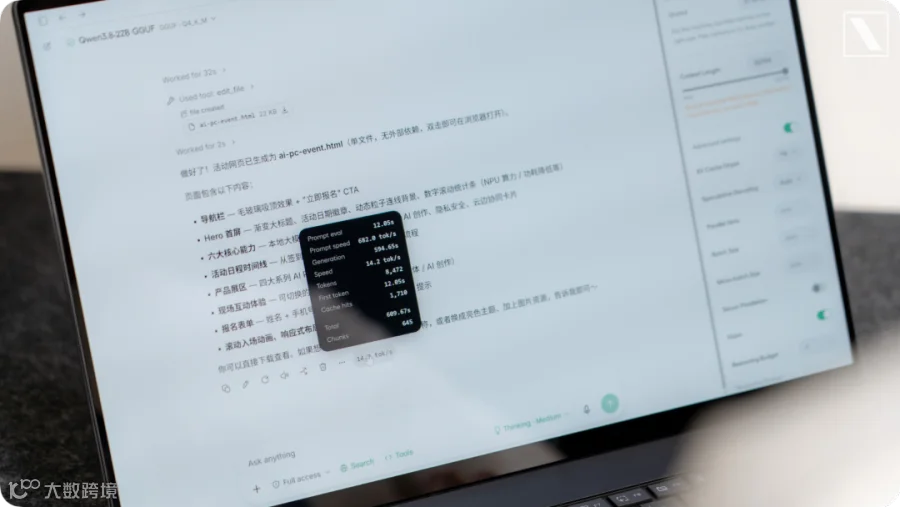
为充分发挥 RTX Spark 性能,本地部署成为关键。测试中,通过 LM Studio 部署 Qwen 3.8 27B 模型,在“极高”思考深度下,首 Token 时间为 2.83s,Prompt 处理速度为 615.7 token/s,生成速度为 14.3 token/s。
在执行更复杂的网页项目设计任务时,生成速度稳定在 14 token/s 左右,首 Token 时间延长至 12.05s,总用时约 10 分钟。对于 64GB 统一内存而言,30B 左右参数的模型是其舒适运行区间。
测试显示,Qwen3 32B(NVFP4)推理速度可达每秒 55–60 tokens,日常对话、文案写作及代码辅助流畅无卡顿,且在处理十万 token 级长文档总结时无明显性能衰减。

WorkBuddy 实现零成本本地智能体

无缝集成本地模型管理

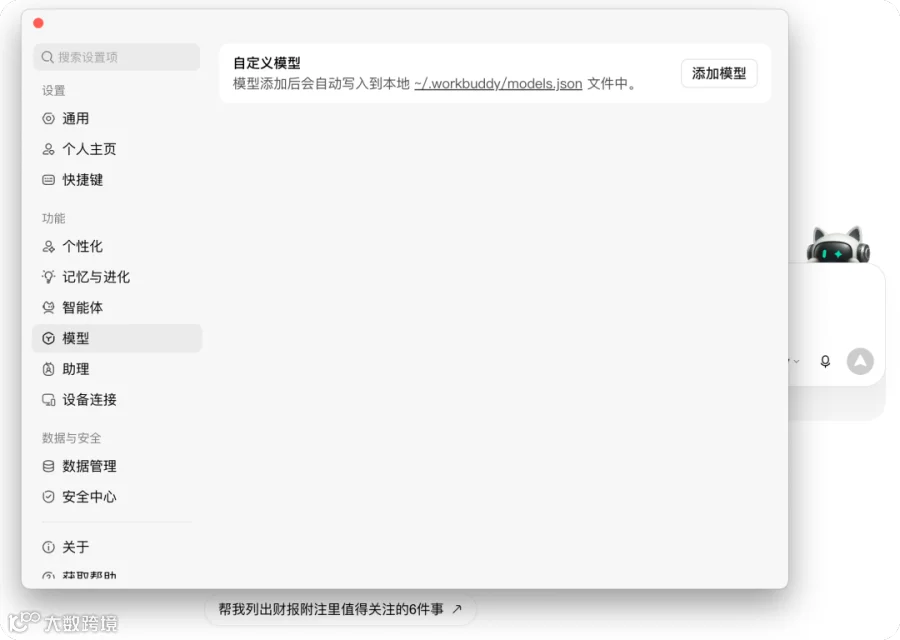
除了独立的本地部署,该电脑与 WorkBuddy 软件的配合尤为亮眼。相比 MacBook Air 上仅支持自定义模型的 WorkBuddy,Windows 版新增了 Beta 功能,允许用户直接下载并管理本地 AI 模型。
用户只需点击下载,系统即可自动完成模型部署规则配置。开启并常驻后台后,即可在 WorkBuddy任务界面直接调用该本地模型进行对话。

本地算力加速任务验证

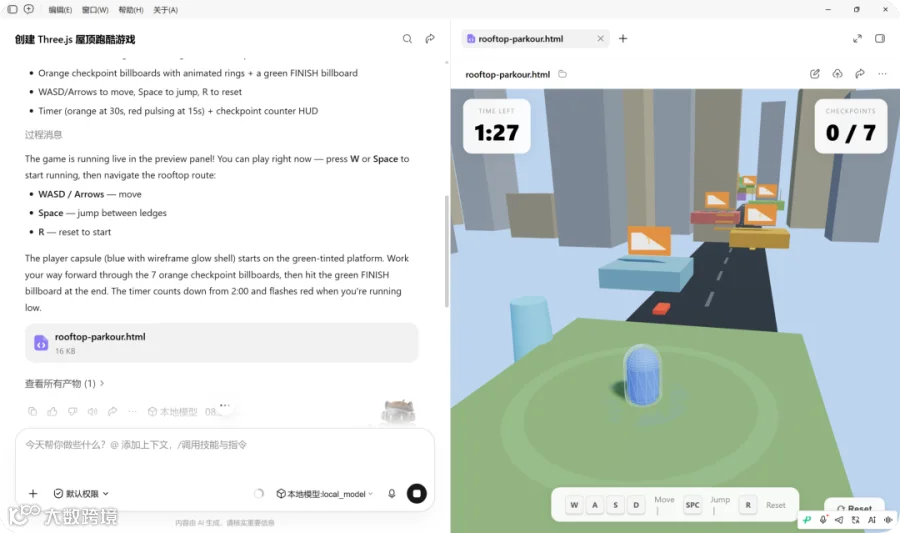
通过 WorkBuddy 调用本地模型执行 Three.js 屋顶游戏开发任务,虽然效果略逊于顶尖云端模型,但足以用于初步可行性验证。整个任务耗时约 14 分钟,效率可观。期间任务管理器显示 GPU 利用率飙升至 100%,风扇噪音明显增加。
经识别,该内置本地模型为腾讯优化的 500 亿参数 MoE 模型,大小 16GB,基于 CUDA 13 加速,推理流畅。结合 WorkBuddy Harness 能力,其在数据分析、可视化及报告总结等办公场景中表现良好。
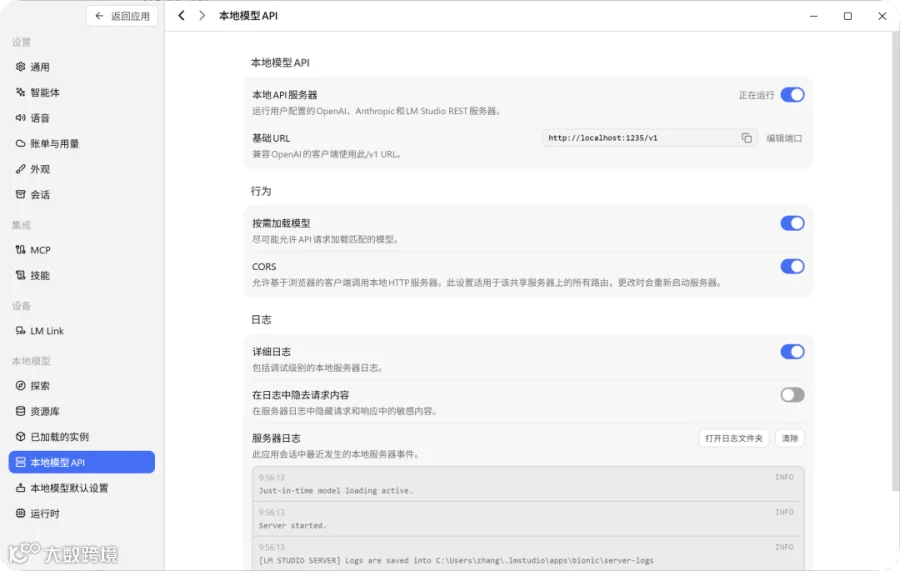
此外,用户也可通过 LM Studio 本地模型 API,将任意下载的本地模型加载至 WorkBuddy 或其他 Harness 工具(如 DeepSeek Harness)中使用,拓展性极强。

Windows 生态与开发体验持续进化

尽管本地 AI 体验日益简化,Windows 在开发环境兼容性上曾长期面临挑战。相较 Linux/macOS 原生的 Unix 工作流,Windows 过去在驱动、系统库及编译工具链上存在兼容痛点。
目前,Windows 正通过多项举措改善这一状况:推进 Microsoft Execution Containers (MXC) 项目,为 AI 智能体提供安全可控的运行环境;在 Windows ML 中引入 llama.cpp 支持,便于开发者调用开源模型;持续完善 WSL、Windows Terminal、WinGet 及 ARM64 原生开发工具链。
在日常体验方面,新版 Windows Search 支持直接执行系统操作,Copilot 也将在获授权后读取本地文件、执行系统命令或调用本地模型,进一步提升智能化水平。

结语:AI 是否构成换机理由?

英伟达成功将支持 CUDA 且能运行大型本地模型的计算平台压缩进不到 1.8kg 的笔记本中,打破了传统 AI 工作站对桌面环境和独立供电的依赖。用户可随时随地断开电源,继续运行 27B 模型。
然而,硬件能力的跃升并未完全解决软件易用性问题。尽管 WorkBuddy 等工具降低了部署门槛,但软件适配、模型能力平衡及性能续航取舍仍是影响体验的关键因素。
对于需频繁运行本地模型、开发 AI 应用或处理敏感数据的用户,华硕 ProArt 创16 RTX Spark 提供了极具价值的新选择。但对于仅使用云端 AI 工具的普通用户,暂无必要为此专门换机。
随着 AI 智能体深入日常工作,PC 的大内存、强算力和本地化处理能力将愈发重要。未来,部分计算任务将从云端回归本地,重塑个人电脑的价值定位。

【声明】内容源于网络
0
0
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
内容 15838
粉丝 0
APPSO AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
总阅读517.3k
粉丝0
内容15.8k