GPU减少HBM堆叠层数,并不意味着AI对内存的需求降低;供需缺口正转移至服务器机柜中其他关键组件。
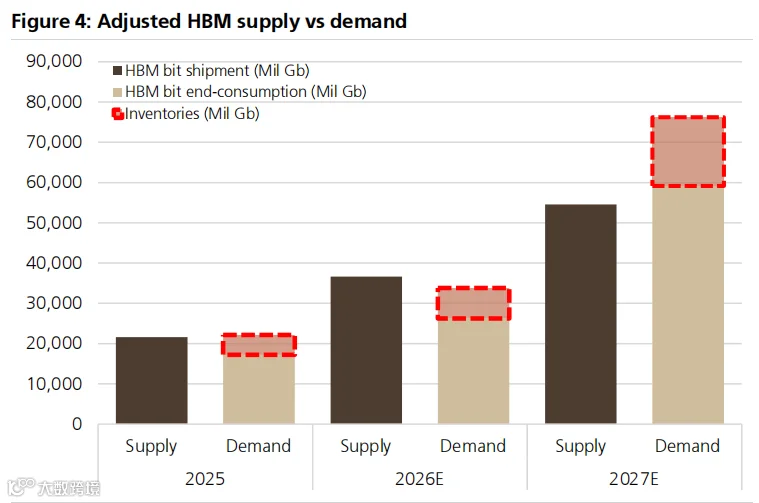
尽管HBM规格出现下调迹象,存储市场并未因此缓解压力。瑞银(UBS)10月模型显示,2027年HBM终端需求将从322亿Gb激增至615亿Gb,更大的增量体现在服务器DDR和SSD上。预计2026年至2027年,服务器DDR在DRAM bit需求中的占比将从37%升至48%,服务器SSD在NAND需求中的占比将从32%升至41%。单颗GPU HBM容量的缩减,反而促使整台服务器集成更多内存以维持性能。
HBM减层未改需求增长大势
据瑞银预测,NVIDIA下一代VR300将采用8层堆叠的HBM4,后续切换至HBM4E;Feynman架构可能采用8层或12层,部分面向推理的ASIC甚至仅配置4层。12层堆叠未成为唯一标准,主要受限于高带宽内存的晶圆供应、先进封装及验证产能。通过降低单颗GPU的HBM容量,有限的供给得以覆盖更多系统。
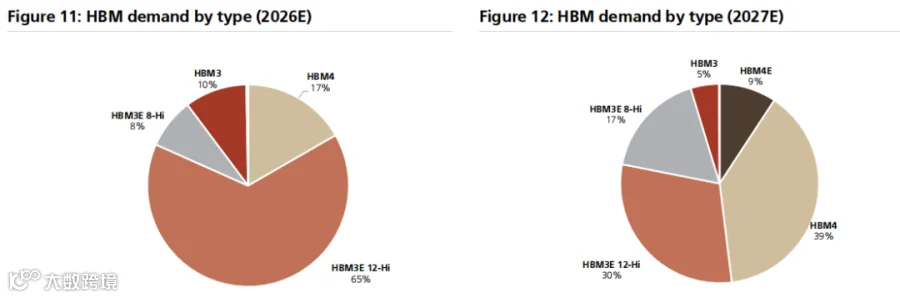
需求端依然强劲。瑞银预计2027年HBM总需求仍将增长91%。产品结构将从2026年由HBM3E 12层主导,转向由HBM4和HBM4E接棒。规格虽变,但AI集群对高带宽内存的需求并未缩减。
2027年HBM需求开始由HBM4接棒,容量压缩没有让总需求掉头
CPU与SSD承接转移的内存需求
推理型AI系统不仅依赖GPU内存。随着上下文长度增加和KV Cache变大,数据需在GPU、CPU内存和SSD间频繁调度。HBM密度下调后,NAND对KV Cache和NVIDIA CMX的需求反而上升。
CPU侧的变化更为显著。瑞银指出,NVIDIA为Vera CPU采购的SOCAMM,2027年订单预计超过500亿Gb,规模超过全部PC DRAM与GDDR之和。服务器平均DRAM容量预计从2026年的927GB提升至2027年的1,455GB;AI服务器则从8,961GB大幅升至14,754GB。AI正在将整台服务器转化为更大的内存机器。
AI服务器的单机DRAM容量在2027年继续陡升,DDR、HBM和SOCAMM一起扩容

存储成本上行传导至消费电子
服务器优先抢占晶圆和高规格颗粒,虽不直接导致消费电子销量下滑,但推高了物料成本。瑞银测算,到2027年,高端手机内存成本接近300美元,占整机BOM约35%;中低端手机内存成本接近200美元,占BOM超过50%。高端机型尚可依靠影像、芯片和服务维持溢价,而中低端机型在存储成本吞噬半数BOM后,必须在配置、售价和利润之间做出妥协。
PC市场面临类似处境。内存容量升级本是卖点,但在存储涨价背景下,这已转化为严峻的成本挑战。
存储价格上行后,中低端手机的内存成本将吞掉超过一半BOM

新增产能释放滞后,短缺短期难解
三星正加速DRAM扩产。瑞银预计,其DRAM月产能将从2026年四季度的70万片增至2027年四季度的82万片,但真正能改变供需平衡的大规模新增产能需待2028年以后。
长鑫存储的进展同样值得关注,但“宣布4F2”距离大规模供给仍有差距。瑞银判断,年内更可能是研发或样品节点,6F2 G5的制造爬坡将在2027年进行。数据显示,到2027年,长鑫晶圆产能或许占行业16%,但bit出货占比仅为9%。从产线建设、良率提升到制程代际和产品结构优化,中间仍需漫长过程。
新增晶圆产能不会立刻变成有效bit供给,长鑫的产能占比与出货占比仍有明显差距

结语:关注焦点应从HBM层数转向整体内存账单
HBM减配实质上是存储供应链的一次重新排队。先进DRAM需在HBM、服务器DDR5、SOCAMM之间分配,NAND则被KV Cache和企业级SSD拉入竞争战场。产能虽在增加,但无法立即转化为可交付的bit。
HBM的层数会变,但整机的内存成本账单不会自动缩小。