


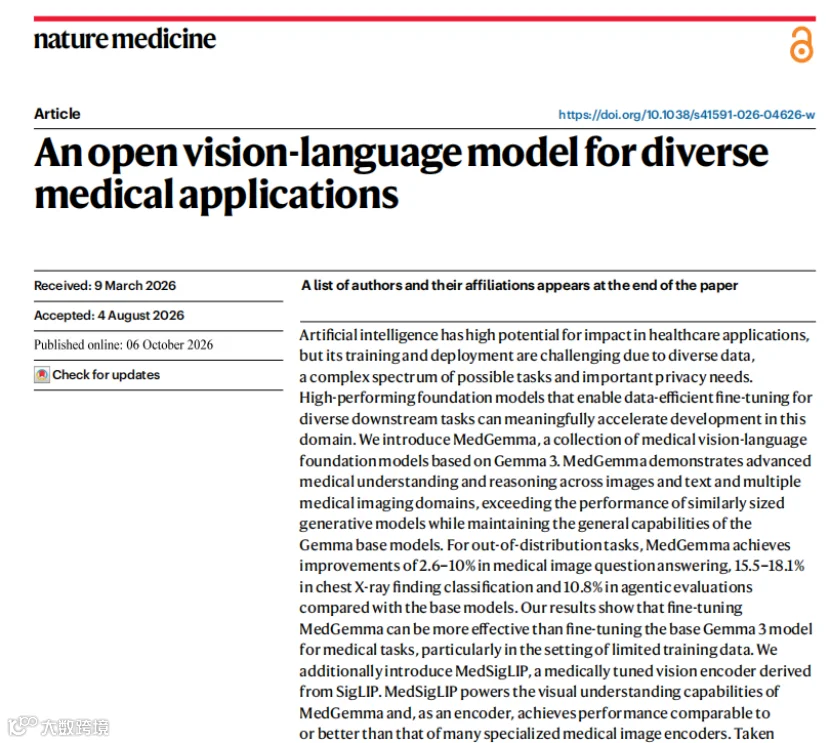
这篇研究面向现实痛点:现有医疗多模态大模型多为闭源,很难在有限标注数据条件下快速适配放射、病理、眼科等多样下游医学任务。作者发布MedGemma系列开源医学视觉语言基座模型,同时配套开源医学视觉编码器MedSigLIP;在多模态问答、胸片病灶分类、智能Agent任务等基准测试上,相比通用基座模型获得显著提升,小样本微调场景优势尤为突出。研究提供可开放复用的医学VLM底座,并非直接可落地的临床诊断产品。
论文信息
01 研究问题
通用大模型能认出“这是一张胸片”,却读不出“左侧大量液气胸伴引流管在位”。医学AI落地还同时受三重约束:数据来源极其多元(放射、皮肤、病理、眼科各有各的规范)、任务谱系庞杂(从分类到报告生成到智能体问诊)、以及严格的隐私与本地部署要求。此前的解法要么是训练彼此孤立的专科小模型,要么依赖闭源前沿模型。
因此这篇文章的研究对象不是一项诊断结论,而是一个基础模型。它的“结局”是微调之后的下游表现,而不是模型本身的某个分数。读的时候必须把“模型能力”和“临床效用”分开:前者靠基准分数,后者要靠流程和患者结局,而本文只完成了前一半。
02 研究方法
本研究语言主干基于Gemma3通用大模型,视觉分支为自研MedSigLIP,在SigLIP基础上完成医学数据调优,作为MedGemma的图像编码器,也可独立单独使用,对标各类专用医学图像编码器。研究采用大规模医学图文配对数据开展训练,数据来源覆盖放射影像、组织病理、皮肤镜、眼底影像、医学教科书、病例报告、医学文献等多元来源。整体训练流程分为跨模态预训练与多任务指令微调两个阶段,先对齐MedSigLIP视觉编码器与医学语言主干,建立医学图像与医学文本的跨模态映射,再围绕医学视觉问答VQA、图像描述生成、报告生成、病灶定位、图文检索等多样化任务开展指令微调,模型输出为文本形式回答,支持图像输入结合文本提问,兼容零样本、少样本、全量微调三种使用模式。评估层面同时设置域内基准与域外OOD基准,域内基准针对模型见过的同类医学图像任务,域外基准面向分布外、未见过的医学影像任务,以此检验模型的泛化迁移能力,基线选用原版Gemma3基座以及主流开源医疗VLM,同步覆盖全量微调与小样本微调两种设置,模拟真实科研场景标注不足的现状。
03 研究设计
模型家族包含MedGemma 4B(可接收文本、图像或两者)、MedGemma 27B,以及独立的MedSigLIP 400M编码器。主干沿用Gemma 3,视觉编码器是Gemma 3所用的400M SigLIP,在4B与27B之间共享。图像输入896×896,语言侧支持图文任意交错与128k上下文。
训练分三步。第一步视觉端医学化:微调Gemma 3所用的SigLIP-400M视觉编码器,为保留原有通用能力,医学数据只以2%权重混入原训练数据。第二步多模态解码器预训练:从Gemma 3检查点继续训练,医学图像数据以12%权重混入,约五个epoch,按验证集上的胸片报告生成与放射、皮肤、眼科视觉问答挑选检查点。本文把这两个比例写成约束条件而非结果:整份训练混合中医学数据总量分别被限制在2%与约12%,而不是让医学数据按原始体量自然进入。第三步后训练:蒸馏阶段加入医学文本,强化学习阶段使用配文医学图像。
一个明确的取舍值得记下来:作者发现多模态训练中强化学习比监督微调泛化更好,因此全部多模态后训练都用强化学习完成。报告生成要在预训练检查点之上继续优化的那一步,同样采用了基于强化学习的任务微调,而不是监督微调。
数据构成决定了它能做什么
四个模态是放射、病理、皮肤与眼科,但训练量级差得很远。按本文Extended Data Table 1,内部病理切片图文对约3,255万,而MIMIC-CXR约23.1万、EyePACS眼底约19.9万、CT二维层面约6.0万、内部皮肤科约5.1万、MRI二维层面约4.8万,最高与最低相差两个数量级以上。这种不均衡会直接带来模态偏置:体量最大的病理数据很容易压过其他模态。
本文没有让这些数据按自然体量进入训练,而是用一套迭代式经验采样策略确定混合权重:先按各数据集样本量等比初始化,跑一轮后看验证曲线,对已经过拟合的数据集按峰值性能对应的样本数降采样,对仍在改善的数据集把权重加倍,如此迭代,直到所有模态的验证指标在同一训练阶段同时见顶。本文同时写明多模态能力目前只覆盖二维图像,并把把放射能力扩展到CT与MRI三维序列、增加基因组等其他模态列为后续发展方向。想直接迁移到三维序列或全切片图像的课题,不能假设模型已经具备该能力。

图1 MedGemma 模型集合:MedSigLIP 编码器(4 亿参数)、MedGemma 4B 与 27B(多模态)及 MedGemma 27B Text(纯文本)
04 主要结果
域内与域外任务整体表现
研究分别在域内(训练数据分布内)和域外分布外(OOD)数据集开展评测,域外任务更贴近真实世界落地时遇到未知影像分布的场景,也是本研究重点观测指标。对比基线为同源未经过医学预训练的原始Gemma-3基座,同时纳入多款主流开源医疗视觉语言模型做横向对照。
在医学图像问答VQA任务上,覆盖放射、病理、眼底多模态图文问答,相较于原始Gemma-3基座整体性能提升2.6%-10.0%,域外数据集下增益会表现得更为突出。胸片病灶分类任务包含多种胸片异常病灶识别,相对基线提升幅度达到15.5%-18.1%,在域外胸片数据集上性能提升最为明显。针对模拟临床智能代理的医学Agent评估任务,模型可以完成图像解析、问题推理、答案输出的链式任务,相比基线提升10.8%。
同等参数量条件下,MedGemma整体性能优于多款开源医疗VLM。域内任务上MedGemma较原始Gemma3有稳定提升,但提升幅度有限;性能差距主要体现在域外分布外数据集上,证明医学领域预训练的核心价值在于提升对陌生医学影像的迁移泛化能力,而不只是拟合训练集中见过的数据。
小样本与全量微调的对比结果
研究设置全量标注、少样本也就是每类仅配置少量标注样本两种微调方案,模拟临床科研中标签稀缺的现实处境。在全量标注数据充足的条件下,MedGemma相比原始Gemma-3存在性能优势,但差距可控;当标注样本数量受限进入小样本场景时,原始Gemma-3微调后性能出现明显跌落,而MedGemma依旧可以维持较高水平,相比直接微调通用基座,部分域外任务F1值可高出12%以上。该结果证实经过医学预训练的基座能够显著降低下游任务对标注样本数量的依赖,对于医学标注稀缺的科研项目具备很高实用价值。
独立视觉编码器MedSigLIP的结果
MedSigLIP作为配套开发的医学图像编码器,不依赖MedGemma语言模块,可单独用于影像特征提取、分类、检索任务。在公开医学影像基准测试集中,MedSigLIP的图像表征能力达到或超过多款已发表的专用医学图像编码器;在跨模态检索任务中,医学图像文本匹配召回率显著高于原版SigLIP。即便不使用整套VLM,仅复用该视觉编码器,也能够为下游影像分析任务带来收益。
基座通用能力保留测试
为验证医学领域训练不会“遗忘”原有通用能力,研究使用通用图文、常识问答基准做对照测试。结果显示MedGemma在通用任务上仅有小幅性能回落,并未出现灾难性遗忘,在处理普通图片、通用文本提问时依旧保持可用,兼顾医学专项能力与基础通用能力。
05 学习借鉴
第一,把基础模型拆成可分别评测的两端。MedSigLIP单独作为编码器做零样本与线性探针评测,与MedGemma整体评测分开报告。这样“视觉端够不够好”和“语言端会不会用”成为两个可追问的问题,而不是一个笼统的模型分数。
第二,明确标注哪些数据集属于分布外。本文在评测表里逐一标记CXR14、CheXpert、MedXpertQA、AgentClinic-MIMIC-IV、SIIM-ACR与CRC100k为分布外。先看它是不是分布外,再决定这个分数能不能当作泛化能力的证据,这一步能避免大多数误读。
第三,把微调有没有用设计成数据量曲线,而不是一个分数。三个分类任务都用全部数据与10%类别均衡子集各跑一遍,报告balanced accuracy与自助法置信区间。这样回答的是我们数据少的时候还值不值得上医学底座,而不是微调后能到多少分。
第四,主动报告代价与不占优的结果。本文写明部分基准已接近饱和、公开基准反复使用存在测试数据泄漏可能;在Discussion中主动指出病理等方向专用模型仍然更强;通用能力的下降幅度很小(数值见Extended Data Table 4)。把不占优的结果写进正文,比只展示涨幅更可信。
06 专科迁移
数字病理:从切片分类切入。本文在CRC100k上做了100%与10%两种数据条件,并在该模态上取得最明显的微调收益(曲线见Extended Data Fig.2)。可先做patch级分类与分级,再考虑切片级聚合;注意原文的病理任务单元是独立patch(Extended Data Fig.2图注写明研究单元为individual image or tissue patch)。
皮肤科:先做闭源基线。该模态竞争激烈,Gemini 2.5 Flash/Pro在本论文的多选题上反而更高。选题阶段就应把闭源模型纳入对照,再决定是否值得自建。
眼科与眼底:适合样本有限的课题。EyePACS上4B达到64.9,同尺寸基线仅14.4;27B多模态版本进一步到75.3。本文同时把MedSigLIP作为可独立使用的编码器提供,适合在样本有限的筛查与分级课题中先做线性探针。
放射报告生成:瓶颈常在评估而非模型。预训练检查点29.5,强化学习微调后30.3,增量0.8;该指标对报告风格极敏感,本文为此区分了预训练与微调两个阶段,并提示跨研究分数不可直接比较。这类课题应先把评估口径和风格对齐做扎实。
内科与电子病历:先建可自动判分的问答集。本文在EHRQA(合成纵向门诊病历)上做强化学习微调,明确报告增益集中在需要跨记录推理的问题类别。可迁移的是这条路径:先构建可自动判分的电子病历问答集,再判断是否值得微调,并注意真实数据中病程记录与结构化字段的差异。
我们真正可以带走的,是一套判断顺序:先明确是“买能力”还是“买可控”,再用分布外与同尺寸基线验证底座是否真的更强,然后用自己的数据量算出微调收益,最后才谈流程与结局。开源底座只是工具,它的价值必须由你的数据量和任务难度来定价。
原文与复现入口
[1] Sellergren, A., Kazemzadeh, S., Mahvar, F. et al. An open vision-language model for diverse medical applications. Nat Med (2026). https://doi.org/10.1038/s41591-026-04626-w
参与瓴智医工协作:
希望发挥专业能力、参与项目协作,可通过「医工中心—入驻申请」提交专业背景与合作意向。
有科研问题、需要技术支持,可通过「业务合作—发布需求」描述研究目标与现有基础。
提交后由团队联系沟通。入驻申请不代表审核通过或保证获得项目。
编辑:杨梦洁
审核:吴朝
Nature Communications(一区,IF=15.7)CBSI 扩散生成框架:基于无造影 MRI 无创识别胶质瘤血脑屏障状态
Cancer Cell(一区|IF=56.1)基于知识增强的视觉-语言病理基础模型预训练,用于癌症诊断
Nature Medicine(一区 IF=52.5)基于生成式 AI 的低剂量数字减影血管造影降低术中辐射剂量的随机对照研究
npj Digital Medicine(IF=18.0)丨广东省人民医院眼科联合中山大学等多家单位开发PubChat,实现可溯源的多语言生物医学文献智能检索